Apariencia
📙 Clase 5 — Fundamentos de arquitectura de microservicios
Python para Backend · 2026-08-18 · Carpeta:
02-Ejercicios/Clase-05⬅️ Volver al índice de clases
🎯 Qué aprenderás en esta clase
- Monolito vs microservicios (ventajas, desventajas, cuándo conviene cada uno)
- Domain Driven Design (DDD) básico
- Bounded Contexts
- Principios de desacoplamiento
- Database per Service
- Comunicación entre microservicios: síncrona (gRPC) vs asíncrona (eventos, Kafka)
- Seguridad en microservicios: OAuth 2.0, JWT, mTLS
- Diseño del proyecto final
💡 Los dos últimos temas (comunicación async y seguridad) se ven aquí a nivel de mapa — Clase 7 profundiza en API Gateway Pattern, JWT, login y roles, y Clase 9 en arquitecturas Event Driven con SQS/SNS.
🗂️ Índice de esta clase
📖 Parte teórica
- Definiciones clave
- Monolito vs microservicios: ventajas y desventajas
- Domain-Driven Design (DDD) y Bounded Contexts
- Panorama general: dónde vive cada pieza
- Comunicación entre microservicios: síncrona vs asíncrona
- Seguridad en microservicios: autenticación y autorización
- Diseño del proyecto final: OrderFlow
💻 Parte práctica
- Construir un primer microservicio con FastAPI
- Mismo microservicio, otro stack: products en Flask
- Laboratorio: reconocer el antipatrón de Bounded Context
- Un paso intermedio: separar responsabilidades en clases
- De diccionario a Entity: InventoryItem protege su propio invariante
- Separación física: sacar notifications a su propio proceso
🏋️ Ejercicios y autoevaluación
- Ejercicios con solución — 10 de 10 listos
- Preguntas y respuestas (pendiente)
📖 PARTE TEÓRICA
📚 1. Definiciones clave
Arquitectura general
| Término | Qué es | Se profundiza en |
|---|---|---|
| Monolito | Aplicación única donde toda la lógica (UI, negocio, acceso a datos) corre en el mismo proceso y se despliega como una sola unidad. | sección 2 |
| Microservicio | Servicio pequeño e independiente, con una responsabilidad de negocio acotada, que se despliega y escala por separado del resto. | sección 2 |
| Arquitectura en capas | Organiza el código de un servicio en capas (presentación, negocio, datos) que solo se hablan con la capa de al lado. | sección 2 |
| Arquitectura hexagonal / Clean Architecture | El negocio queda en el centro, aislado de la base de datos, el framework web y APIs externas, conectado por "puertos" reemplazables. | sección 2 |
| SOA (Service-Oriented Architecture) | Antecesor de microservicios: servicios compartidos entre sistemas grandes de una organización, típicamente vía un middleware central (Enterprise Service Bus). | sección 2 |
| API Gateway | Punto único de entrada que recibe las peticiones del cliente y las enruta al microservicio correspondiente. | sección 4 |
| Database per Service | Patrón donde cada microservicio tiene su propia base de datos, que solo él puede leer/escribir directamente. | sección 4 |
| Consistencia operativa vs analítica | Operativa: necesita estar al día en segundos (¿hay stock ahora?). Analítica: puede esperar horas (¿cuánto vendimos este mes?) — cada una pide una estrategia distinta. | sección 4 |
| ETL / Data Warehouse | Proceso que extrae datos de varias fuentes (Extract), los transforma y los junta (Transform) en una base separada de reportería (Load) — típicamente corrido por lotes (p. ej. un job nocturno). | sección 4 |
Domain-Driven Design (DDD)
| Término | Qué es | Se profundiza en |
|---|---|---|
| Lenguaje ubicuo (ubiquitous language) | Vocabulario compartido entre negocio y desarrollo — los mismos términos que usa alguien de negocio aparecen tal cual en el código. | sección 3 |
| Bounded Context | Límite dentro del cual un modelo y su lenguaje son consistentes — fuera de él, el mismo término puede significar otra cosa. | sección 3 |
| Anti-Corruption Layer (ACL) | Capa que traduce el modelo de un sistema externo al lenguaje propio del contexto, para que sus rarezas no se filtren adentro. | sección 3 |
| Evento de dominio | Algo que ya ocurrió en el negocio y que le puede interesar a otros contextos (p. ej. order.created / OrderPlaced). | sección 3 |
| Invariante | Condición que el dominio nunca puede violar, sin importar qué parte del código lo toque (p. ej. "un pedido no puede tener total negativo"). | sección 3 |
| Modelo de dominio rico (rich domain model) | Objeto que agrupa datos y comportamiento juntos — sus propios métodos protegen sus invariantes, no depende de que quien lo use sea disciplinado. | Parte Práctica |
| Modelo anémico (anemic domain model) | Anti-pattern: clase que solo guarda datos (getters/setters) mientras toda la lógica vive afuera, en services que la manipulan sin protección. | Parte Práctica |
Comunicación entre microservicios
| Término | Qué es | Se profundiza en |
|---|---|---|
| Comunicación síncrona | El que llama espera la respuesta antes de seguir (p. ej. REST, gRPC) — acopla en el tiempo a ambos servicios. | sección 5 |
| Comunicación asíncrona | El emisor no espera respuesta inmediata; el receptor procesa el mensaje cuando puede — desacopla en el tiempo a ambos servicios. | sección 5 |
| gRPC | Framework RPC de Google sobre HTTP/2 que serializa con Protocol Buffers — más rápido y compacto que REST/JSON; típico para llamadas internas entre microservicios. | sección 5 |
| Protocol Buffers (protobuf) | Formato binario de serialización que usa gRPC en vez de JSON — el contrato del mensaje se define en un archivo .proto. | sección 5 |
| Message broker | Componente intermedio que recibe mensajes/eventos de un productor y los entrega a uno o más consumidores (p. ej. Kafka, RabbitMQ, Amazon SQS/SNS). | sección 5 |
| Kafka | Plataforma de streaming de eventos distribuida: los productores publican mensajes en un topic y los consumidores se suscriben a él, cada uno a su propio ritmo. | sección 5 |
| Evento | Mensaje que describe algo que ya ocurrió (p. ej. order.created) — se publica una vez y puede tener cero, uno o varios consumidores. | sección 5 |
| Topic | Canal con nombre dentro de un message broker donde se publican y desde donde se consumen eventos de un mismo tipo. | sección 5 |
| Productor / Consumidor | Quien publica un mensaje en un broker (productor) y quien lo procesa al recibirlo (consumidor). | sección 5 |
| Acoplamiento temporal | Dependencia de que emisor y receptor estén disponibles al mismo tiempo — la comunicación síncrona lo tiene, la asíncrona lo evita. | sección 5 |
| Coreografía (choreography) | Coordinar varios servicios sin un coordinador central — cada uno reacciona a eventos por su cuenta. | sección 5 |
| Orquestación (orchestration) | Coordinar varios servicios con un coordinador explícito que llama cada paso y sus compensaciones si algo falla. | sección 5 |
Seguridad
| Término | Qué es | Se profundiza en |
|---|---|---|
| OAuth 2.0 | Protocolo de autorización: permite que una app obtenga un token de acceso con permisos limitados, sin manejar la contraseña del usuario. | sección 6 |
| JWT (JSON Web Token) | Token firmado que lleva codificada la identidad y los permisos de quien lo presenta — el receptor lo valida sin tener que consultar una base de datos. | sección 6 |
| mTLS (mutual TLS) | Variante de TLS donde cliente y servidor se autentican mutuamente con certificados — asegura el tráfico interno entre microservicios. | sección 6 |
| Client Credentials (grant) | Flujo de OAuth 2.0 pensado para comunicación servicio-a-servicio, sin que haya un usuario humano de por medio. | sección 6 |
🆚 2. Monolito vs microservicios: ventajas y desventajas
No hay una arquitectura "mejor" en abstracto — cada una resuelve mejor un tipo de problema. La tabla compara los mismos aspectos en ambos modelos:
| Aspecto | 🏛️ Monolito | 🧩 Microservicios |
|---|---|---|
| Despliegue | Un solo artefacto — simple al principio, pero cualquier cambio chico exige redesplegar todo. | Cada servicio se despliega solo — cambios más chicos y frecuentes, sin tocar el resto. |
| Escalabilidad | Escala la aplicación completa, aunque solo un módulo la necesite. | Escala por servicio — solo el que tiene más carga (p. ej. orders en Black Friday). |
| Complejidad operativa | Baja al inicio: un solo proceso, un solo log, un solo deploy. | Alta: múltiples servicios, redes, colas, logs distribuidos — necesita más DevOps/observabilidad. |
| Acoplamiento | Alto: todos los módulos comparten memoria, código y (normalmente) una sola base de datos. | Bajo: cada servicio tiene su propio código y su propia base de datos (Database per Service). |
| Tecnología | Una sola stack para todo el proyecto. | Cada servicio puede usar el lenguaje/framework que más le convenga. |
| Testing | Más simple: todo corre en el mismo proceso, sin red de por medio. | Más difícil: hay que probar contratos entre servicios, no solo funciones internas. |
| Transacciones | Fáciles: una transacción de base de datos cubre todo. | Difíciles: una operación que toca varios servicios necesita consistencia eventual (eventos, sagas), no un COMMIT único. |
| Curva de aprendizaje / equipo chico | Baja — un equipo chico puede avanzar rápido sin pensar en infraestructura distribuida. | Alta — recién se justifica con equipos grandes que necesitan trabajar en paralelo sin pisarse. |
| Punto único de falla | Si el proceso se cae, se cae toda la aplicación. | Un servicio caído no tumba a los demás (si el resto está bien diseñado — círculo cerrado, retries, circuit breakers). |
💡 Regla práctica: si el equipo es chico, el dominio no está bien entendido todavía, o el producto recién está validando su mercado — un monolito (bien organizado en capas, como en Clase 4) suele ser la opción correcta. Microservicios resuelven un problema organizacional (equipos grandes, despliegues independientes) tanto como uno técnico — adoptarlos sin ese problema solo suma complejidad operativa gratis.
🧪 Tip de entrevista: "¿siempre conviene microservicios?" es una pregunta trampa — la respuesta correcta reconoce el trade-off (tabla de arriba), no repite que "microservicios es lo moderno". Mencionar el monolito modular (un monolito bien separado en capas/módulos, listo para partirse en microservicios el día que haga falta) muestra que entendés que es una decisión de costo/beneficio, no una moda.
🔍 Profundizar (opcional): cuánto pesa cada arquitectura en RAM — ejemplo con un sistema de telemedicina
🩺 Ejemplo práctico: consumo de recursos, con un sistema de telemedicina
La tabla de arriba compara conceptos; para que la "complejidad operativa" se sienta concreta, conviene verla en números — aunque sean aproximados. Supongamos un sistema de telemedicina hecho en FastAPI, con cinco dominios: usuarios, citas, teleecg (procesamiento de electrocardiogramas), reportes y notificaciones.
Como monolito, es una sola aplicación FastAPI con esos cinco módulos adentro, corriendo en un proceso (o varios workers del mismo proceso):
app/
├── main.py
├── usuarios/
├── citas/
├── teleecg/
├── reportes/
└── notificaciones/
bash
uvicorn app.main:app --host 0.0.0.0 --port 8000| Componente | RAM aprox. |
|---|---|
| FastAPI (los 5 módulos, un proceso) | 150 MB |
| PostgreSQL | 300 MB |
| Nginx | 50 MB |
| Total | ≈ 500 MB |
Separado en microservicios, cada dominio pasa a ser su propia app FastAPI, con su propio proceso y su propio puerto:
bash
uvicorn usuarios.main:app       --port 8001
uvicorn citas.main:app          --port 8002
uvicorn teleecg.main:app        --port 8003
uvicorn reportes.main:app       --port 8004
uvicorn notificaciones.main:app --port 8005| Componente | RAM aprox. |
|---|---|
usuarios-service | 120 MB |
citas-service | 140 MB |
teleecg-service (procesa archivos — pesa más) | 250 MB |
reportes-service | 180 MB |
notificaciones-service | 110 MB |
| Subtotal (5 procesos FastAPI) | ≈ 800 MB |
Y ahí no termina: separar en microservicios normalmente suma piezas de infraestructura que el monolito no necesitaba — un API Gateway, un message broker para eventos (sección 5), caché, observabilidad:
| Componente | RAM aprox. |
|---|---|
| Microservicios FastAPI (los 5 de arriba) | 800 MB |
| PostgreSQL | 300 MB |
| Redis (caché) | 80 MB |
| RabbitMQ (broker de eventos) | 200 MB |
| Nginx / API Gateway | 50 MB |
| Prometheus (métricas) | 200 MB |
| Grafana (dashboards) | 200 MB |
| Total | ≈ 1.8 GB |
📝 Los números son ilustrativos — el consumo real depende de las librerías, la cantidad de workers, la carga y qué tan pesado sea el procesamiento de cada servicio. Lo que importa es la forma de la curva (monolito ≈ 500 MB → microservicios ≈ 1.8 GB para el mismo negocio), no el valor exacto.
Por qué Python/FastAPI pesa menos que el equivalente en Java: la cadena de capas que carga cada proceso es más corta:
Java + Spring Boot          Python + FastAPI
─────────────────           ─────────────────
Servicio                    Servicio
└── JVM                     └── Python
    └── Spring Boot             └── FastAPI
        └── Hibernate               └── Aplicación
            └── Aplicación
Por eso levantar diez microservicios FastAPI suele consumir menos RAM base que levantar diez aplicaciones Spring Boot equivalentes — pero sigue habiendo overhead, solo que más chico.
El problema que sí es propio de Python: los workers. Como un solo proceso de Python no aprovecha varios núcleos de CPU a la vez (por el Global Interpreter Lock), para usar 4 cores hay que levantar 4 procesos worker del mismo servicio:
bash
gunicorn app.main:app -k uvicorn.workers.UvicornWorker -w 4Si eso se multiplica por cada microservicio, el número de procesos crece rápido:
5 microservicios × 4 workers cada uno = 20 procesos de Python corriendo a la vez20 procesos Python significan 20 asignaciones de memoria base, no una — ahí es donde el consumo de RAM realmente se dispara, más que por el framework en sí.
Entonces, ¿hace falta toda esa infraestructura? Un servidor local con 4 cores y 8 GB de RAM sí puede correr los 5 servicios + Nginx + Redis + RabbitMQ + PostgreSQL + Prometheus + Grafana en Docker — técnicamente funciona. Pero si el equipo tiene 3 desarrolladores y el sistema atiende 500 usuarios por día, vale la pena preguntarse si esa complejidad está resolviendo un problema real todavía. Un punto de partida más razonable para ese tamaño de equipo es el monolito modular de la sección 2:
                 Nginx
                   │
                   ▼
            ┌─────────────┐
            │   FastAPI   │
            │  usuarios   │
            │  citas      │
            │  teleecg    │
            │  reportes   │
            │  notific.   │
            └──────┬──────┘
                   │
                   ▼
              PostgreSQL
Y recién cuando un módulo puntual se vuelve el cuello de botella (p. ej. teleecg, que procesa archivos y consume mucha más CPU que el resto), se extrae ese módulo a su propio servicio — quedando una arquitectura híbrida, no todo separado de golpe:
                  Nginx
                    │
          ┌─────────┴─────────┐
          ▼                   ▼
     FastAPI Core        TeleECG Service
     usuarios            (procesamiento
     citas                intensivo)
     reportes
          │                   │
          └─────────┬─────────┘
                     ▼
                 PostgreSQL
La progresión que conviene seguir es esta, no la inversa:
Monolito modular → medir consumo → identificar cuello de botella
                 → extraer ese módulo → microservicio

(y NO: proyecto nuevo → crear 15 microservicios de entrada)
💡 Que FastAPI tenga menos overhead de base que Java/Spring Boot ayuda, pero no elimina el costo operativo real de los microservicios: más procesos que supervisar, más conexiones de red entre servicios, más despliegues que coordinar y más puntos donde algo puede fallar. La ventaja de framework no reemplaza a la pregunta de la sección 2: ¿este problema es organizacional/técnico de verdad, o es complejidad que se está sumando sin necesidad?
🧭 La arquitectura es una decisión, no una moda — matriz por situación
La tabla de la sección 2 compara aspectos (despliegue, escalabilidad, testing...). Esta otra tabla ayuda a decidir desde el lado opuesto: dada tu situación actual (no la arquitectura que "suena mejor"), ¿qué te conviene hoy?
| Situación | Monolito | Microservicios |
|---|---|---|
| Producto nuevo / equipo pequeño | ✅ Recomendado | ⚠️ Riesgo innecesario |
| Dominio simple | ✅ Adecuado | ⚠️ Sobrediseño |
| Funcionalidades muy independientes | ⚠️ Dificulta la separación | ✅ Ideal |
| Escalamiento diferente por módulo | ⚠️ Limitado | ✅ Ventaja clave |
| Varios equipos autónomos | ⚠️ Genera conflictos | ✅ Diseño natural |
| Alta experiencia DevOps | — No necesario | ✅ Requisito |
Las primeras dos filas y las últimas cuatro no son casualidad: van de menos a más madurez organizacional necesaria. Un equipo chico con un dominio simple todavía no tiene el problema que los microservicios resuelven (coordinar equipos grandes, escalar módulos de forma dispareja); recién cuando aparecen esas condiciones, la balanza empieza a inclinarse del otro lado — y la última fila es la que más se subestima: sin experiencia operando contenedores, colas y observabilidad distribuida, microservicios suma trabajo sin sumar valor todavía.
🩺 Caso "OrderFlow": un sistema con tres módulos —
productosrecibe 20 000 consultas/min,usuariosrecibe 500/min,pedidosrecibe 2 000 op/min. Como monolito, escalar significa levantar más réplicas de todo el proceso — para cubrir el pico deproductosterminás corriendo diez copias completas deusuariosypedidosque no las necesitan, solo porque viven pegadas en el mismo proceso. Como microservicios, escalás soloproductos-service(fila "Escalamiento diferente por módulo" de la tabla) y dejás a los otros dos con pocas réplicas — mismo tráfico, muchos menos recursos desperdiciados. Es el mismo principio del recuadro plegado de arriba (RAM), visto ahora desde escalabilidad.
🗺️ Arquitecturas comunes: el paisaje completo
Monolito y microservicios no son las únicas dos opciones — son dos puntos en un mapa más grande. Vale la pena conocer el resto, porque varias de estas conviven con las que ya se vieron (de hecho, ya se usaron algunas sin nombrarlas):
| Arquitectura | Idea principal | Ejemplo | Dónde ya se vio |
|---|---|---|---|
| Monolítica | Todo el sistema corre como una sola aplicación | FastAPI + PostgreSQL | Esta sección, arriba |
| Monolito modular | Una aplicación, separada internamente por módulos | usuarios, citas, pagos | Esta sección, arriba |
| Microservicios | Cada módulo importante corre como servicio independiente | auth-service, citas-service | Toda la clase |
| En capas | Divide presentación, negocio y datos | Controller → Service → Repository | Clase 4 — routers/ → services/ → repositories/ |
| Hexagonal | El negocio queda aislado de BD, APIs y frameworks | dominio + puertos + adaptadores | Nueva — ver abajo |
| Clean Architecture | Las reglas de negocio están en el centro y no dependen de infraestructura | Entities → Use Cases → Adapters | Nueva — ver abajo |
| SOA | Servicios empresariales comparten funcionalidades | sistemas hospitalarios grandes | Nueva — ver abajo |
| Event-Driven | Los componentes se comunican mediante eventos | RabbitMQ, Kafka | Sección 5 |
| Serverless | Funciones ejecutadas bajo demanda | AWS Lambda | Nota de la sección 4 (EventBridge) — se profundiza en Clase 8 |
| Cliente-Servidor | Un cliente consume servicios de un servidor | React → FastAPI | Sección 4 (Frontend → API Gateway) |
Las tres que todavía no tenían nombre en esta clase:
- Arquitectura en capas — la que ya usaste en Clase 4 (
routers/→services/→repositories/→models/). Cada capa solo le habla a la de al lado; el router nunca toca la base de datos directo. Es la versión dentro de un solo servicio del mismo principio de desacoplamiento de la sección 4 (un servicio no conoce más de lo necesario) — aplicado a capas de código, no a servicios de red. - Arquitectura hexagonal (ports & adapters) y Clean Architecture son primas cercanas de la misma idea: el negocio (las reglas, lo que hace único al sistema) va en el centro, y todo lo externo —base de datos, framework web, APIs de terceros— se conecta por "puertos" reemplazables. La diferencia práctica es más de vocabulario que de fondo: Hexagonal habla de puertos y adaptadores; Clean Architecture nombra capas concéntricas (
Entities → Use Cases → Adapters → Frameworks). Las dos persiguen lo mismo que ya se vio con DDD (sección 3): que el modelo de negocio no dependa de detalles técnicos que cambian más seguido que las reglas del negocio. - SOA (Service-Oriented Architecture) es el antecesor histórico de microservicios — servicios compartidos entre varios sistemas grandes de una organización (el ejemplo clásico son los sistemas hospitalarios: un "servicio de pacientes" compartido por facturación, laboratorio y farmacia). La diferencia clave con microservicios: SOA típicamente pasa todo por un middleware central compartido (un Enterprise Service Bus), mientras que microservicios evita justamente eso — cada servicio se despliega y escala solo, sin depender de un bus central que se vuelva, otra vez, un punto único de acoplamiento.
💡 No son excluyentes entre sí.
OrderFlow(sección 7) es a la vez microservicios (varios servicios independientes) y, adentro de cada servicio, arquitectura en capas (como en Clase 4) — y podría perfectamente adoptar Hexagonal o Clean Architecture puertas adentro deOrder Servicesi su lógica de negocio se vuelve compleja. Elegir "microservicios" responde cómo se despliega; elegir "en capas" o "hexagonal" responde cómo se organiza el código adentro de cada pieza — son preguntas en ejes distintos, no alternativas una de la otra.
🧭 3. Domain-Driven Design (DDD) y Bounded Contexts
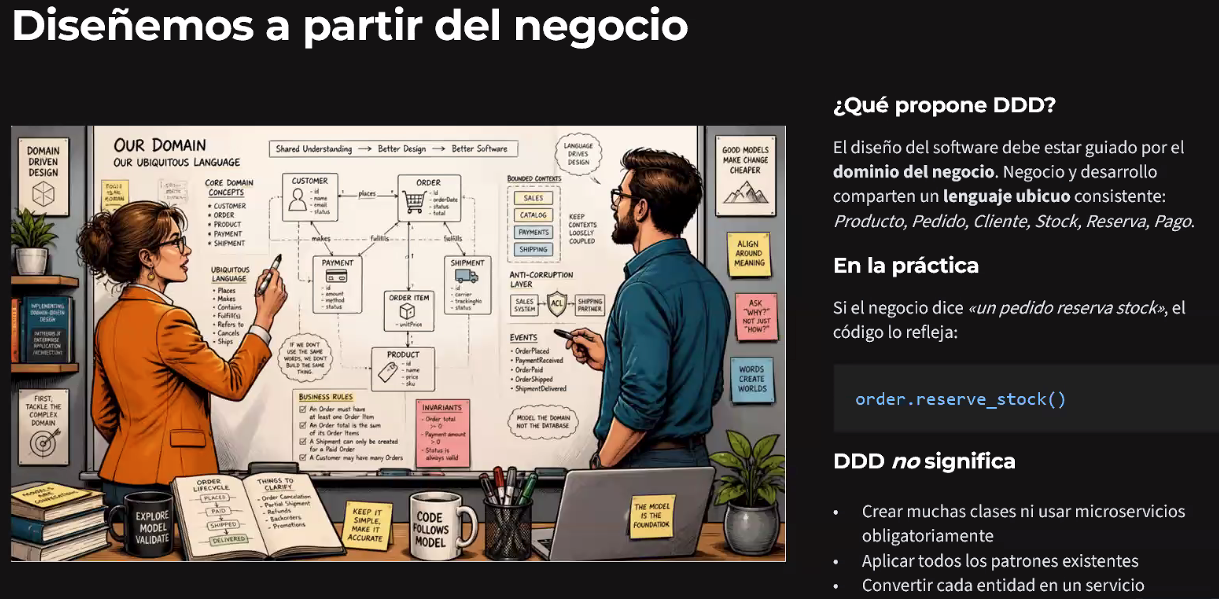
La sección 2 respondió cuándo separar en microservicios. Esta responde algo anterior y más importante: por dónde separar — porque partir un sistema por los límites equivocados da microservicios tan acoplados entre sí como un monolito, solo que ahora comunicándose por red en vez de por memoria.
La idea central de DDD es que el diseño del software debe estar guiado por el dominio del negocio, no por conveniencia técnica. Negocio y desarrollo comparten un lenguaje ubicuo (ubiquitous language): los mismos términos que usa alguien de negocio (Producto, Pedido, Cliente, Stock, Reserva, Pago) son los que aparecen en el código — no una traducción técnica aparte. Si negocio dice "un pedido reserva stock", el código lo refleja tal cual: order.reserve_stock(), no update_inventory_flag(order_id, -1).
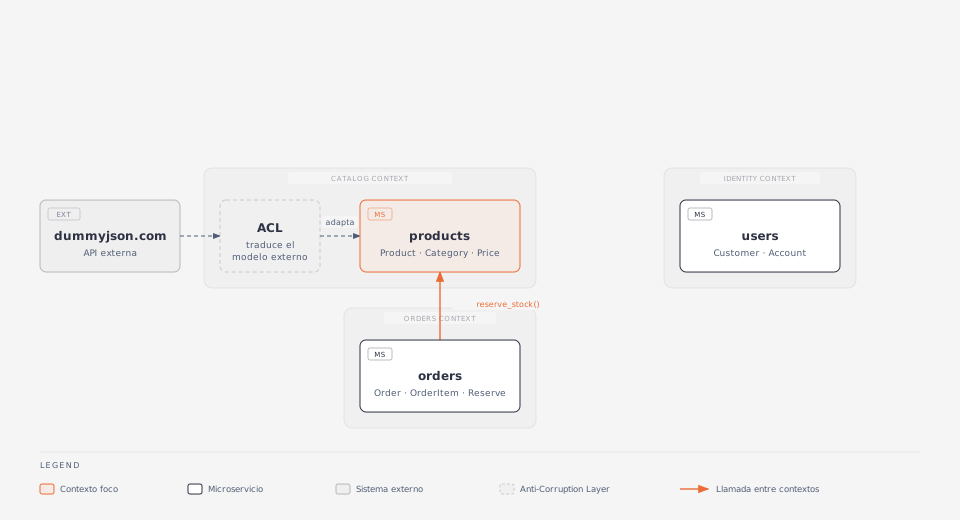
🗺️ Diagrama: Bounded Contexts y Anti-Corruption Layer
📎 Fuente editable en
04-Recursos/diagramas-tecnicos/clase-05-bounded-contexts/.
- Bounded Context — el límite dentro del cual un modelo y su lenguaje ubicuo son consistentes.
Productsignifica una cosa específica (nombre, descripción, precio, categoría) dentro del Catalog Context; siOrdersnecesita hablar de un producto, lo hace a través de la API deproducts— no reutiliza su tabla ni su clase directo. Es la misma regla de Database per Service (sección 4) pero un nivel más arriba: primero el límite de modelo, después el límite técnico de base de datos se deriva solo. En el diagrama, los tres contextos —Catalog(products),Orders(orders),Identity(users)— son justo los tres microservicios que ya venís viendo en toda la clase. - Anti-Corruption Layer (ACL) — la capa que traduce el modelo de un sistema externo al lenguaje propio del contexto, para que sus rarezas no se filtren adentro. No es teoría abstracta: ya construiste una. En la Parte Práctica,
products-service-flaskconsumedummyjson.com(que habla detitle/brandcon su propia forma) y lo transforma antes de responder — esa función que reforma el diccionario es el ACL. Sin ella, el modelo externo dedummyjson.comterminaría filtrado dentro del Catalog Context, y un cambio en esa API de terceros rompería tu dominio directo. - Evento de dominio — algo que ya pasó en el negocio y que a otros contextos les puede interesar. Ya usaste uno:
order.created(sección 5) es exactamente esto — el Orders Context avisa "se creó un pedido" sin saber ni importarle quién más lo escucha. Es común ver el mismo tipo de evento nombrado distinto según el equipo/convención:order.created(minúscula con punto, estilo topic) yOrderPlaced(PascalCase, estilo clase) describen la misma idea — elegí una convención por proyecto y sé consistente, no hay una "correcta" universal. - Invariantes y reglas de negocio — condiciones que el dominio nunca puede violar, vivan donde vivan en el código: un pedido no puede existir sin al menos un ítem, un envío no puede crearse para un pedido que todavía no fue pagado. Modelarlas explícito (en el propio objeto
Order, no dispersas en cada endpoint que lo toca) es lo que hace que "un pedido válido" signifique lo mismo en todo el Orders Context.
⚠️ DDD no significa:
- Crear muchas clases ni usar microservicios obligatoriamente.
- Aplicar todos los patrones existentes "porque sí".
- Convertir cada entidad en un servicio.
Un Bounded Context es un límite de modelo, no necesariamente un límite de despliegue — podés tener varios bounded contexts bien definidos adentro de un mismo monolito modular (sección 2) y recién separarlos en microservicios cuando aparezca una razón real para hacerlo (equipos distintos, escalamiento distinto). DDD ordena el diseño; microservicios es una decisión de despliegue aparte, no un paquete que vienen juntos.
🧪 Tip de entrevista: ¿en qué se diferencia un Bounded Context de un microservicio? Un Bounded Context es conceptual (dónde un modelo deja de ser válido y empieza otro); un microservicio es una decisión de infraestructura (un proceso, un despliegue, un repo). Un buen microservicio normalmente respeta los límites de un Bounded Context — pero un Bounded Context puede existir perfectamente sin ser todavía su propio servicio.
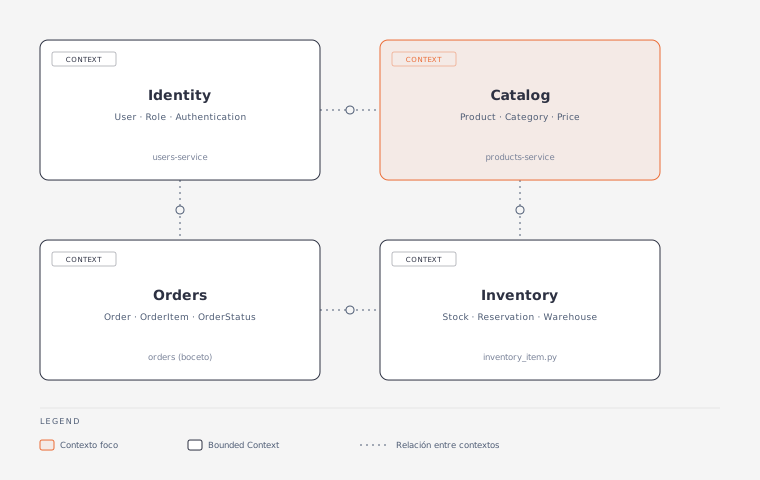
🗺️ Mapa completo: los 4 Bounded Contexts del sistema
El primer diagrama de esta sección simplificó a tres contextos para explicar el ACL. En realidad Inventory no es parte de Catalog — es su propio Bounded Context, separado, con su propio modelo:
📎 Fuente editable en
04-Recursos/diagramas-tecnicos/clase-05-mapa-bounded-contexts/.
Esto explica algo que ya se construyó sin decirlo explícito: products-service devuelve name/price/stock — pero el stock ya no debería vivir ahí. Es Inventory quien es dueño del stock (InventoryItem, con su sku y available_stock, más abajo en la Parte Práctica); Catalog solo debería conocer Product · Category · Price. Es la lección central de un Context Map:
💡 La misma palabra puede significar cosas distintas según el contexto — y eso está bien. "Producto" en
Cataloges nombre, descripción, precio, categoría (lo que un cliente ve en la vitrina); "Producto" enInventoryes SKU, stock disponible, stock reservado, almacén (lo que un operador de bodega necesita). No hacen falta compartir el mismo modelo — cada contexto define su propia representación de "producto", pensada para lo que a ESE contexto le importa. Intentar forzar un únicoProductgigante que sirva para las dos cosas es, otra vez, el error de diseño que ya se vio: un modelo que trata de ser todo para todos termina sin proteger bien ningún invariante.
🔓 Principio de desacoplamiento: un servicio debe conocer lo mínimo necesario
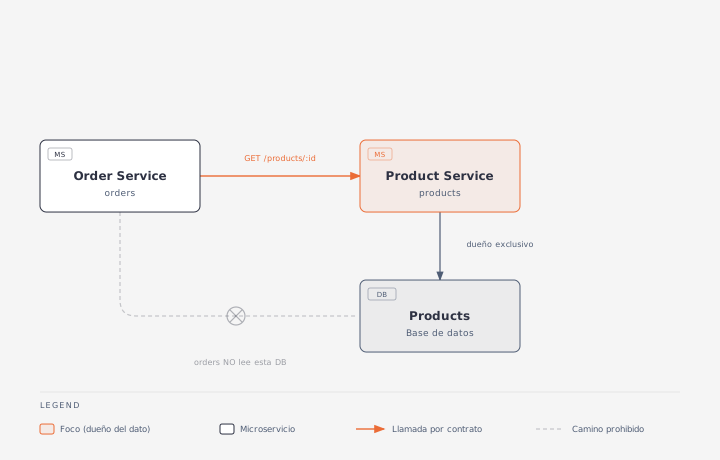
Todo lo anterior de esta sección —Bounded Context, ACL, evento de dominio— es la teoría detrás de una sola pregunta muy concreta: ¿cómo obtiene un servicio los datos que no son suyos? El camino recomendado, dibujado directo, con el camino prohibido tachado:
📎 Fuente editable en
04-Recursos/diagramas-tecnicos/clase-05-desacoplamiento-orders-products/.
| 🔴 Alto acoplamiento | 🟢 Bajo acoplamiento | |
|---|---|---|
| Acceso a datos | orders lee la base de datos de products directo (el camino tachado del diagrama) | orders llama a products-service por su API — GET /products/:id |
| De qué depende | Del esquema interno de otro servicio (sus columnas, sus tipos) | De un contrato/interfaz estable (su API pública) |
| Qué pasa si el otro cambia | Un ALTER TABLE en products puede romper orders sin avisar | Mientras la API no cambie su contrato, orders no se entera de nada interno |
| Autonomía real | Baja — los dos servicios están atados a un mismo esquema físico | Alta — cada uno puede migrar su base de datos, cambiar de motor, refactorizar, sin coordinar con el otro |
Product Service es el único dueño de Products — nadie más se conecta ahí directo (Database per Service, sección 4, visto ahora desde con quién sí se puede hablar —contrato— y con quién no —base de datos ajena—). Es exactamente el antipatrón que se corrige más abajo en la Parte Práctica: USERS[user_id] / PRODUCTS[product_id] (acceso directo) versus el boceto users_client.get(user_id) (llamada por API). Dicho memorable: un servicio no debería conocer más del otro que su contrato público.
🧪 Tip de entrevista: te preguntan "¿por qué no le doy acceso de lectura a la base de datos de otro servicio, es solo un
SELECT"? Porque es un acoplamiento silencioso: nadie lo ve en ningún contrato, ningún test lo cubre, y el día que el equipo dueño de esa tabla renombre una columna, tuSELECTse rompe en producción sin que ellos supieran que dependías de eso. La API es lenta de construir pero visible; el acceso directo es rápido pero invisible.
🅰️ 4. Panorama general: dónde vive cada pieza
Antes de entrar al detalle de cada componente, conviene ver el mapa completo: quién le habla a quién, y por dónde entra una petición desde que sale del cliente hasta que llega al microservicio correcto. El siguiente diagrama define esa arquitectura de referencia — un API Gateway como punto único de entrada, enrutando por path a tres microservicios independientes (users, orders, products), cada uno con el patrón Database per Service aplicado:
🗺️ Diagrama: arquitectura de microservicios
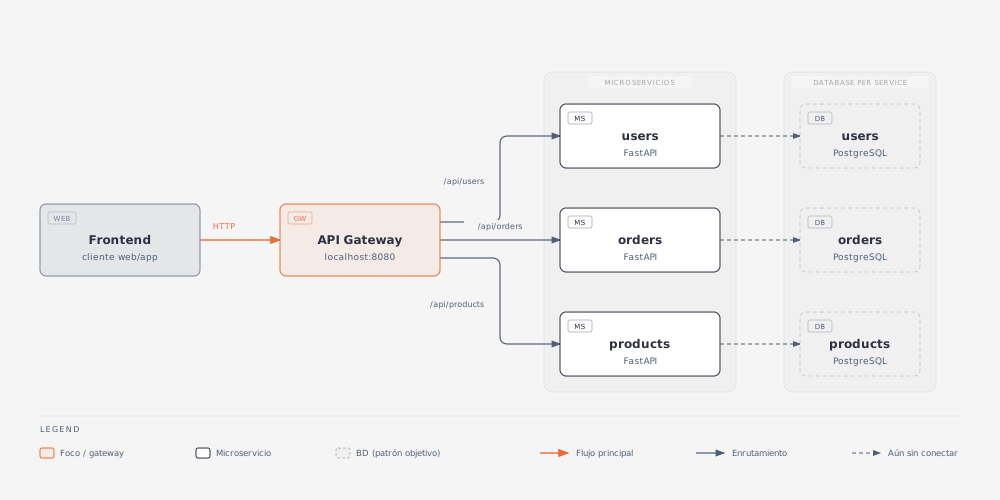
📎 Fuente editable y notas de regeneración en
04-Recursos/diagramas-tecnicos/clase-05-arquitectura-microservicios/.
- Frontend: lo que consume el usuario final (web/app). No habla directo con cada microservicio.
- API Gateway (
localhost:8080): punto único de entrada. Recibe la petición del frontend y la enruta por path al microservicio correspondiente — el frontend no necesita saber cuántos microservicios hay ni dónde vive cada uno. - Microservicios —
users,orders,products: tres servicios independientes, cada uno con su propia responsabilidad de negocio. Comparten la misma capa de la arquitectura, pero cada uno corre y se despliega por separado — la agrupación en el diagrama es solo conceptual, no significa que compartan proceso. - Database per Service (punteado en el diagrama porque todavía es el objetivo a desarrollar, no la base ya conectada): cada microservicio tiene su propia base de datos, que solo él puede leer/escribir directamente. Ningún otro microservicio le hace
JOINni le consulta la tabla de otro por fuera de su API — siordersnecesita datos deusers, se los pide ausers(por su API), no a su base de datos. Esto es lo que permite que cada equipo cambie su modelo de datos sin coordinar con los demás, a costa de tener que resolver la consistencia entre servicios de otra forma — eventos y llamadas síncronas, dos secciones más abajo (5), y bus de eventos vs consolidación nocturna en la subsección "Comparación de dos modelos de datos" de más arriba.
🧪 Tip de entrevista: ¿por qué el frontend no le pega directo a cada microservicio? Porque perdería el punto único de entrada: tendría que conocer la URL de cada servicio, manejar CORS con cada uno por separado, y no podría centralizar cosas como auth o rate limiting. Eso es justamente lo que resuelve el API Gateway Pattern (se profundiza en Clase 7).
🧪 Tip de entrevista: ¿por qué no una sola base de datos compartida por los tres microservicios (como en el monolito)? Porque un esquema compartido es un acoplamiento oculto: un cambio de columna en la tabla que usa
orderspuede romperuserssin que nadie lo note en el código. Database per Service cambia ese acoplamiento por contratos de API explícitos, que sí se versionan y se prueban.
💡 Esta es la idea central que diferencia un monolito de microservicios: en el monolito el frontend (o el cliente) habla con una sola aplicación que hace todo; acá habla con el API Gateway, que reparte el trabajo entre varios servicios chicos e independientes.
🗄️ Comparación de dos modelos de datos: base compartida vs Database per Service
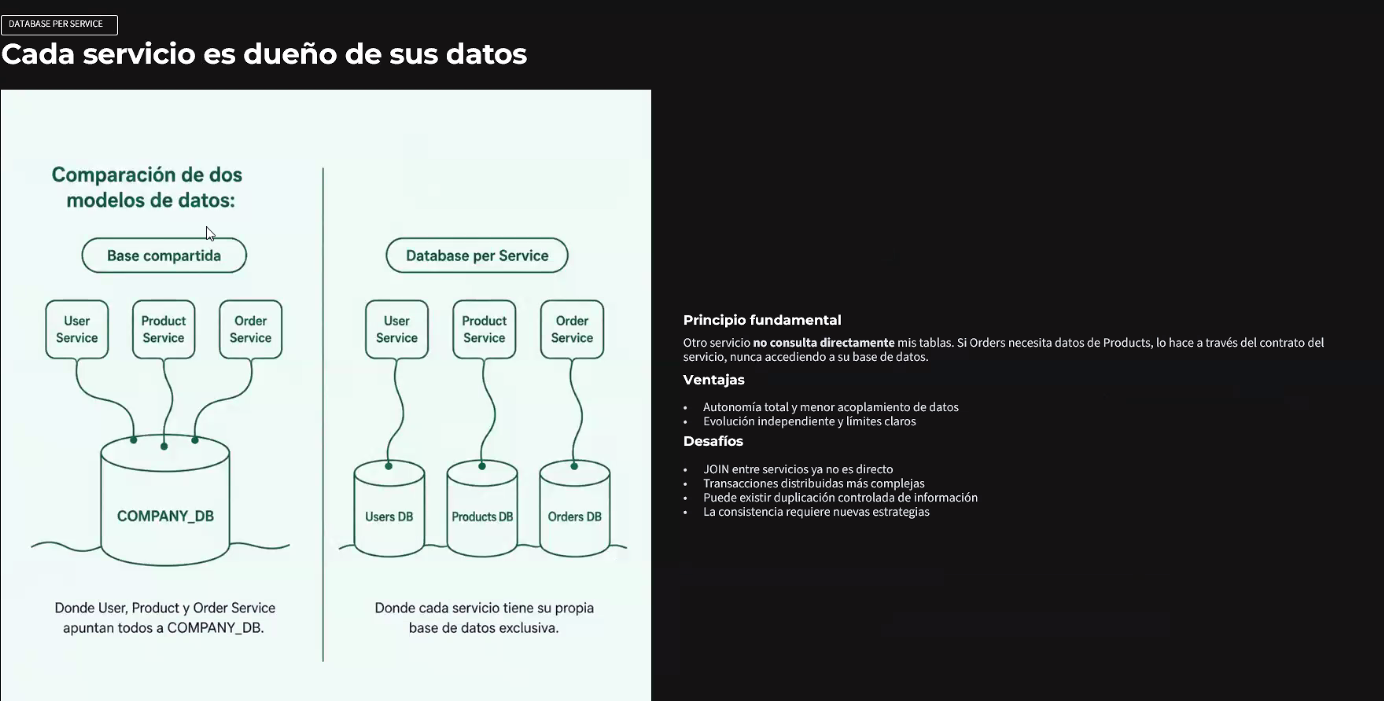
📎 Este diagrama pone en la misma imagen los dos modelos que ya se contrastaron en la tabla de la sección 2 (fila "Acoplamiento") — acá se ve el dibujo lado a lado.
El dato nuevo de este diagrama, que vale la pena remarcar: "Base compartida" (izquierda) no es un monolito — User Service, Product Service y Order Service son procesos separados, cada uno con su código — pero los tres apuntan a la misma COMPANY_DB. Es la peor combinación posible, no un término medio: toda la complejidad operativa de tener varios servicios (sección 2), sin ninguna de las ventajas de desacoplamiento que se supone que eso trae.
Desafíos de Database per Service — esta es la parte que no estaba tan desarrollada todavía (las ventajas —autonomía, evolución independiente— ya se vieron):
| Desafío | Qué significa en la práctica |
|---|---|
JOIN entre servicios ya no es directo | Si antes hacías SELECT ... FROM orders JOIN products, ahora necesitás dos llamadas (una a cada API) y juntar los datos vos mismo, en código. |
| Transacciones distribuidas más complejas | Un COMMIT ya no cubre "crear el pedido y descontar el stock" a la vez — si el segundo paso falla, no hay rollback automático del primero (ya se vio en la Parte Práctica, checklist punto 7). |
| Puede existir duplicación controlada de información | orders puede guardar una copia del nombre del producto al momento de la compra (para no depender de products en cada consulta futura) — es duplicación a propósito, no un error de diseño. |
| La consistencia requiere nuevas estrategias | Hay más de una estrategia válida, para más de un tipo de problema — ver las dos siguientes. |
Bus de eventos (event bus) es otro nombre para lo mismo que ya se vio como message broker en la sección 5 (Kafka, RabbitMQ, SQS/SNS) — un componente central por donde pasan los eventos de todos los servicios, para que cualquiera pueda enterarse de lo que pasó en otro sin consultarle su base de datos. Resuelve la consistencia operativa: en vez de una transacción única, orders publica order.created, y products/inventory reaccionan a ese evento cada uno por su cuenta (exactamente el diagrama de la sección 5) — la consistencia deja de ser inmediata (como en una sola base de datos) y pasa a ser eventual, pero se resuelve en segundos, no en horas.
📎 En AWS, este mismo bus de eventos tiene nombre propio: Amazon EventBridge — mismo rol que Kafka/RabbitMQ en este diagrama, distinta implementación (gestionada, serverless). Un ejemplo real (con la nomenclatura del material de AWS, no la de esta clase):
Basket Microservice—equivalente a nuestroOrder Serviceen el momento del checkout— termina el pedido → publica un evento en EventBridge →Ordering Microservice—el que persiste el pedido ya confirmado— lo consume vía una cola SQS, cada uno con su propia tabla DynamoDB. Mismo patrónorders/productsde esta clase, con otro proveedor y otros nombres de servicio. Clase 8 (Serverless AWS) y Clase 9 (Event Driven) lo desarrollan de punta a punta — acá alcanza con reconocer que es la misma idea con otro nombre.
Consolidación nocturna es la otra estrategia — más simple, y sirve para un problema distinto. Un job programado (un cron, corriendo de madrugada) junta Users DB + Products DB + Orders DB en una base de reportería (un Data Warehouse, poblado por un proceso ETL). Es mucho más barato de operar que un bus de eventos: no hace falta Kafka, ni manejar reintentos, ni pensar en idempotencia — un script que corre una vez por noche y listo.
⚠️ Pero resuelve solo la mitad del problema — la que puede esperar. Sirve perfecto para consistencia analítica: reportes, dashboards, "ventas del mes", nadie necesita esos números actualizados al segundo. No sirve para consistencia operativa: si a las 10am se venden las últimas 3 unidades de un producto dos veces (porque
ordersyproductsquedaron desincronizados durante el día), el job de la madrugada no evita el sobreventa — solo lo reporta horas después. Bus de eventos y consolidación nocturna no son alternativas entre sí, son complementarias: eventos para lo que el negocio necesita saber ya (¿hay stock? ¿se cobró?), consolidación nocturna para lo que el negocio puede saber mañana (¿cuánto vendimos este mes?).
⚠️ Nada de esto es gratis, y no siempre conviene. Adoptar Database per Service + bus de eventos depende de si la arquitectura, los recursos y la capacidad del equipo son suficientes para sostenerlo — el mismo punto de la sección 2 (regla práctica del monolito modular) y del checklist de la Parte Práctica. Un equipo chico que recién empieza a sentir el desafío de "transacciones distribuidas" probablemente todavía no necesita un bus de eventos — necesita revisar si de verdad hace falta partir esa base de datos. La pregunta no es "¿cómo resuelvo la consistencia distribuida?" sino primero "¿de verdad necesito distribuir esto todavía?".
🧪 Tip de entrevista: ¿por qué "duplicación controlada" no es un antipatrón acá, si toda la clase habló de evitar acoplamiento? Porque hay una diferencia entre duplicar datos (una copia local de algo que cambia poco, para no depender de otro servicio en cada lectura) y duplicar responsabilidad (dos servicios decidiendo lo mismo, o escribiendo la misma tabla). Lo primero es una técnica válida de desacoplamiento; lo segundo es el antipatrón de siempre.
📡 5. Comunicación entre microservicios: síncrona vs asíncrona
El diagrama anterior solo mostró la mitad del cuadro: cómo entra una petición desde afuera (frontend → API Gateway). Pero los microservicios también se hablan entre ellos, y ahí hay dos formas de hacerlo — con implicancias muy distintas.
🗺️ Diagrama: llamada síncrona (gRPC) vs evento asíncrono (Kafka)
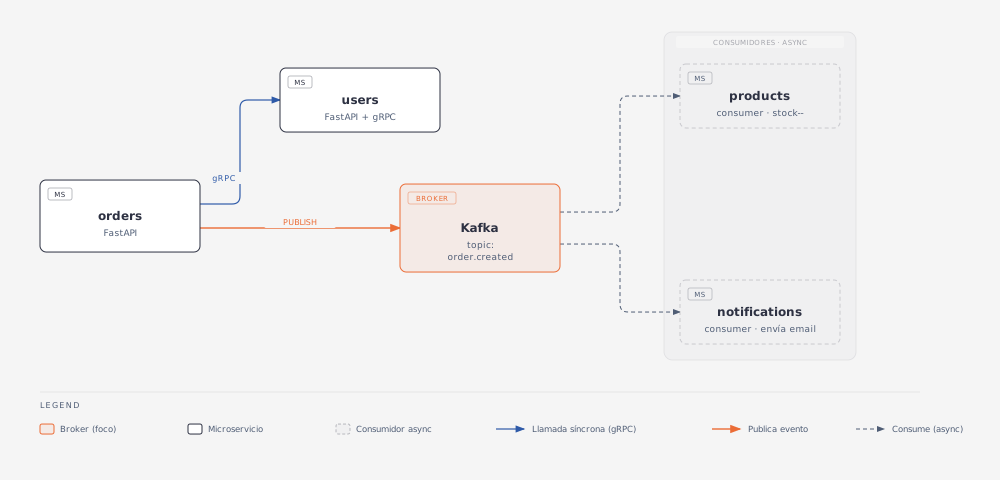
📎 Fuente editable en
04-Recursos/diagramas-tecnicos/clase-05-comunicacion-async/.
- Síncrono — gRPC (
orders → users):ordersnecesita un dato deusersahora mismo para responder (p. ej. el nombre del cliente antes de confirmar el pedido). Llama por gRPC — más rápido que REST porque serializa en binario (Protocol Buffers) en vez de JSON, y usa HTTP/2 — y espera la respuesta antes de seguir. Mientras espera, siusersestá caído o lento,orderstambién lo está para ese pedido: quedan acoplados en el tiempo. - Asíncrono — evento vía Kafka (
orders → products,orders → notifications): cuando se crea un pedido,orderspublica el eventoorder.createden un topic de Kafka y sigue — no espera a que nadie lo procese.productslo consume para descontar stock;notificationslo consume para mandar el email de confirmación.ordersno sabe (ni le importa) quién está escuchando ese topic — hoy son dos consumidores, mañana puede sumarse un tercero (p. ej. un servicio de analítica) sin tocar una línea deorders. Eso es desacoplamiento: sinotificationsestá caído, el pedido igual se crea — el email sale apenas el servicio vuelva. - ¿Y RabbitMQ / Amazon SQS+SNS? Son otros message brokers con el mismo rol que Kafka en este diagrama (recibir y entregar mensajes/eventos) pero con diseños distintos: Kafka está pensado para streams de eventos de alto volumen que varios consumidores pueden releer; SQS es una cola más simple (un mensaje, un consumidor, se borra al procesarlo); SNS es pub/sub puro. Clase 9 los cubre en profundidad con AWS.
🧪 Tip de entrevista: "¿cuándo uso llamada síncrona y cuándo un evento?" — síncrono cuando necesitás la respuesta para poder continuar (una validación, un dato que se muestra en la misma petición); asíncrono cuando el que dispara la acción no necesita esperar el resultado, solo que "eventualmente" pase (notificar, actualizar un índice, disparar un reporte). Abusar de lo síncrono entre microservicios crea cadenas de dependencias frágiles (si
Allama aBque llama aC, una falla enCtumba a los tres); abusar de lo asíncrono complica el debugging (seguir un flujo que salta por varios topics es más difícil que seguir una pila de llamadas).
🎼 Coreografía vs orquestación: dos formas de coordinar varios servicios
El flujo de order.created de arriba es un ejemplo de coreografía: no hay nadie a cargo, cada servicio reacciona al evento por su cuenta. Es una de dos formas de coordinar una operación de negocio que toca a varios servicios — la otra es la orquestación, y vale la pena conocer las dos porque cada una resuelve un problema distinto:
| 🎻 Coreografía (lo que ya se construyó) | 🎼 Orquestación | |
|---|---|---|
| Quién decide el flujo | Nadie central — cada servicio reacciona a eventos por su cuenta | Un coordinador explícito (p. ej. un OrderOrchestrator) que llama paso a paso |
| Ejemplo con OrderFlow | orders publica order.created; inventory y notifications reaccionan cada uno por separado | El orquestador llama: 1) inventory.reserve() 2) payment.charge() 3) si el paso 2 falla, llama inventory.release() para compensar |
| Ventaja | Bajo acoplamiento total — nadie conoce a nadie más que su propio evento | El flujo completo del negocio queda en un solo lugar, fácil de leer y depurar |
| Desventaja | Nadie tiene "la foto completa" — para depurar un pedido raro hay que rastrear 3-4 servicios distintos | El orquestador tiene que conocer a todos los participantes — reintroduce acoplamiento |
La tensión real: la orquestación resuelve el problema de "flujo invisible" de la coreografía, pero a costa de crear un servicio que sabe demasiado de los demás — el mismo acoplamiento de la sección 4, movido del nivel de datos al nivel de proceso de negocio. Ninguna de las dos gana siempre — depende de cuántos pasos tiene el flujo y qué tan compleja es la lógica de compensación si algo falla a mitad de camino. Cuando la compensación se vuelve difícil de mantener a mano, a veces se usa un motor dedicado para la orquestación (AWS Step Functions, Temporal) en vez de código propio.
📝 No confundir con orquestación de contenedores (Kubernetes, ECS, Docker Swarm) — mismo nombre, concepto distinto: ahí "orquestar" es gestionar cuántas réplicas de cada servicio corren y reiniciarlas si se caen, no coordinar un flujo de negocio. Se ve en Clase 10 (Docker) y Clase 11 (CI/CD).
🧪 Tip de entrevista: ¿cuál es la diferencia entre una Saga orquestada y una coreografiada? Es la misma tabla de arriba aplicada al patrón Saga (mencionado en la sección 2, fila "Transacciones"): una Saga orquestada tiene un coordinador que llama cada paso y sus compensaciones; una Saga coreografiada se arma solo con eventos y reacciones, sin coordinador — exactamente
order.createddisparando ainventoryynotificationsde este diagrama.
🔐 6. Seguridad en microservicios: autenticación y autorización
Con varios servicios expuestos en vez de uno, la pregunta de seguridad cambia de "¿cómo protejo mi app?" a "¿cómo protejo la conversación entre N apps, y la entrada desde afuera?". Tres mecanismos cubren capas distintas del mismo problema:
| Mecanismo | Qué protege | Dónde se aplica |
|---|---|---|
| OAuth 2.0 | Que una app obtenga acceso limitado (un token) sin manejar la contraseña del usuario. | En el borde: el login del usuario final contra el API Gateway o un servicio de identidad. |
| JWT | Que cada petición lleve la identidad/permisos ya verificados, sin repreguntarle a una base de datos en cada request. | El token que viaja en el header Authorization de cada llamada — el API Gateway lo valida una vez y lo reenvía a los microservicios. |
| mTLS | Que el tráfico interno (microservicio → microservicio) sea de un servicio confiable a otro, no de un impostor dentro de la red. | Entre microservicios (p. ej. orders → users por gRPC), no entre el cliente final y el gateway. |
- En el borde (frontend → API Gateway): el flujo típico es OAuth 2.0 Authorization Code — el usuario inicia sesión, el servicio de identidad le entrega un JWT, y ese JWT viaja en cada petición. El API Gateway centraliza la validación: revisa la firma y la expiración del token una sola vez, en un solo lugar, en vez de que cada uno de los tres microservicios tenga que reimplementar esa lógica.
- Entre microservicios (
orders → userspor gRPC): ahí no hay un usuario logueándose — es servicio hablándole a servicio. El flujo que aplica es OAuth 2.0 Client Credentials (cada servicio tiene su propia identidad/client id) y, para asegurar el transporte en sí, mTLS — asíuserssabe con certeza que quien le habla es realmenteorders, y no un contenedor comprometido dentro de la misma red. - Roles y permisos: el JWT no solo identifica quién llama, también puede llevar qué puede hacer (claims de rol/scope) — así
productspuede exigir el permisoproducts:writepara aceptar un cambio de stock, sin tener su propia tabla de usuarios y contraseñas.
🧪 Tip de entrevista: ¿por qué no le pasamos las credenciales del usuario a cada microservicio? Porque eso significa que los tres tendrían que saber validar contraseñas (más superficie de ataque, más código duplicado) y el usuario tendría que loguearse en cada uno. Con OAuth 2.0 + JWT, el usuario se autentica una sola vez y ese token —no la contraseña— es lo que viaja entre servicios.
💡 Este es el mapa de seguridad a alto nivel — Clase 7 implementa esto en código: emisión y validación de JWT, login, y control de roles/permisos en FastAPI.
🎯 7. Diseño del proyecto final: OrderFlow
Todo lo anterior de esta clase converge en un solo lugar: el proyecto final del curso. Se llama OrderFlow — la misma plataforma que ya se usó como ejemplo hipotético en la sección 2 (el caso de escalamiento con 20 000 consultas/min a productos) resultó ser, sin planearlo, el nombre real del proyecto.
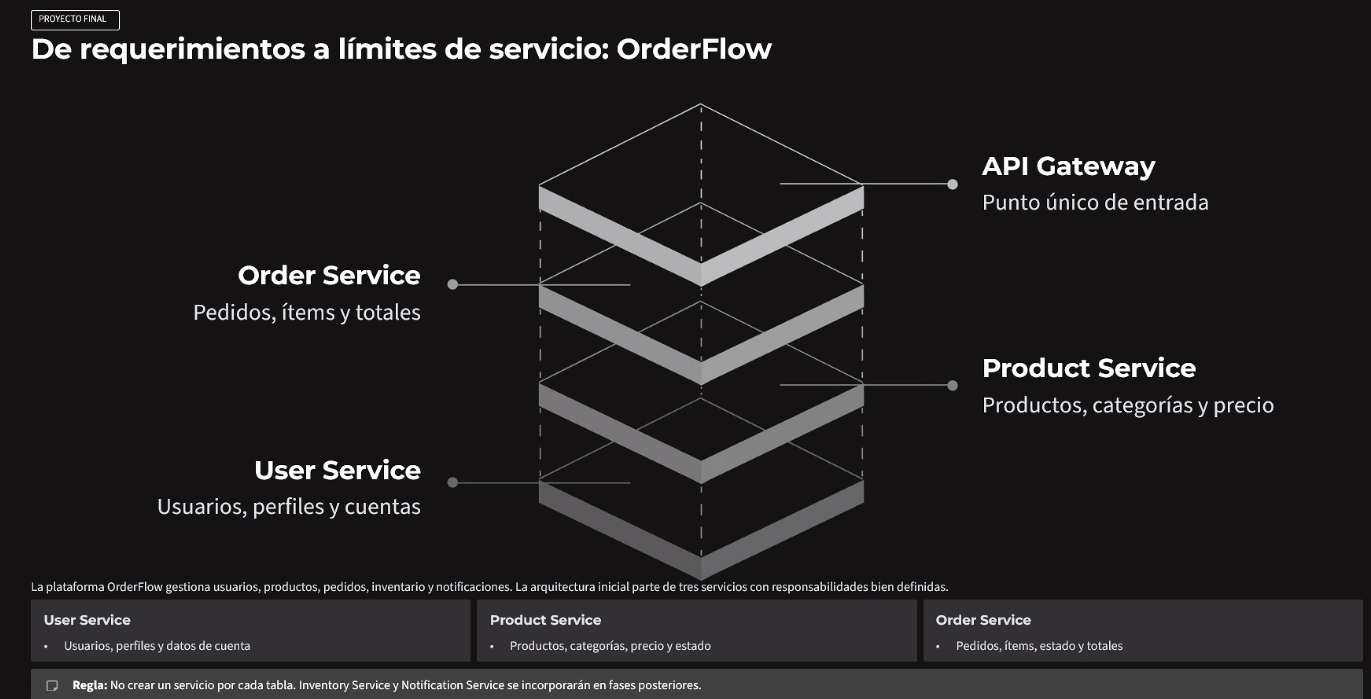
OrderFlow gestiona usuarios, productos, pedidos, inventario y notificaciones — los cinco dominios de negocio que ya se vinieron usando como ejemplo en toda la clase. La arquitectura inicial parte de solo tres servicios, cada uno con su responsabilidad bien definida:
| Servicio | Responsabilidad |
|---|---|
| API Gateway | Punto único de entrada — el mismo patrón de la sección 4. |
| User Service | Usuarios, perfiles y datos de cuenta — el Identity Context de la sección 3. |
| Product Service | Productos, categorías, precio y estado — el Catalog Context. |
| Order Service | Pedidos, ítems, estado y totales — el Orders Context. |
⚠️ Regla explícita del proyecto: "No crear un servicio por cada tabla. Inventory Service y Notification Service se incorporarán en fases posteriores." Es la misma idea que ya se dejó escrita en la sección 3 — "DDD no significa crear muchas clases ni usar microservicios obligatoriamente" — aplicada ahora como regla de diseño del proyecto real, no como advertencia abstracta.
InventoryyNotificationssí son Bounded Contexts propios (se vieron completos en el mapa de 4 contextos, sección 3), pero eso no obliga a que ya en la fase 1 sean su propio microservicio — pueden vivir dentro deOrder ServiceoProduct Servicehasta que una razón real (carga, equipo, cambio de ritmo) justifique separarlos. Exactamente la progresión de la sección 2: monolito modular → medir → identificar cuello de botella → extraer.
Cómo se conecta esto con lo que ya se construyó en la Parte Práctica de esta clase: los laboratorios de products-service, orders-servicios-separados, inventory_item.py y notifications-service adelantaron, como ejercicio, piezas que en el proyecto real llegan en fases distintas — están para practicar cada concepto por separado (Database per Service, Entity rica, separación física), no como el orden en el que hay que construir OrderFlow de punta a punta. El orden real del proyecto es:
Fase 1 (ahora)     API Gateway + User Service + Product Service + Order Service
Fase 2 (después)   + Inventory Service (cuando el stock lo justifique)
Fase 3 (después)   + Notification Service (cuando las notificaciones lo justifiquen)
🧪 Tip de entrevista: ¿por qué el proyecto arranca con 3 servicios y no con los 5 dominios completos de una vez? Porque partir de más servicios de los que el equipo puede operar bien es exactamente el error que toda la clase vino advirtiendo (sección 2: "adoptarlos sin ese problema solo suma complejidad operativa gratis"). Tres servicios con límites claros, bien hechos, valen más que cinco a medio terminar.
(sigue en desarrollo — falta el detalle de implementación de cada fase, que se ve en Clase 6)
💻 PARTE PRÁCTICA
🧱 Construir un primer microservicio con FastAPI
Antes de armar el sistema completo (Clase 6, con API Gateway y varios servicios conectados), vale la pena construir un solo microservicio y sentir en carne propia qué significa que sea independiente: su propio proyecto, su propio entorno virtual, su propio puerto, sin depender de nada más para arrancar.
Construyamos products — el mismo servicio que ya aparece en los dos diagramas de la Parte Teórica (secciones 4 y 5) — como un microservicio mínimo que expone su catálogo.
📎 Código completo y verificado en
02-Ejercicios/Clase-05/products-service/(main.py+requirements.txt).
1. Crear el proyecto y el entorno virtual
bash
mkdir -p 02-Ejercicios/Clase-05/products-service
cd 02-Ejercicios/Clase-05/products-service
python3 -m venv .venv

# Activación en macOS/Linux
source .venv/bin/activate

# Activación en Windows (si seguís el curso desde ahí)
.\.venv\Scripts\activate
Con el entorno activo, instalamos únicamente lo que este servicio necesita — ni SQLAlchemy ni Alembic todavía, porque de momento el catálogo vive en memoria:
bash
pip install fastapi "uvicorn[standard]"
pip freeze | grep -iE "^fastapi|^uvicorn" > requirements.txt
2. El servicio: main.py
python
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(
    title="products-service",
    description="Microservicio independiente: catálogo de productos.",
    version="1.0.0",
)


class Product(BaseModel):
    id: int
    name: str
    price: float
    stock: int


# "Base de datos" en memoria — en Clase 6 esto pasa a ser su propia PostgreSQL
# (Database per Service), separada de la de `users` y `orders`.
PRODUCTS: list[Product] = [
    Product(id=1, name="Teclado mecánico", price=89.90, stock=15),
    Product(id=2, name="Mouse inalámbrico", price=29.90, stock=40),
    Product(id=3, name="Monitor 27''", price=249.00, stock=8),
]


@app.get("/")
def home():
    return {"service": "products", "status": "ok"}


@app.get("/products", response_model=list[Product])
def list_products():
    return PRODUCTS


@app.get("/products/{product_id}", response_model=Product)
def get_product(product_id: int):
    for product in PRODUCTS:
        if product.id == product_id:
            return product
    raise HTTPException(status_code=404, detail="Producto no encontrado")
Tres cosas para notar, todas ligadas a la teoría de arriba:
- No hay nada de
usersni deordersacá. Este archivo es autosuficiente — se puede leer, correr y entender sin conocer el resto del sistema. Esa es la prueba de que el límite del servicio (su Bounded Context, sección 3) está bien puesto. PRODUCTSes una lista en memoria, no una tabla compartida — el día que se conecte a PostgreSQL, será su base de datos, la que ningún otro servicio toca directo (Database per Service, sección 4).- El puerto no está hardcodeado a un valor fijo del sistema completo — lo define quien lo levanta (
--port), porque en Clase 6 va a correr al lado deusersyorders, cada uno en el suyo.
3. Levantarlo y probarlo
bash
uvicorn main:app --port 5050$ curl http://127.0.0.1:5050/
{"service":"products","status":"ok"}
$ curl http://127.0.0.1:5050/products
[{"id":1,"name":"Teclado mecánico","price":89.9,"stock":15},{"id":2,"name":"Mouse inalámbrico","price":29.9,"stock":40},{"id":3,"name":"Monitor 27''","price":249.0,"stock":8}]
$ curl http://127.0.0.1:5050/products/2
{"id":2,"name":"Mouse inalámbrico","price":29.9,"stock":40}
$ curl -o /dev/null -w "%{http_code}\n" http://127.0.0.1:5050/products/999
404/products/999 devuelve 404 porque no existe ese id — es el mismo patrón de manejo de errores con HTTPException que ya se usó en Clase 3/4, no algo nuevo de microservicios.
🧪 Tip de entrevista: ¿por qué levantarlo con
uvicorn main:app --port 5050en vez del puerto por defecto (8000)? Porque en un sistema con varios microservicios, cada uno necesita su propio puerto para poder correr al mismo tiempo que los demás en la misma máquina — es lo que va a pasar en Clase 6 cuandousers,ordersyproductscorran juntos y el API Gateway (:8080, sección 4) los distinga por su URL interna.
🔁 Mismo microservicio, otro stack: products en Flask
Un punto que quedó en la tabla de la sección 2 — "cada servicio puede usar el stack que más le convenga" — se prueba mejor construyéndolo dos veces. Esta segunda versión de products hace lo mismo a alto nivel (exponer un catálogo por HTTP) pero con Flask en vez de FastAPI, y consumiendo el catálogo desde una API pública externa (dummyjson.com) en vez de una lista fija en memoria — para practicar también el patrón de "microservicio que agrega/transforma datos de otra fuente" antes de responder.
📎 Código completo y verificado en
02-Ejercicios/Clase-05/products-service-flask/(services/products.py+requirements.txt).
python
import os

import requests
from flask import Flask, jsonify

app = Flask(__name__)
port = int(os.environ.get("PORT", 5000))

DUMMYJSON_URL = "https://dummyjson.com"


@app.route("/")
def home():
    return "Hello, this is a Flask Microservice"


@app.route("/products", methods=["GET"])
def get_products():
    response = requests.get(f"{DUMMYJSON_URL}/products")
    if response.status_code != 200:
        return jsonify({"error": response.json().get("message", "error desconocido")}), response.status_code

    products = [
        {
            "id": product["id"],
            "title": product["title"],
            # No todos los productos de dummyjson.com traen "brand" (p. ej. categoría
            # "groceries") — .get() con default evita el KeyError que tira el acceso
            # directo si asumís que el campo siempre está.
            "brand": product.get("brand", "Sin marca"),
            "price": product["price"],
            "description": product["description"],
        }
        for product in response.json()["products"]
    ]
    return jsonify({"data": products}), 200 if products else 204


if __name__ == "__main__":
    app.run(debug=True, host="0.0.0.0", port=port)
Levantarlo (puerto 5000 por defecto de Flask, configurable por variable de entorno PORT):
bash
flask --app services/products run⚠️ En macOS, el puerto 5000 suele estar tomado por AirPlay Receiver — si el comando anterior falla con
Address already in use, ver este error documentado (correr con--port 5050, o desactivar AirPlay Receiver).
🖱️ Probado con Postman
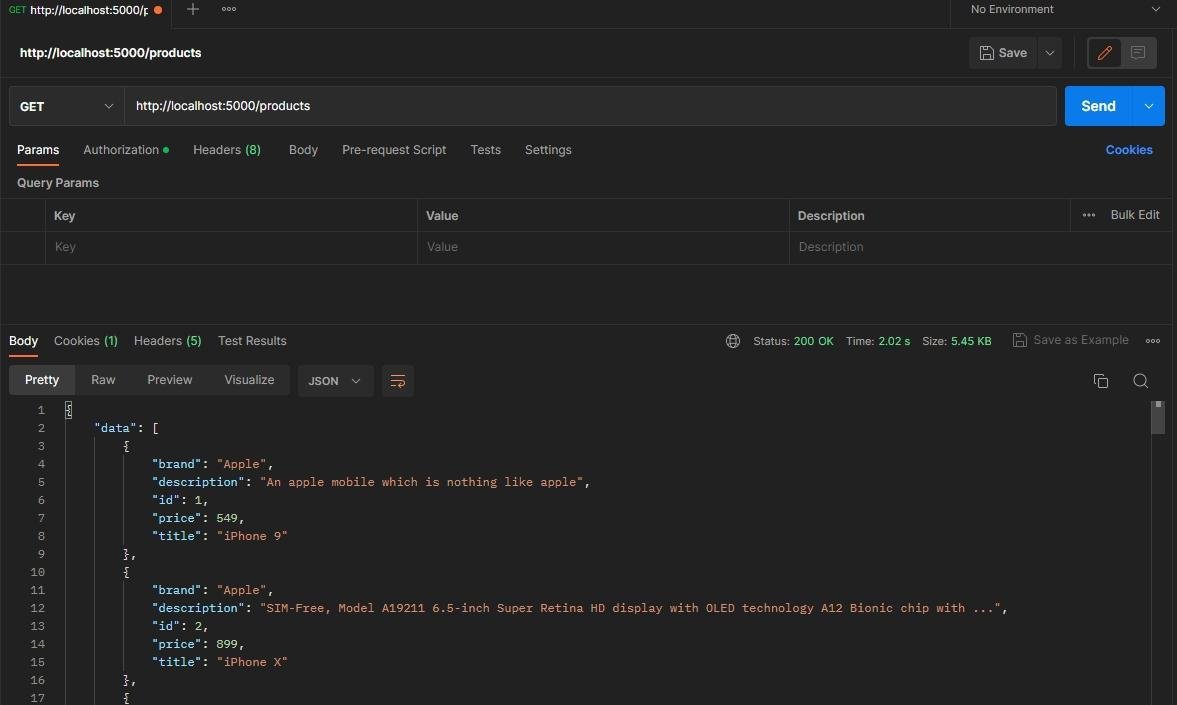
- El body viene envuelto en
{"data": [...]}— a diferencia deproducts-service(FastAPI), que devuelve la lista directa. Ninguna de las dos formas es "la correcta": es una decisión de diseño de cada equipo/servicio, y otro ejemplo de que dos microservicios pueden convivir sin tener que ponerse de acuerdo en esos detalles. - Como
dummyjson.comes una API pública real (no un mock fijo), el contenido concreto que devuelve puede variar entre una corrida y otra — lo que importa para este ejercicio es la forma de la respuesta (200 OK,data: [...], los camposid/title/brand/price/description), no memorizar qué producto aparece primero.
🧪 Tip de entrevista: ¿por qué armar el mismo servicio dos veces, en dos frameworks distintos? Porque es la forma más directa de comprobar la ventaja de "modularidad tecnológica" de microservicios (sección 2): a
orderso al API Gateway que los consuma no les importa siproductsestá en FastAPI o en Flask — ambos exponenGET /productspor HTTP, y eso es lo único que el resto del sistema necesita conocer de él.
🧩 Laboratorio: reconocer el antipatrón de Bounded Context en código real
La sección 3 explicó, en teoría, qué pasa cuando un servicio le toca los datos a otro por fuera de su API. Este laboratorio lo pone en código para que se vea concreto: un OrderService.create_order() que arma un pedido tocando usuarios, productos e inventario, todo en el mismo método.
📎 Código completo y verificado en
02-Ejercicios/Clase-05/orders-monolitico/order_service.py.
python
class OrderService:

    def create_order(self, user_id: int, product_id: int, quantity: int):
        # Usuarios
        user = USERS[user_id]

        # Productos
        product = PRODUCTS[product_id]

        # Inventario
        if product["stock"] < quantity:
            raise ValueError(
                "Stock insuficiente"
            )

        product["stock"] -= quantity

        # Pedidos
        total = (
            product["price"]
            * quantity
        )

        order = {
            "user": user["name"],
            "product": product["name"],
            "quantity": quantity,
            "total": total,
        }

        ORDERS.append(order)

        # Notificación
        print(
            f"Correo enviado a "
            f"{user['email']}"
        )

        return order
Corriéndolo con datos de prueba (USERS, PRODUCTS y ORDERS como diccionarios/lista en memoria — no estaban en el original, se agregaron para poder ejecutarlo y verificarlo):
$ python3 -c "from order_service import OrderService; OrderService().create_order(1, 1, 2)"
Correo enviado a ana@example.com
{'user': 'Ana Torres', 'product': 'Teclado mecánico', 'quantity': 2, 'total': 179.8}
$ # con quantity mayor al stock disponible:
ValueError: Stock insuficiente
¿Por qué es exactamente el antipatrón de la sección 3? Porque USERS y PRODUCTS son variables compartidas en memoria — OrderService las lee y las escribe directo (product["stock"] -= quantity), como si users, products y orders fueran el mismo proceso. Funciona perfecto así, mientras siga siendo un monolito. El día que orders se separe en su propio microservicio (Clase 6), este código deja de compilar: USERS y PRODUCTS ya no van a estar en su memoria — van a vivir en otro proceso, detrás de su propia API. Este mismo método tendría que volverse:
python
# Versión que sí respeta el límite de contexto (boceto — se implementa en Clase 6/7)
user = await users_client.get(user_id)           # HTTP/gRPC a users-service
product = await products_client.get(product_id)  # HTTP/gRPC a products-service
if product["stock"] < quantity:
    raise ValueError("Stock insuficiente")
await products_client.reserve_stock(product_id, quantity)  # PATCH, no asignación directa
No cambia la lógica de negocio (las mismas reglas: validar stock, calcular total, notificar) — cambia cómo llega a los datos. Es la misma distinción de la sección 5 (gRPC/HTTP en vez de tocar la base de datos de al lado) aplicada ahora a memoria en vez de base de datos: mismo problema, mismo síntoma, dos capas distintas.
🧪 Tip de entrevista: te muestran un método así y te preguntan "¿qué le cambiarías para microservicios?" — la respuesta no es "nada, ya funciona". Es identificar cada acceso directo a datos de otro dominio (
USERS[user_id],PRODUCTS[product_id],product["stock"] -=) y reemplazarlo por una llamada a la API del servicio dueño de ese dato. El qué hace la función no cambia; el cómo consigue sus datos, sí.
🪜 Un paso intermedio: separar responsabilidades en clases (todavía NO es microservicios)
Antes de saltar directo a HTTP/gRPC entre procesos, hay un paso intermedio que vale la pena dar aparte: sacar cada responsabilidad de OrderService a su propia clase, sin todavía separar procesos. Es la forma más simple de ver el principio de responsabilidad única (SRP) en acción, y de preparar el terreno para la separación real.
📎 Código completo y verificado en
02-Ejercicios/Clase-05/orders-servicios-separados/(user_service.py,product_service.py,inventory_service.py,notification_service.py,order_service.py,data.py).
python
class UserService:
    def get_user(self, user_id: int):
        return USERS[user_id]


class ProductService:
    def get_product(self, product_id: int):
        return PRODUCTS[product_id]


class InventoryService:
    def reserve(self, product_id: int, quantity: int):
        product = PRODUCTS[product_id]

        if product["stock"] < quantity:
            raise ValueError("Stock insuficiente")

        product["stock"] -= quantity


class NotificationService:
    def send(self, email: str, message: str):
        print(f"Enviando a {email}: {message}")
Y OrderService pasa de tocar USERS/PRODUCTS directo a orquestar a los cuatro:
python
class OrderService:
    def __init__(self):
        self.users = UserService()
        self.products = ProductService()
        self.inventory = InventoryService()
        self.notifications = NotificationService()

    def create_order(self, user_id: int, product_id: int, quantity: int):
        user = self.users.get_user(user_id)
        product = self.products.get_product(product_id)
        self.inventory.reserve(product_id, quantity)

        total = product["price"] * quantity
        order = {
            "user": user["name"],
            "product": product["name"],
            "quantity": quantity,
            "total": total,
        }
        ORDERS.append(order)

        self.notifications.send(
            email=user["email"],
            message=f"Tu pedido de {product['name']} fue confirmado.",
        )
        return order
Corre exactamente igual que la versión monolítica (mismo pedido, mismo ValueError con stock insuficiente) — la lógica de negocio no cambió un bit, cambió únicamente quién es dueño de qué dato.
⚠️ Esto todavía NO es microservicios — es el paso anterior, y confundirlos es un error común. Las 4 clases siguen en el mismo proceso Python, siguen importando
data.pydirecto (from data import USERS) — siguen leyendo la misma memoria compartida, sin red ni puerto ni base de datos separada de por medio. Es exactamente el ejemplo del callout "DDD no significa crear muchas clases ni usar microservicios obligatoriamente" de la sección 3: esto es DDD aplicado a nivel de código (una responsabilidad por clase), todavía dentro de un solo monolito modular (sección 2). Para que sea microservicios de verdad, cada clase necesita: su propio proceso, su propio puerto, su propia base de datos, y hablarle a las demás por HTTP/gRPC en vez deimport— el boceto deusers_client.get(...)del laboratorio anterior, que se arma en Clase 6.
🧪 Tip de entrevista: ¿cuál es la diferencia real entre "una clase por responsabilidad" y "un microservicio por responsabilidad"? El límite de proceso. Separar en clases mejora la organización del código y es gratis (no hay red de por medio); separar en microservicios además gana despliegue independiente y escalado por separado, pero cuesta latencia de red, fallos parciales y consistencia eventual (sección 2). El primero casi siempre conviene; el segundo, según la tabla de la sección 2.
✅ Checklist: qué le falta a orders-servicios-separados/ para ser microservicios de verdad
| # | Qué falta | Qué es hoy | Qué necesita ser |
|---|---|---|---|
| 1 | Proceso separado | Las 4 clases corren en el mismo python3 | Cada una levantada como su propia app FastAPI, su propio main.py, corriendo en paralelo (--port 8001, 8002...) |
| 2 | Comunicación por red | self.users = UserService() → llamada Python directa, en memoria | self.users = httpx.get("http://users-service:8001/users/1") → HTTP (o gRPC) — sección 5 |
| 3 | Database per Service | Todas comparten data.py (mismas variables) | Cada servicio con su propia base de datos — users no puede ver la tabla de products ni al revés — sección 4 |
| 4 | Despliegue independiente | Un solo python3 -c "..." levanta todo | Cada carpeta con su propio Dockerfile/requirements.txt, desplegable sola sin tocar las demás |
| 5 | Punto de entrada único | No hay — se importa directo | Un API Gateway que enrute /api/users, /api/products, etc. — sección 4 |
| 6 | Manejo de fallas de red | No aplica — si algo falla, es una excepción Python normal | Timeouts, retries, circuit breakers — ahora products-service puede estar lento o caído, un caso que no existía en memoria |
| 7 | Consistencia entre pasos | Automática — todo pasa en la misma transacción de proceso | Si InventoryService.reserve() triunfa pero crear el pedido falla en otro proceso, ya no hay rollback automático — hace falta consistencia eventual (sagas, eventos — Kafka, sección 5) |
| 8 | Seguridad entre servicios | No aplica — es la misma memoria, confianza implícita | Autenticar cada llamada servicio-a-servicio (OAuth 2.0 Client Credentials / mTLS) — sección 6 |
💡 La forma más simple de verlo: hoy
importresuelve los pasos 1-3 gratis (mismo proceso, mismo dato, misma transacción). En cuanto se separa por red, esas tres cosas dejan de venir gratis y hay que resolverlas a propósito — eso es literalmente el contenido de las secciones 4, 5 y 6, ahora aplicado a este ejemplo concreto en vez de ausers/orders/productsen abstracto. Es el punto exacto donde este laboratorio se conecta con Clase 6.
🛡️ De diccionario a Entity: InventoryItem protege su propio invariante
InventoryService.reserve(product_id, quantity) (arriba) mejoró quién toca el dato, pero el dato en sí seguía siendo un dict cualquiera (PRODUCTS[product_id]) que cualquier código con acceso a data.py puede mutar como quiera:
python
item.available_stock -= quantity      # ❌ nada impide dejarlo en negativo
item.reserve(quantity)                # ✅ el objeto se protege a sí mismo
La diferencia entre esas dos líneas es DDD en su forma más concreta: en la primera, available_stock es un número suelto que confía en que quien lo use recuerde validar el stock antes de restar. En la segunda, esa regla vive adentro del objeto — no hay forma de bajar el stock sin pasar por la validación, porque el método es el único camino de entrada. Esto es un modelo de dominio rico (rich domain model), y su opuesto (una clase o dict que solo guarda datos, sin proteger nada) se llama modelo anémico (anemic domain model) — la mayoría del código que se escribe sin pensar en DDD termina siendo anémico, sin que sea intencional.
📎 Código completo y verificado en
02-Ejercicios/Clase-05/orders-servicios-separados/inventory_item.py.
python
class InsufficientStockError(Exception):
    pass


class InventoryItem:
    def __init__(self, sku: str, available_stock: int):
        self.sku = sku
        self.available_stock = available_stock

    def reserve(self, quantity: int):
        if quantity <= 0:
            raise ValueError("La cantidad debe ser positiva")

        if quantity > self.available_stock:
            raise InsufficientStockError(
                f"Stock disponible: {self.available_stock}"
            )

        self.available_stock -= quantity
Tres decisiones de diseño, todas conectadas a secciones anteriores:
sku: str, noname: str. Un SKU (Stock Keeping Unit) es un identificador de negocio pensado para ser único y estable — a diferencia de un nombre, que puede repetirse o cambiar. Es la misma idea de identidad de una Entity que ya se mencionó: algo se referencia por lo que es, no por un atributo suyo que puede variar.InsufficientStockError, noValueErrorgenérico.ValueErrorsigue usándose para un error de programación (mandar una cantidad negativa — culpa de quien llama);InsufficientStockErrores un error de negocio (no hay stock — no es un bug, es una regla del dominio que se cumplió). Separar ambos tipos de excepción deja el código que llama areserve()decidir distinto para cada caso (un 400 vs un 409, por ejemplo), sin tener que inspeccionar el mensaje del error para saber cuál pasó.self.available_stock -= quantityvive adentro dereserve(), no afuera. Nadie fuera deInventoryItempuede bajar el stock sin pasar las dos validaciones de arriba — el invariante ("nunca reservar más de lo disponible") queda garantizado por el objeto mismo, no por la disciplina de quien lo usa.
Corrida real (caso feliz + los dos tipos de error):
$ python3 -c "from inventory_item import InventoryItem; i = InventoryItem('TEC-001', 15); i.reserve(2); print(i.available_stock)"
13
$ # reserve(0) ->
ValueError: La cantidad debe ser positiva
$ # reserve(999) ->
InsufficientStockError: Stock disponible: 13
🧪 Tip de entrevista: ¿qué es un "modelo anémico" y por qué se considera un anti-pattern en DDD? Es una clase que solo tiene datos (getters/setters, atributos públicos) sin comportamiento — toda la lógica vive afuera, en services que la manipulan. No es "incorrecto" en el sentido de que no compile, pero desperdicia la ventaja central de la programación orientada a objetos: agrupar datos y las reglas que los protegen en el mismo lugar.
InventoryItemes la versión no-anémica de lo que antes eraPRODUCTS[product_id]["stock"] -= quantity.
🚚 Separación física: sacar notifications a su propio proceso
La extracción de un microservicio real no es todo o nada — se hace de a una pieza por vez. La checklist de arriba mostró 8 cosas que faltan; acá se resuelven la 1 y la 4 (proceso separado, despliegue independiente) para una sola de las cuatro piezas: notifications. Se eligió esa primero, no products ni inventory, porque es la que menos depende de las demás — no lee ni escribe USERS/PRODUCTS, solo recibe un email y un mensaje. Es la extracción de menor riesgo: el mismo criterio de "extraer el módulo que menos ata al resto primero" que ya se explicó en la sección 2 (ejemplo de telemedicina, teleecg como cuello de botella).
📎 Código completo y verificado en
02-Ejercicios/Clase-05/notifications-service/(el proceso nuevo) y02-Ejercicios/Clase-05/orders-servicios-separados/(notification_client.pyreemplaza anotification_service.py).
El proceso nuevo — corre solo, en su propio puerto:
python
# notifications-service/main.py
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="notifications-service")


class NotificationRequest(BaseModel):
    email: str
    message: str


@app.post("/notifications/send")
def send_notification(payload: NotificationRequest):
    print(f"Enviando a {payload.email}: {payload.message}")
    return {"status": "sent", "email": payload.email}
Lo que cambia del lado de orders — no la lógica de OrderService.create_order() (esa queda intacta), sino qué hay detrás de self.notifications.send(...):
python
# Antes (notification_service.py) — clase local, mismo proceso
class NotificationService:
    def send(self, email: str, message: str):
        print(f"Enviando a {email}: {message}")

# Ahora (notification_client.py) — mismo método .send(), otro proceso adentro
class NotificationServiceClient:
    def send(self, email: str, message: str):
        response = httpx.post(
            "http://127.0.0.1:5070/notifications/send",
            json={"email": email, "message": message},
            timeout=5.0,
        )
        response.raise_for_status()
        return response.json()
OrderService no se enteró del cambio — sigue llamando self.notifications.send(...) igual que antes. Eso es la ventaja real de haber separado en clases primero (paso anterior): la extracción física no obligó a tocar create_order(), solo la implementación de una sola dependencia.
Prueba real, con los dos procesos corriendo a la vez:
$ cd notifications-service && uvicorn main:app --port 5070 &
Uvicorn running on http://127.0.0.1:5070
$ cd ../orders-servicios-separados && python3 -c "from order_service import OrderService; OrderService().create_order(1, 1, 2)"
order: {'user': 'Ana Torres', 'product': 'Teclado mecánico', 'quantity': 2, 'total': 179.8}
· log de notifications-service, EN OTRA TERMINAL:
Enviando a ana@example.com: Tu pedido de Teclado mecánico fue confirmado.
"POST /notifications/send HTTP/1.1" 200 OK
La prueba de que la separación es real: el print de "Enviando a..." ya no aparece en la terminal donde corre orders — aparece en la terminal de notifications-service, porque ahí es donde ahora vive ese código. Si notifications-service estuviera caído, create_order() fallaría con un error de conexión (httpx.ConnectError) — un tipo de falla que no existía cuando todo era una sola clase Python.
⚠️ Lo que todavía NO se resolvió (y queda para Clase 6, a propósito):
users,productseinventorysiguen locales, compartiendodata.py. Tampoco hay retry sinotifications-serviceestá caído — hoy, si falla,create_order()explota entera (el pedido ni se guarda), cuando en realidad "el pedido se creó pero el email no salió todavía" debería ser un estado válido. Ese es justo el caso de uso real de la comunicación asíncrona de la sección 5 (Kafka) en vez de la llamada síncrona que se usó acá — vale la pena releer esa sección con este ejemplo concreto en mente.
🏋️ EJERCICIOS CON SOLUCIÓN
Ejercicio 1 — Caso TecnoMarket: clasificar operaciones por Bounded Context
TecnoMarket permite registrar clientes, autenticarse, administrar productos, cambiar precios, controlar stock en varios almacenes, realizar pedidos, cobrar tarjetas, realizar devoluciones y enviar mensajes de confirmación.
Este ejercicio se basa directo en el mapa de 4 contextos de la sección 3 — la misma referencia, para tenerla a mano sin tener que volver a scrollear:
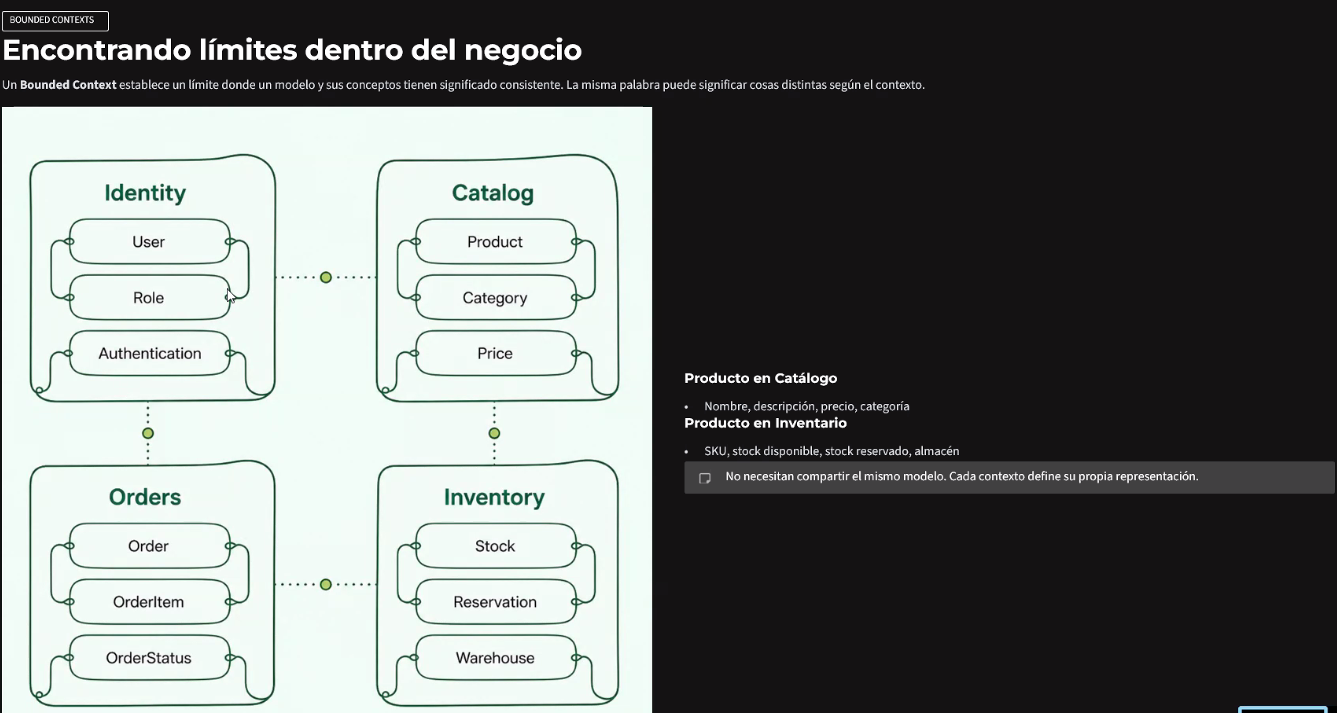
Para cada operación de la tabla, indicá a qué Bounded Context pertenece. Los 4 que ya viste en la sección 3 (y en la imagen de arriba) son Identity, Catalog, Orders e Inventory — pero ojo, alguna operación puede no encajar limpio en ninguno de esos 4.
| # | Operación | Tu respuesta |
|---|---|---|
| 1 | Cambiar contraseña | Identity (ejemplo resuelto) |
| 2 | Actualizar precio | ? |
| 3 | Reservar 3 unidades | ? |
| 4 | Crear pedido | ? |
| 5 | Registrar pago | ? |
| 6 | Realizar reembolso | ? |
| 7 | Agregar categoría | ? |
| 8 | Consultar stock | ? |
| 9 | Cambiar estado de pedido | ? |
| 10 | Registrar usuario | ? |
💡 ¿Sabías que…? — cómo reconocer el contexto de una operación
Truco rápido: fijate qué sustantivo de negocio protagoniza la operación, y comparalo contra el lenguaje ubicuo de cada contexto (sección 3, glosario de la sección 1): Identity habla de User/Role/Authentication; Catalog de Product/Category/Price; Orders de Order/OrderItem/OrderStatus; Inventory de Stock/Reservation/Warehouse.
Ejemplo de referencia, con otro caso ("ClinicApp"): "agendar una cita" — el sustantivo protagonista es cita (Appointment), no paciente ni doctor — va al contexto que modela Appointment, aunque toque datos de paciente y doctor de refilón.
Ver solución
| # | Operación | Contexto | Explicación |
|---|---|---|---|
| 1 | Cambiar contraseña | Identity | Ejemplo dado. La contraseña es un dato de autenticación — vive en el mismo lugar que User/Role/Authentication, no tiene nada que ver con productos, pedidos ni stock. |
| 2 | Actualizar precio | Catalog | El precio es un atributo del producto tal como lo ve el cliente en la vitrina — exactamente el lenguaje ubicuo de Catalog (Product · Category · Price, ya visto en el mapa de la sección 3). No toca stock ni pedidos. |
| 3 | Reservar 3 unidades | Inventory | "Reservar" es literalmente el verbo del lenguaje ubicuo de Inventory (Stock · Reservation · Warehouse) — es la misma operación que ya se implementó en código real con InventoryItem.reserve(quantity) en la Parte Práctica. |
| 4 | Crear pedido | Orders | Un pedido es la entidad central de Orders (Order · OrderItem · OrderStatus). Aunque para crearlo haga falta consultar Catalog (precio) e Inventory (stock), la operación en sí — "crear el pedido" — es responsabilidad de Orders, tal como se vio con OrderService.create_order() orquestando a los demás. |
| 5 | Registrar pago | Invoice / Orders ⚠️ | No encaja limpio en Identity/Catalog/Inventory. La respuesta esperada acepta dos lecturas: como su propio contexto de facturación (Invoice — cobros, comprobantes, es un lenguaje distinto al de Order), o como parte de Orders si el equipo decide que el estado de pago es simplemente otro atributo del ciclo de vida del pedido. Ninguna es "la" única correcta — es una decisión de diseño real, no un dato memorizable. |
| 6 | Realizar reembolso | Invoice / Orders ⚠️ | Mismo razonamiento que "Registrar pago": un reembolso es la operación inversa de un cobro — vive donde se haya decidido modelar la facturación, ya sea como parte de Invoice o de Orders. |
| 7 | Agregar categoría | Catalog | Category es, otra vez, lenguaje ubicuo explícito de Catalog — las categorías organizan el catálogo de productos, no tienen relación con inventario ni con pedidos. |
| 8 | Consultar stock | Inventory | Stock es el término central de Inventory. Nótese que es distinto de "consultar precio" (que sí sería Catalog) — son dos preguntas sobre el "mismo" producto que en realidad viven en dos contextos distintos (la lección de la sección 3 sobre "Producto en Catalog" vs "Producto en Inventory"). |
| 9 | Cambiar estado de pedido | Orders | OrderStatus es lenguaje ubicuo explícito de Orders — es el ciclo de vida del pedido (creado → pagado → enviado, etc.), una responsabilidad exclusiva de ese contexto. |
| 10 | Registrar usuario | Identity | User es el concepto central de Identity — dar de alta un usuario nuevo es la operación fundacional del contexto, la misma familia que "Cambiar contraseña" (fila 1). |
⚠️ El contexto que no estaba en el mapa: "Registrar pago" y "Realizar reembolso" no encajan limpio en
Identity/Catalog/Orders/Inventory— el enunciado ya lo insinuaba ("cobrar tarjetas, realizar devoluciones"). La respuesta esperada esInvoice/Orders: TecnoMarket puede modelar la facturación como su propio Bounded Context (Invoice) o como parte deOrders, y ambas son válidas — esto no es un quinto contexto obligatorio, es un límite que depende de cuánta complejidad propia tenga la facturación (¿solo un estado, o reglas de impuestos, comprobantes, conciliación con la pasarela de pago? Cuanta más complejidad propia, más se justifica separarlo). Y hay un candidato adicional asomando en el propio enunciado: "enviar mensajes de confirmación" es lo que ya construiste comonotifications-serviceen la Parte Práctica — tampoco estaba dibujado como contexto propio. Es exactamente el punto de un ejercicio de Context Mapping: los límites no vienen dados de entrada, se encuentran analizando las operaciones reales del negocio — y casi siempre aparecen más de los que el primer diagrama mostraba.
Ejercicio 2 — Elegir arquitectura para PetCare
Un veterinario quiere digitalizar su clínica: agendar citas, historial médico de mascotas y facturación. Lo hacen 2 desarrolladores, la clínica tiene una sola sucursal, ~50 citas por día. ¿Monolito o microservicios? Justificá con la matriz de decisión de la sección 2.
💡 ¿Sabías que…? — cómo usar la matriz de decisión
Repasá fila por fila: tamaño de equipo, complejidad del dominio, si las funcionalidades escalan distinto entre sí, si hay varios equipos, si hay experiencia DevOps. Contá cuántas filas caen del lado "Monolito" vs "Microservicios".
Ejemplo de referencia, con otro caso ("Ferretería Don José", un solo local, 1 desarrollador): inventario, ventas y caja — todo en un mismo dominio simple, un equipo de una persona. Ninguna fila apunta a microservicios.
Ver solución
Monolito modular. Producto nuevo/equipo chico → recomendado; dominio simple (una sola sucursal, sin picos de tráfico dispares entre módulos) → adecuado; no hay funcionalidades con necesidades de escalamiento muy distinto; no hay varios equipos autónomos que necesiten trabajar en paralelo sin pisarse; no se menciona experiencia operando infraestructura distribuida. Cero filas empujan hacia microservicios. Recomendación: un monolito con módulos separados (citas/, historial/, facturacion/) — listo para partirse el día que la clínica abra más sucursales o sume varios equipos.
Ejercicio 3 — Construir el microservicio reviews
Igual que products-service de la Parte Práctica, pero para reseñas de productos: exponé GET /reviews (todas) y GET /reviews/{review_id} (una). Cada reseña tiene id, product_id, rating (1 a 5) y comment. Un id inexistente debe devolver 404.
💡 ¿Sabías que…? — el mismo patrón de products-service, otro dominio
La estructura es idéntica a products-service/main.py: un modelo Pydantic, una lista en memoria, dos rutas GET, HTTPException(404) para el caso no encontrado.
Ejemplo de referencia, con otro dominio ("comentarios de un blog", no reseñas de producto):
python
class Comment(BaseModel):
    id: int
    post_id: int
    author: str
    text: str
Ver solución
python
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(title="reviews-service")


class Review(BaseModel):
    id: int
    product_id: int
    rating: int
    comment: str


REVIEWS: list[Review] = [
    Review(id=1, product_id=1, rating=5, comment="Excelente, muy cómodo."),
    Review(id=2, product_id=1, rating=4, comment="Bueno, pero ruidoso."),
    Review(id=3, product_id=2, rating=3, comment="Cumple, nada más."),
]


@app.get("/reviews", response_model=list[Review])
def list_reviews():
    return REVIEWS


@app.get("/reviews/{review_id}", response_model=Review)
def get_review(review_id: int):
    for review in REVIEWS:
        if review.id == review_id:
            return review
    raise HTTPException(status_code=404, detail="Reseña no encontrada")
Verificado: GET /reviews devuelve las 3 reseñas; GET /reviews/2 devuelve la del mouse; GET /reviews/999 devuelve 404.
📎 Código en
02-Ejercicios/Clase-05/ejercicios-solucion/ejercicio_3_reviews_service.py.
Ejercicio 4 — Bounded Context para ClinicApp
Retomando "ClinicApp" (el ejemplo de referencia del Ejercicio 1): tiene los contextos Identity (veterinarios/staff), Scheduling (citas), MedicalRecords (historial de mascotas) y Billing (facturación). Clasificá estas 5 operaciones:
| # | Operación | Tu respuesta |
|---|---|---|
| 1 | Agendar cita | ? |
| 2 | Actualizar historial médico de una mascota | ? |
| 3 | Emitir factura | ? |
| 4 | Cambiar contraseña del veterinario | ? |
| 5 | Registrar una mascota nueva | ? |
💡 ¿Sabías que…? — mismo truco del Ejercicio 1
Sustantivo protagonista + lenguaje ubicuo de cada contexto. Si dudás entre dos contextos, preguntate: ¿de quién es el dato que esta operación cambia?
Ver solución
| # | Operación | Contexto | Por qué |
|---|---|---|---|
| 1 | Agendar cita | Scheduling | Appointment es su lenguaje ubicuo. |
| 2 | Actualizar historial médico de una mascota | MedicalRecords | El historial es el dato que este contexto protege — ni Scheduling ni Billing deberían tocarlo. |
| 3 | Emitir factura | Billing | Facturación es su propio lenguaje (montos, comprobantes), no el de la cita en sí. |
| 4 | Cambiar contraseña del veterinario | Identity | Autenticación — igual que en TecnoMarket (Ejercicio 1, fila 1). |
| 5 | Registrar una mascota nueva | MedicalRecords | Una mascota nueva abre su propio registro clínico — nace ahí, no en Scheduling. |
Ejercicio 5 — Modelo de dominio rico: ShoppingCart
Escribí una clase ShoppingCart con add_item(name, price) y checkout(). checkout() debe lanzar una excepción de dominio propia (no ValueError genérico) si el carrito está vacío, y devolver los ítems + el total si no lo está. Mismo patrón que InventoryItem de la Parte Práctica.
💡 ¿Sabías que…? — protegiendo un invariante distinto
El invariante acá no es "stock suficiente", es "no hacer checkout de un carrito vacío" — misma idea (InventoryItem.reserve() valida antes de mutar), otro dominio.
Ejemplo de referencia, con otro invariante ("una Playlist no puede reproducirse si no tiene canciones"):
python
class EmptyPlaylistError(Exception):
    pass

class Playlist:
    def __init__(self):
        self.songs = []

    def play(self):
        if not self.songs:
            raise EmptyPlaylistError("La playlist está vacía")
        return self.songs[0]
Ver solución
python
class EmptyCartError(Exception):
    pass


class ShoppingCart:
    def __init__(self):
        self.items = []

    def add_item(self, name: str, price: float):
        self.items.append({"name": name, "price": price})

    def checkout(self):
        if not self.items:
            raise EmptyCartError("El carrito está vacío")

        total = round(sum(item["price"] for item in self.items), 2)
        return {"items": self.items, "total": total}
Verificado: checkout() con carrito vacío lanza EmptyCartError; con dos ítems (89.90 + 29.90) devuelve {'total': 119.8, ...}.
📎 Código en
02-Ejercicios/Clase-05/ejercicios-solucion/ejercicio_5_shopping_cart.py.
Ejercicio 6 — Detectar el antipatrón
En PetCare, BillingService arma la factura de una cita haciendo un SELECT directo a la tabla appointments de la base de datos de Scheduling, en vez de pedirle los datos a través de su API. ¿Qué antipatrón es? ¿Cómo se corrige?
💡 ¿Sabías que…? — el mismo patrón del diagrama de la sección 3
Compará contra el diagrama "la versión correcta, sin ambigüedad": hay un camino real (por contrato) y un camino tachado (acceso directo a la base ajena).
Ver solución
Es el antipatrón de alto acoplamiento por acceso directo a datos (sección 3): BillingService depende del esquema interno de Scheduling, no de un contrato público — si Scheduling renombra una columna, BillingService se rompe sin avisar. Corrección: BillingService debe pedirle los datos de la cita a Scheduling por su API (p. ej. GET /appointments/{id}), igual que orders le pide el producto a products en vez de leer su base de datos.
Ejercicio 7 — Síncrono o asíncrono
Para estas 4 operaciones de OrderFlow, decidí si conviene llamada síncrona o evento asíncrono, y justificá con el criterio de la sección 5:
- Validar que el producto existe antes de confirmar el pedido.
- Enviar el email de confirmación del pedido.
- Descontar el stock al confirmarse un pedido.
- Generar el reporte mensual de ventas.
💡 ¿Sabías que…? — la pregunta clave
¿El que dispara la acción necesita la respuesta para poder seguir? Si sí, síncrono. Si solo necesita que "eventualmente" pase, asíncrono.
Ver solución
- Síncrono —
ordersnecesita saber ya si el producto existe para poder confirmar o rechazar el pedido en esa misma petición. - Asíncrono — nadie necesita esperar el email para que el pedido quede confirmado (el mismo
notificationsdel diagrama de Kafka). - Asíncrono — tal como está dibujado en el diagrama de la sección 5:
orderspublicaorder.createdyproductslo consume para descontar stock, sin queordersespere esa respuesta. - Asíncrono (y además por lotes) — es el caso de consolidación nocturna de la sección 4: consistencia analítica, no operativa.
Ejercicio 8 — Coreografía o orquestación
Cancelar un pedido implica: 1) liberar el stock reservado, 2) reembolsar el pago si ya se cobró, 3) notificar al cliente. Si el reembolso falla, hay que revertir la liberación de stock. ¿Coreografía o orquestación? Justificá.
💡 ¿Sabías que…? — la señal que decide
Repasá la tabla de la sección 5: ¿el flujo necesita lógica de compensación explícita entre pasos, o cada servicio puede reaccionar solo sin coordinarse con nadie?
Ver solución
Orquestación. Hay una dependencia explícita entre pasos con lógica de compensación ("si falla el paso 2, deshacer el paso 1") — exactamente el caso donde la coreografía se vuelve difícil de rastrear (sección 5): con eventos sueltos, nadie tendría la responsabilidad clara de revertir la liberación de stock si el reembolso falla. Un CancelOrderOrchestrator que llame los 3 pasos y sepa compensar el primero si el segundo falla deja ese flujo legible en un solo lugar.
Ejercicio 9 — Seguridad en el flujo
Un usuario logueado en OrderFlow pide ver su historial de pedidos. Order Service necesita pedirle a Product Service el nombre actualizado de cada producto para armar la respuesta. ¿Qué mecanismo de seguridad aplica en cada tramo?
💡 ¿Sabías que…? — dos tramos, dos flujos de OAuth distintos
Repasá la sección 6: hay un tramo con usuario humano de por medio y otro sin ninguno.
Ver solución
- Frontend → API Gateway: OAuth 2.0 Authorization Code — el usuario ya inició sesión, tiene un JWT, y ese JWT viaja en la petición.
- Gateway → Order Service: el Gateway reenvía el JWT ya validado.
- Order Service → Product Service: acá no hay usuario humano — es servicio-a-servicio. Aplica OAuth 2.0 Client Credentials (cada servicio con su propia identidad) + mTLS para asegurar el transporte, igual que
orders → userspor gRPC en la sección 6.
Ejercicio 10 — Diseño integrador: FoodExpress
Diseñá a alto nivel una plataforma de delivery de comida, FoodExpress, que gestiona restaurantes, menús, pedidos, repartidores y pagos. Definí: (a) los Bounded Contexts, (b) qué 3 servicios arrancarían en la fase 1 (misma regla de OrderFlow: no un servicio por tabla), (c) un ejemplo de comunicación síncrona y uno asíncrono, (d) qué patrón de seguridad usar entre el Gateway y los servicios.
💡 ¿Sabías que…? — es el mismo ejercicio que ya resolvió el curso
Este ejercicio es "arma tu propio OrderFlow" — repasá la sección 7 punto por punto y reemplazá cada pieza por su equivalente en FoodExpress.
Ver solución
(a) Bounded Contexts: Identity (usuarios y repartidores), Catalog (restaurantes y menús), Orders (pedidos), Delivery (asignación de repartidor y tracking), Payments (cobros) — cinco contextos, el mismo tamaño que OrderFlow (Identity/Catalog/Orders/Inventory + el candidato Payments del Ejercicio 1).
(b) Fase 1: API Gateway + User Service (Identity) + Catalog Service + Order Service — igual regla que OrderFlow: no crear Delivery Service ni Payment Service de entrada; se incorporan cuando el volumen de repartos o la complejidad de cobros lo justifique (sección 7).
(c) Síncrono: Order Service llama a Catalog Service para validar que el ítem del menú existe y confirmar su precio actual, antes de aceptar el pedido — necesita la respuesta ya (mismo criterio del Ejercicio 7, punto 1). Asíncrono: orders publica order.created; cuando Delivery Service exista (fase posterior), lo consume para asignar un repartidor sin que orders espere esa asignación.
(d) Seguridad: OAuth 2.0 Authorization Code + JWT en el borde (frontend → Gateway), Client Credentials + mTLS entre servicios — el mismo patrón de OrderFlow (sección 6), sin inventar nada nuevo para FoodExpress.
❓ Preguntas y respuestas (autoevaluación)
(pendiente — 10 preguntas graduales)
📎 Apuntes relacionados
(pendiente)