Apariencia
📙 Clase 11 — CI/CD y despliegue en AWS
Python para Backend · 2026-09-10 · Carpeta:
02-Ejercicios/Clase-11⬅️ Volver al índice de clases
🎯 Qué aprendí (según temario — se amplía a medida que avanza la clase)
- ✅ Automatización de pruebas con
pytestdentro del pipeline de CI/CD: qué pasa si el test pasa (el pipeline sigue hacia Docker build y ECR) vs. si falla (el pipeline se detiene ahí mismo, sin build ni despliegue). - ✅ Amazon ECR como registro de imágenes Docker en la nube, y la buena práctica de etiquetar cada imagen con el SHA del commit en vez de solo
latest, para trazabilidad completa (saber exactamente qué código corre en producción). - ✅ Amazon ECS Fargate: cómo se ejecuta un contenedor en AWS sin gestionar servidores (Cluster → Task Definition → Service → Fargate), y la diferencia entre ECR (almacena imágenes) y ECS (las ejecuta y orquesta).
- ✅ Autenticación segura entre GitHub Actions y AWS con OIDC, en vez de guardar credenciales de AWS de larga duración como secrets del repositorio.
- ✅ El pipeline de CI/CD completo de punta a punta, aplicado al proyecto final
OrderFlow:git push→ checkout + pytest →docker build+ push a ECR → actualizar Task Definition + Service en ECS. - 🔜 Introducción a CI/CD (conceptos generales)
- 🔜 GitHub Actions (estructura completa del workflow: triggers, jobs, steps)
📖 PARTE TEÓRICA
📚 1. Definiciones clave
| Término | Qué es | Se profundiza en |
|---|---|---|
| CI/CD (Continuous Integration / Continuous Deployment) | Práctica de automatizar, en un pipeline, los pasos que van desde que se sube código (git push) hasta que queda corriendo en producción: instalar dependencias, correr pruebas, construir la imagen y desplegarla. | sección 2 |
| Pipeline | La secuencia de steps (pasos) que ejecuta el sistema de CI/CD, uno detrás de otro. Si un step falla, los siguientes no se ejecutan. | sección 2 |
| pytest | Framework de testing de Python. Detecta automáticamente las funciones que empiezan con test_ y las ejecuta como pruebas independientes. | sección 2 |
assert | Instrucción de Python que verifica que una condición sea verdadera; si es falsa, lanza un error y la prueba se marca como fallida — así es como pytest sabe si un test pasó o no. | sección 2 |
Endpoint de salud (/health/live) | Ruta que expone un servicio solo para confirmar que está vivo y respondiendo, sin lógica de negocio. Es el ejemplo típico para el primer test automatizado de un pipeline. | sección 2 |
| Docker build | Paso del pipeline que construye la imagen a partir del Dockerfile (ver Clase 10, sección 3). | sección 3 |
| Docker tag | Comando que le da un nombre/etiqueta a una imagen ya construida, antes de subirla a un registro (p. ej. docker tag orders-service:latest <repo-ecr>:abc75d). | sección 3 |
| Amazon ECR (Elastic Container Registry) | Registro de imágenes Docker de AWS — el equivalente de Docker Hub, pero privado y dentro de la infraestructura de AWS. Ahí se sube (push) la imagen que luego consumirá el servicio que la despliega (p. ej. ECS Fargate). | sección 3 |
| SHA del commit | Identificador único que Git le asigna a cada commit. Usarlo como tag de la imagen (en vez de latest) permite saber, mirando el tag, exactamente qué código quedó empaquetado en esa imagen. | sección 3 |
git rev-parse --short HEAD | Comando de Git que imprime la versión corta (7 caracteres) del SHA del commit actual — el valor típico que se usa como tag de la imagen. | sección 3 |
| Amazon ECS (Elastic Container Service) | Servicio de AWS que ejecuta y orquesta contenedores (a diferencia de ECR, que solo los almacena). Decide dónde y cuántas copias de un contenedor corren. | sección 4 |
| Fargate | Motor serverless de ECS: ejecuta los contenedores sin que haya que administrar las instancias EC2 subyacentes (no hay servidor que aprovisionar ni parchear). | sección 4 |
| Cluster (ECS) | Agrupa capacidad y servicios de ECS — el contenedor lógico que organiza todo lo demás (no confundir con el Cluster de Kubernetes de la Clase 10). | sección 4 |
| Task Definition | Plantilla que describe cómo ejecutar los contenedores: qué imagen usar, cuánta CPU/memoria asignar, qué variables de entorno pasar. | sección 4 |
| Service (ECS) | Mantiene el número deseado de Tasks en ejecución y gestiona las actualizaciones sin tiempo de caída (no confundir con el Service de Kubernetes). | sección 4 |
| OIDC (OpenID Connect) | Protocolo que le permite a GitHub Actions obtener credenciales temporales de AWS asumiendo un rol IAM, en vez de usar credenciales de larga duración guardadas como secret. | sección 5 |
| Rol IAM (assumable role) | Identidad de AWS que no tiene credenciales propias fijas, sino que otros (como GitHub, vía OIDC) pueden "asumir" temporalmente para operar con sus permisos. | sección 5 |
permissions: id-token: write | Permiso que se declara en el workflow de GitHub Actions para que ese job pueda solicitar un token OIDC. | sección 5 |
aws-actions/configure-aws-credentials | Action oficial de AWS para GitHub Actions que, dado un rol (role-to-assume), intercambia el token OIDC por credenciales temporales de AWS. | sección 5 |
| OrderFlow | El proyecto final del curso (diseñado en la Clase 5, sección 7): el sistema de microservicios sobre el que se aplica, en esta clase, el pipeline de CI/CD completo. | sección 6 |
🧪 2. Pruebas automatizadas con pytest en el pipeline
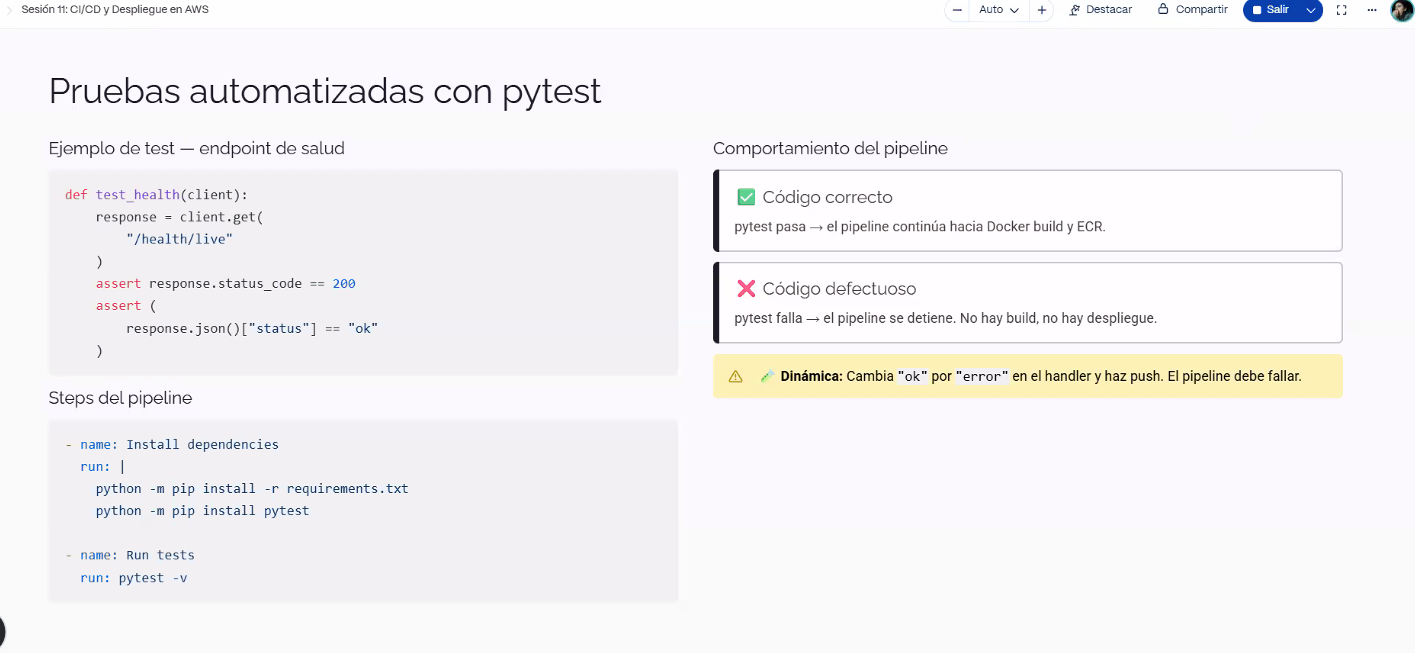
La idea central: el pipeline no avanza a menos que las pruebas pasen. Antes de construir la imagen Docker y subirla a un registro, el pipeline corre los tests del proyecto — si alguno falla, ahí se corta todo.
Ejemplo de test sobre el endpoint de salud del servicio:
python
def test_health(client):
    response = client.get(
        "/health/live"
    )
    assert response.status_code == 200
    assert (
        response.json()["status"] == "ok"
    )
Este test hace dos verificaciones sobre la respuesta del endpoint /health/live:
- Que el código de estado HTTP sea
200(la petición se resolvió bien). - Que el cuerpo de la respuesta tenga
"status": "ok"(el servicio se declara sano a sí mismo, no solo que respondió).
Los steps correspondientes en el pipeline (instalar dependencias y correr pytest):
yaml
- name: Install dependencies
  run: |
    python -m pip install -r requirements.txt
    python -m pip install pytest

- name: Run tests
  run: pytest -v
Comportamiento del pipeline según el resultado de los tests:
Resultado de pytest | Qué pasa en el pipeline |
|---|---|
| ✅ Código correcto | pytest pasa → el pipeline continúa hacia docker build y el push a ECR. |
| ❌ Código defectuoso | pytest falla → el pipeline se detiene ahí mismo. No hay build, no hay despliegue. |
⚠️ Dinámica propuesta en la clase: cambiar el valor
"ok"por"error"en el handler del endpoint de salud y hacergit push. El pipeline debería fallar en el step de tests, sin llegar a construir ni desplegar la imagen — es la forma más directa de comprobar en vivo que el pipeline realmente bloquea código roto.
🗺️ Diagrama: pruebas automatizadas con pytest y comportamiento del pipeline
📦 3. Amazon ECR — registro de imágenes en la nube
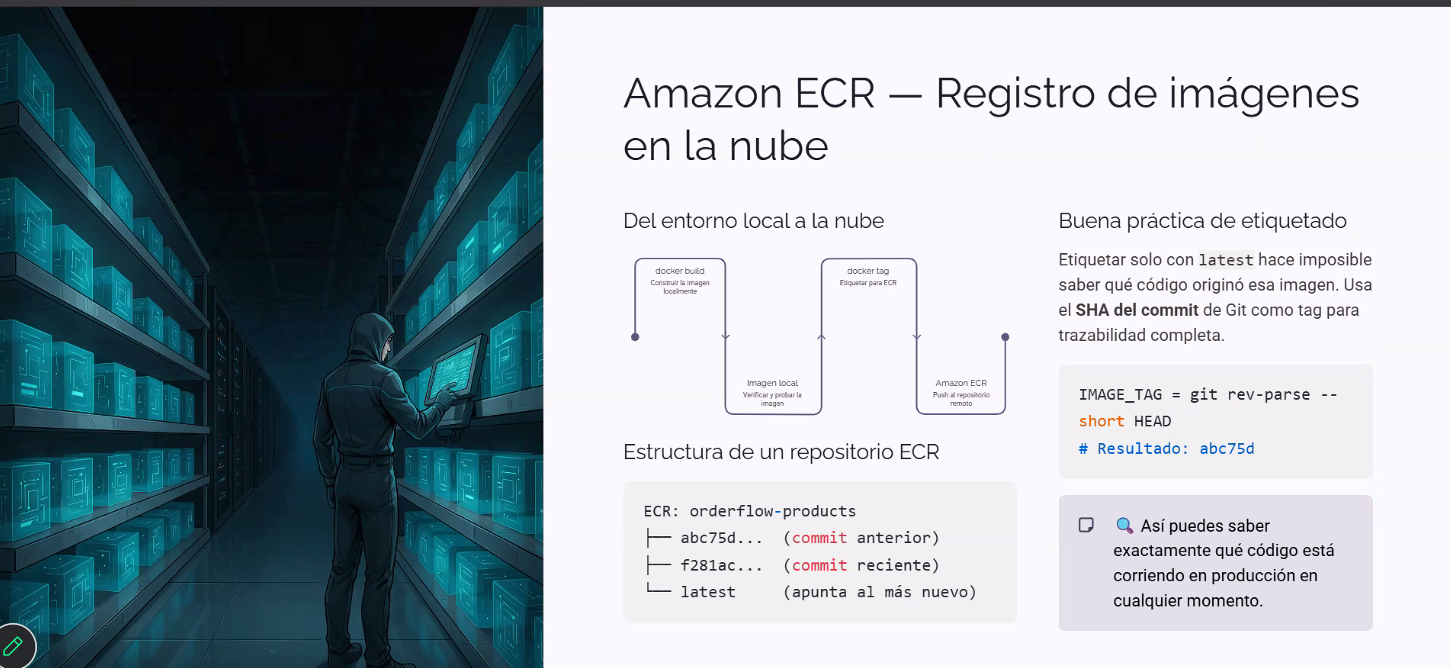
Una vez que el pipeline pasó las pruebas, el flujo para publicar la imagen es:
text
docker build              docker tag                 push a ECR
(construir la imagen  →   (etiquetar para ECR)   →   (subir al repositorio
 localmente)                                          remoto de Amazon ECR)
     │                          │                            │
     ▼                          ▼                            ▼
Imagen local              Imagen local            Amazon ECR
(verificar y probar       lista, apuntando a      (repositorio remoto)
 la imagen)                un repo de ECR
Buena práctica de etiquetado: etiquetar la imagen solo con latest hace imposible saber después qué código originó esa imagen en concreto. La práctica correcta es usar el SHA del commit de Git como tag, para trazabilidad completa:
bash
IMAGE_TAG=$(git rev-parse --short HEAD)
# Resultado: abc75d
Con eso, un repositorio ECR típico queda con varias imágenes etiquetadas por commit, más un tag latest que siempre apunta a la más reciente:
text
ECR: orderflow-products
├── abc75d...   (commit anterior)
├── f281ac...   (commit reciente)
└── latest      (apunta al más nuevo)
💡 Así se puede saber exactamente qué código está corriendo en producción en cualquier momento — algo que con solo
latestno es posible, porque ese tag se sobrescribe en cada push y pierde el historial de qué versión representaba antes.
🧪 Tip de entrevista: ¿por qué no alcanza con etiquetar siempre
latest? Porquelatestes un puntero que se mueve — no es una versión fija. Si algo falla en producción,latestno te dice qué commit generó esa imagen; el SHA del commit sí, y por eso es la etiqueta que da trazabilidad real.
🗺️ Diagrama: Amazon ECR — flujo y estructura del repositorio
🚀 4. Amazon ECS Fargate — ejecutar contenedores sin gestionar servidores
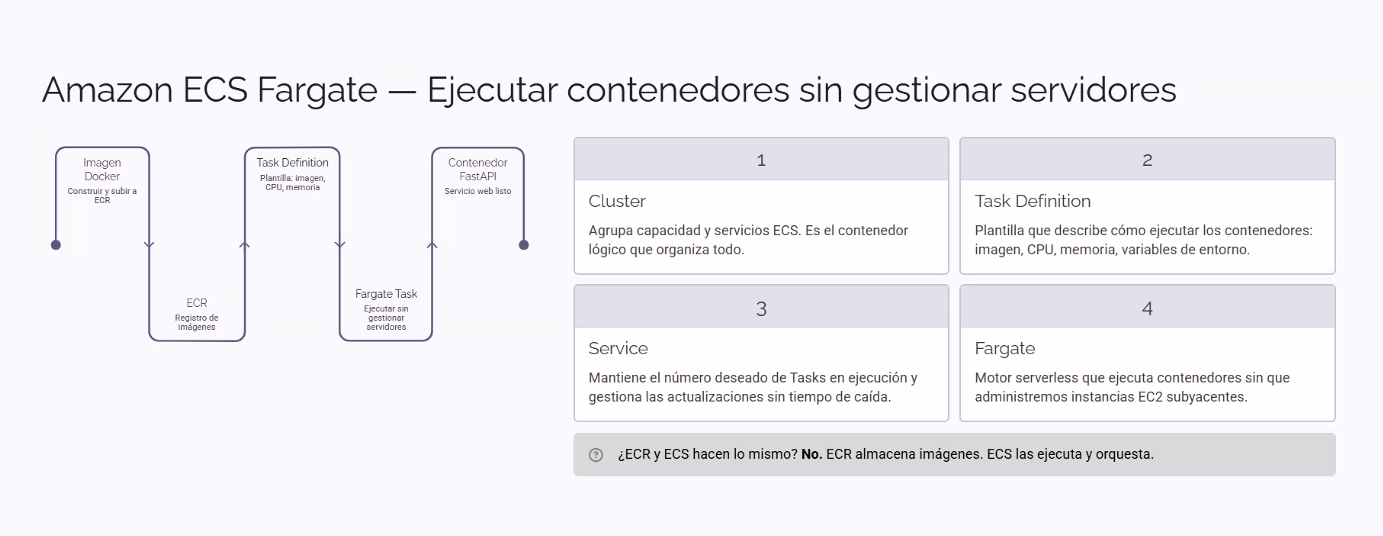
Una vez que la imagen está en ECR, alguien tiene que ejecutarla. Ese "alguien" es ECS (Elastic Container Service), y Fargate es el motor que lo hace sin necesidad de administrar servidores propios:
text
Imagen Docker        ECR                Task Definition      Fargate Task        Contenedor FastAPI
(construir y     →   (registro de   →   (plantilla:      →   (ejecutar sin   →   (servicio web
 subir a ECR)         imágenes)          imagen, CPU,          gestionar            listo)
                                          memoria)              servidores)
Las cuatro piezas del rompecabezas:
| Pieza | Qué hace |
|---|---|
| Cluster | Agrupa capacidad y servicios ECS. Es el contenedor lógico que organiza todo. |
| Task Definition | Plantilla que describe cómo ejecutar los contenedores: imagen, CPU, memoria, variables de entorno. |
| Service | Mantiene el número deseado de Tasks en ejecución y gestiona las actualizaciones sin tiempo de caída. |
| Fargate | Motor serverless que ejecuta contenedores sin que administremos instancias EC2 subyacentes. |
❓ ¿ECR y ECS hacen lo mismo? No. ECR almacena imágenes. ECS las ejecuta y orquesta. Uno es el almacén, el otro es quien pone a correr lo que hay en el almacén.
🧪 Tip de entrevista: ¿qué diferencia a Fargate de "ECS a secas"? ECS es el orquestador; puede correr sobre instancias EC2 que vos administrás, o sobre Fargate, que es el modo serverless de ECS: no hay servidor que aprovisionar, parchear ni escalar a mano — AWS se encarga de la capa de infraestructura.
🗺️ Diagrama: Amazon ECS Fargate — de la imagen Docker al contenedor corriendo
🔐 5. Autenticación segura: GitHub → AWS con OIDC
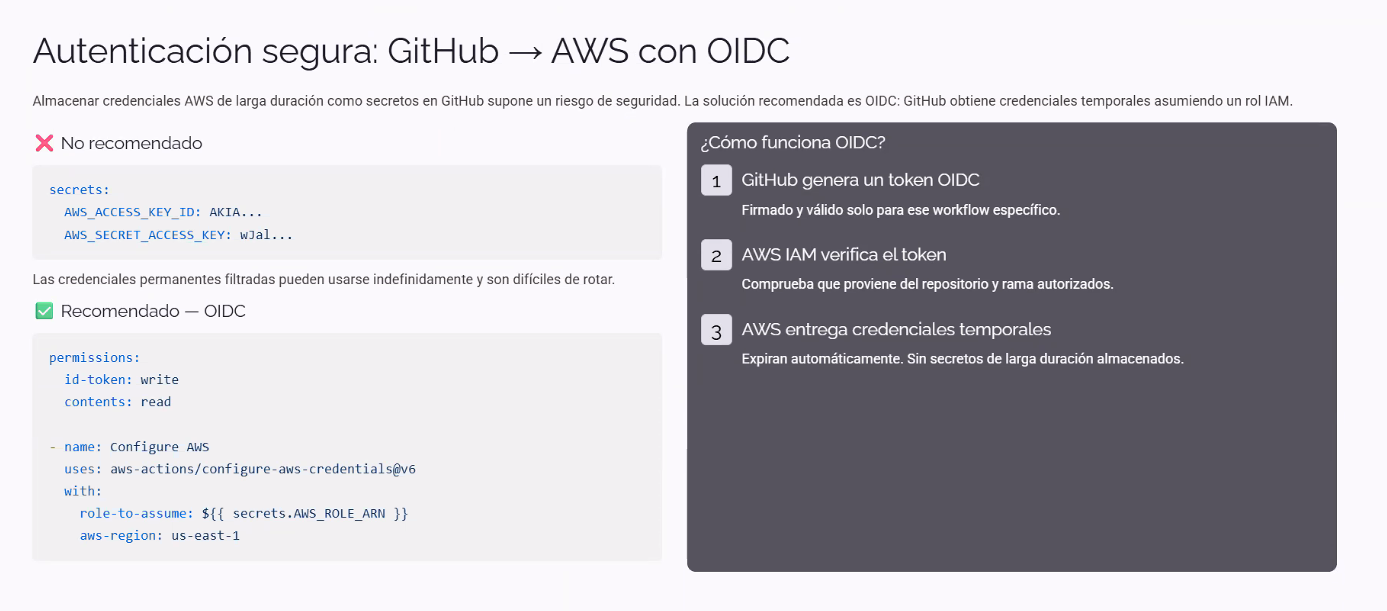
El pipeline necesita credenciales de AWS para poder hacer push a ECR y desplegar en ECS. El problema es cómo dárselas sin exponer un riesgo de seguridad.
❌ No recomendado — credenciales de larga duración como secret:
yaml
secrets:
  AWS_ACCESS_KEY_ID: AKIA...
  AWS_SECRET_ACCESS_KEY: wJal...
El riesgo: si estas credenciales se filtran (un log mal armado, un fork del repo, un secret mal configurado), pueden usarse indefinidamente y son difíciles de rotar — quien las tenga puede operar como si fuera vos hasta que alguien note la fuga y las revoque a mano.
✅ Recomendado — OIDC (OpenID Connect):
yaml
permissions:
  id-token: write
  contents: read

- name: Configure AWS
  uses: aws-actions/configure-aws-credentials@v6
  with:
    role-to-assume: ${{ secrets.AWS_ROLE_ARN }}
    aws-region: us-east-1
Con OIDC, GitHub no guarda ninguna clave de AWS. En su lugar, obtiene credenciales temporales asumiendo un rol IAM, en tres pasos:
| Paso | Qué pasa |
|---|---|
| 1. GitHub genera un token OIDC | Firmado y válido solo para ese workflow específico. |
| 2. AWS IAM verifica el token | Comprueba que proviene del repositorio y la rama autorizados. |
| 3. AWS entrega credenciales temporales | Expiran automáticamente. Sin secrets de larga duración almacenados. |
⚠️ Notar que en el ejemplo recomendado el único secret que queda en GitHub es
AWS_ROLE_ARN— y eso no es una credencial en sí misma, es solo el identificador del rol que IAM va a verificar. Sin el token OIDC firmado por GitHub para ese workflow puntual, ese ARN no le sirve a nadie.
🧪 Tip de entrevista: ¿por qué OIDC es más seguro que guardar
AWS_SECRET_ACCESS_KEYcomo secret? Porque una credencial de larga duración, una vez filtrada, sigue siendo válida hasta que alguien la rota a mano. Con OIDC no hay credencial que filtrar: el token lo emite GitHub por workflow, AWS lo valida contra el repo/rama exactos, y la credencial que entrega expira sola.
🗺️ Diagrama: autenticación GitHub Actions → AWS con OIDC
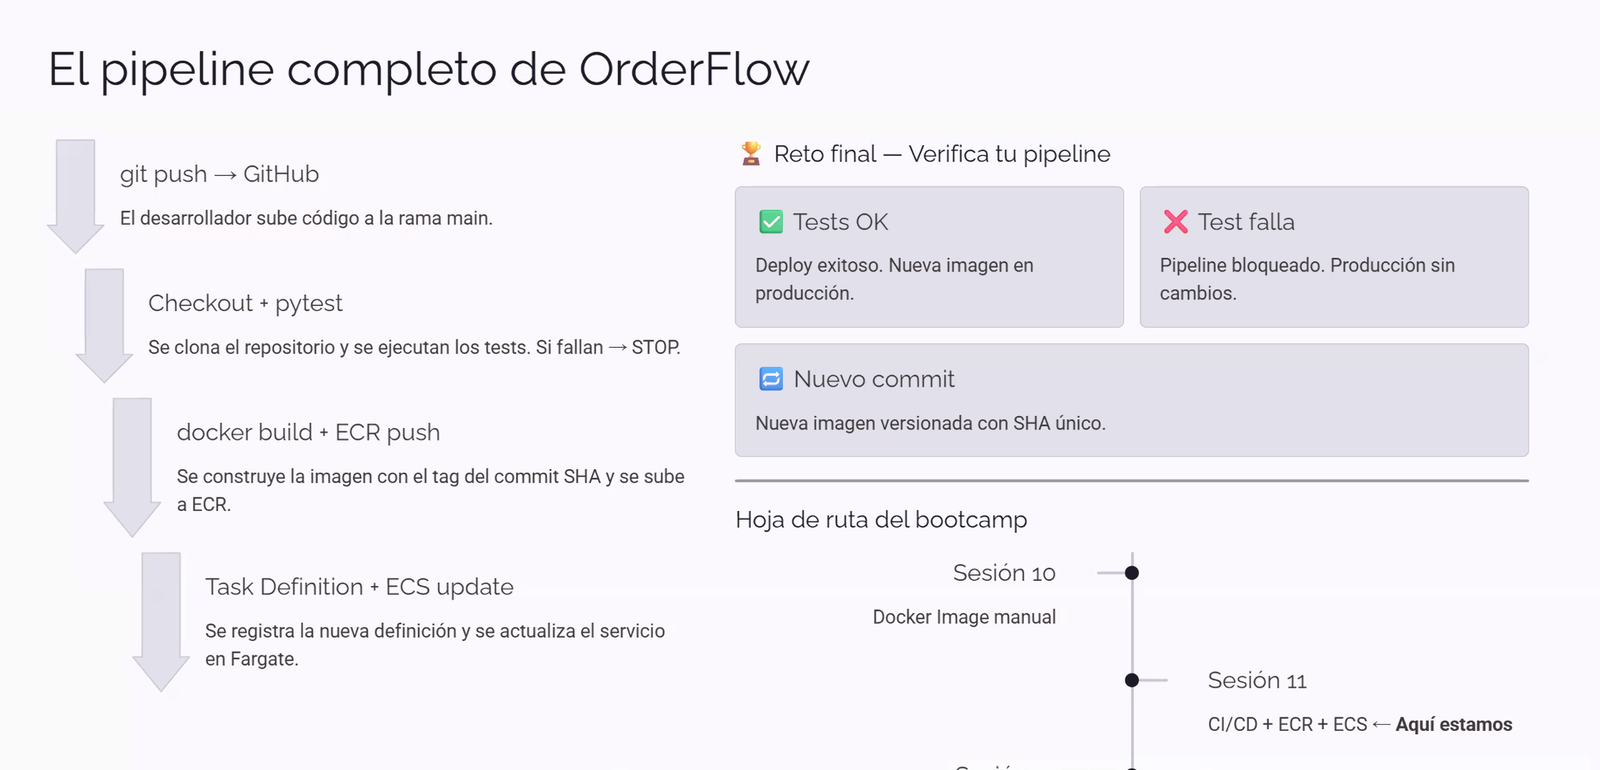
🔁 6. El pipeline completo de OrderFlow
Uniendo todo lo anterior (pytest, ECR, ECS Fargate, OIDC), así queda el pipeline de punta a punta aplicado al proyecto final OrderFlow:
text
1. git push → GitHub
   El desarrollador sube código a la rama main.
        │
        ▼
2. Checkout + pytest
   Se clona el repositorio y se ejecutan los tests. Si fallan → STOP.
        │
        ▼
3. docker build + ECR push
   Se construye la imagen con el tag del commit SHA y se sube a ECR.
        │
        ▼
4. Task Definition + ECS update
   Se registra la nueva definición y se actualiza el servicio en Fargate.
Cada uno de estos 4 pasos ya se vio por separado: el step 2 es la sección 2 (pytest), el step 3 combina las secciones 3 y 5 (ECR + OIDC para autenticarse), y el step 4 es la sección 4 (ECS Fargate). Lo nuevo acá es verlos encadenados como un solo pipeline, donde cada paso depende de que el anterior haya salido bien.
🏆 Reto final — verifica tu pipeline:
| Situación | Qué debería pasar |
|---|---|
| ✅ Tests OK | Deploy exitoso. Nueva imagen en producción. |
| ❌ Test falla | Pipeline bloqueado. Producción sin cambios. |
| 🔁 Nuevo commit | Nueva imagen versionada con SHA único. |
💡 Este es el mismo comportamiento de la sección 2 (pytest bloquea el pipeline si falla) pero visto ahora sobre el pipeline completo: un test roto no solo detiene "los tests", detiene todo el camino hacia producción — no llega a construirse la imagen, no se sube a ECR, no se actualiza ECS.
Hoja de ruta del bootcamp (dónde encaja esta clase):
text
Sesión 10 ──────────────── Sesión 11 (Aquí estamos)
Docker Image manual        CI/CD + ECR + ECS
(build/run a mano)         (todo automatizado en el pipeline)
📌 La Clase 10 dejó la imagen Docker lista pero el build/push era manual; esta clase automatiza exactamente esa parte manual dentro de un pipeline de CI/CD.
🗺️ Diagrama: pipeline completo de OrderFlow + reto final + hoja de ruta
💻 PARTE PRÁCTICA
🖱️ 7. Desplegar OrderFlow en AWS ECS Fargate — paso a paso en la consola
Recorrido real en la consola de AWS para crear la infraestructura de ECS a la que va a apuntar el pipeline de la sección 6. (en progreso — se amplía con cada paso a medida que avanza la clase)
1) Entrar a Amazon ECS y abrir "Clusters" — desde el buscador de servicios de AWS se llega a la landing de Amazon Elastic Container Service (/ecs/v2/getStarted); en el menú lateral, Clusters es donde se crea el cluster que va a alojar el Service y las Tasks de OrderFlow (ver glosario, sección 1):
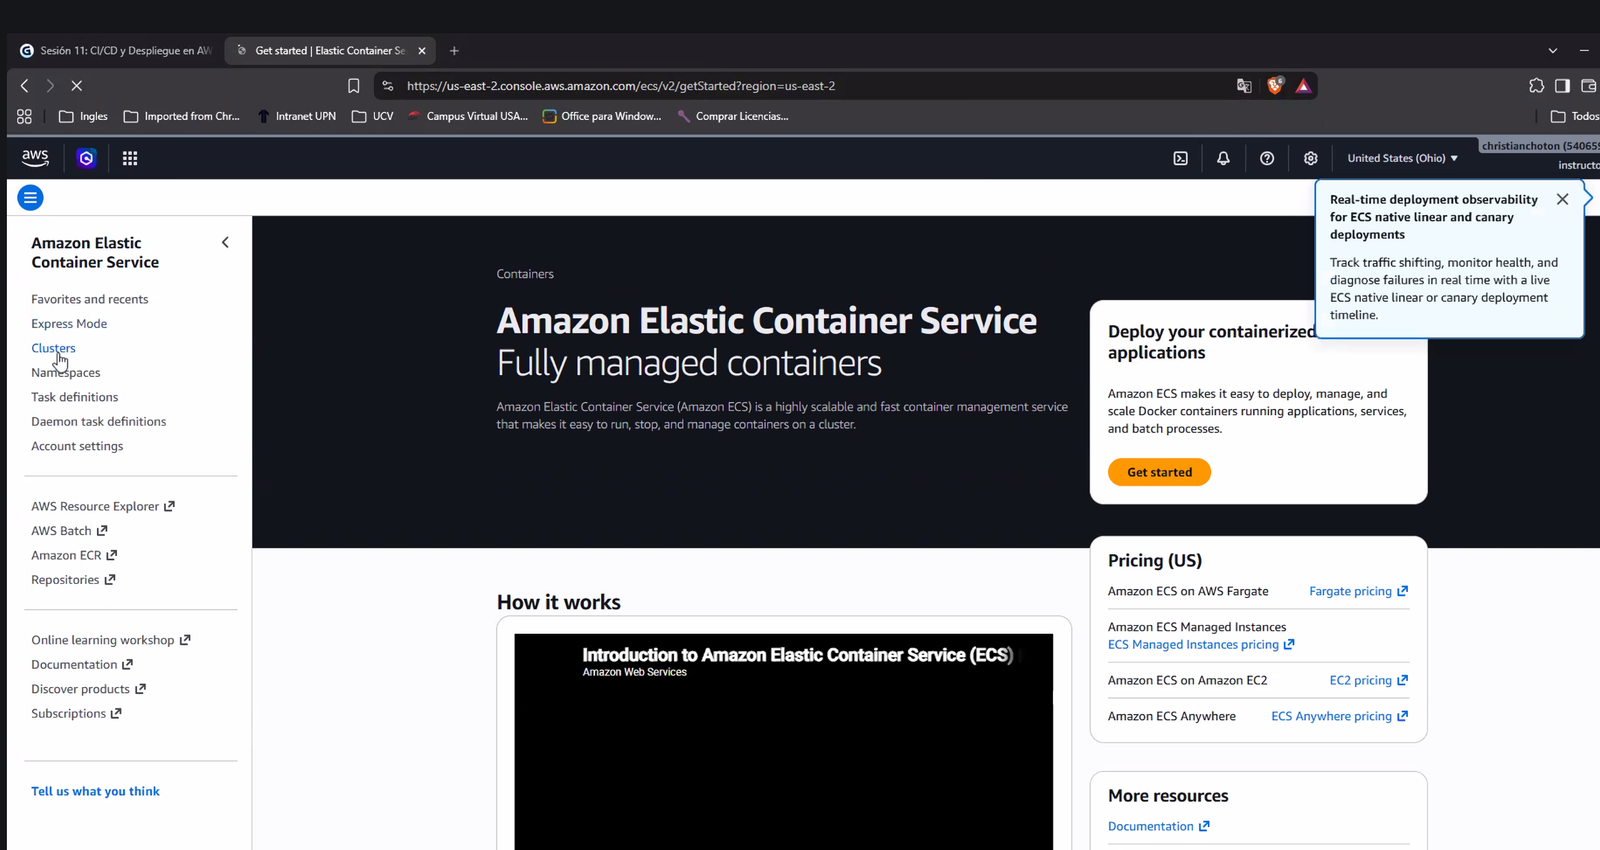
📝 La región activa en este paso es
United States (Ohio)(us-east-2) — distinta deus-east-1usada como ejemplo en el fragmento de la sección 5 (aws-region: us-east-1). Al terminar el recorrido real, ajustar ese valor del workflow para que coincida con la región donde termine viviendo el cluster.
🏋️ EJERCICIOS CON SOLUCIÓN
(pendiente — 10 ejercicios graduales)
❓ Preguntas y respuestas (autoevaluación)
(pendiente — 10 preguntas graduales)
📎 Apuntes relacionados
(pendiente)