Apariencia
📙 Clase 12 — Integración con IA y proyecto final
Python para Backend · 2026-09-15 · Carpeta:
02-Ejercicios/Clase-12⬅️ Volver al índice de clases
🎯 Qué aprendí (según temario — se amplía a medida que avanza la clase)
- ✅ El reto final de
OrderFlow: pasar de las características técnicas de un producto (las que ya carga el sistema) a una descripción comercial lista para publicar, generada con IA. - ✅ Los 4 riesgos concretos que hay que evitar al meter un proveedor de IA en el sistema: exponer API keys, enviarle datos sensibles, dejar que invente datos, y acoplar todo el proyecto directamente a ese proveedor.
- ✅ Cómo construir el prompt para que la IA redacte en vez de inventar: solo datos verificados + restricción explícita ("No inventes especificaciones").
- ✅ La fórmula de un prompt seguro —
DATOS + INSTRUCCIÓN + RESTRICCIONES— y cómo elProductRequest(JSON verificado) se convierte, campo por campo, en el texto final que recibe la IA. - ✅ La arquitectura del AI Service: Prompt Builder + Provider Interface (patrón Adapter) para no acoplar
OrderFlowa un proveedor de IA específico — cambiar de Gemini a OpenAI es cambiar una variable de entorno, no reescribir código. - ✅ Por qué una API key nunca va hardcodeada en el código ni sube a GitHub (ni a un repo privado): expone a
OrderFlowa costos, abuso y brechas de seguridad, y borrar el commit no alcanza (queda en el historial de Git). - ✅ Código real del Provider Interface para Gemini (
google-genai) y OpenAI (Responses API) — misma forma (client+.create(model, prompt)+.output_text), lo que permite exponerlos detrás de una sola interfaz genérica. - ✅ La arquitectura final de
OrderFlow: cómo encajan las 12 clases del curso en un solo sistema (Cliente → API Gateway/Lambda/DynamoDB → microservicios sobre PostgreSQL → SNS/SQS → AI Service → CI/CD hacia ECS Fargate). - ✅ Cómo sí manejar la API key en producción: AWS Systems Manager Parameter Store (
SecureString) + bloquesecretsen el Task Definition de ECS — nunca enenvironment, nunca en el.envque se sube al repo. - ✅ Cómo se limita qué puede viajar en el prompt: validación de longitud/tipo en el schema (
Field(max_length=...)) + unSYSTEM_GUIDANCEfijo que restringe el contenido de la respuesta (nada médico/legal/financiero, solo español). - 🔜 Presentación del proyecto
- 🔜 Despliegue final en AWS
- 🔜 Buenas prácticas para producción
🗺️ Índice
- 📖 PARTE TEÓRICA
- 💻 PARTE PRÁCTICA
- 🏋️ 9. EJERCICIOS CON SOLUCIÓN
- Ejercicio 1 — Levantar el servicio y confirmar el health check
- Ejercicio 2 — Confirmar el error real sin API key configurada
- Ejercicio 3 — features vacío
- Ejercicio 4 — Más de 8 características
- Ejercicio 5 — name demasiado corto
- Ejercicio 6 — Valores por defecto de audience y tone
- Ejercicio 7 — Construir tu propio prompt
- Ejercicio 8 — Confirmar las restricciones del SYSTEM_GUIDANCE
- Ejercicio 9 — Proveedor no soportado
- Ejercicio 10 — OpenAI sin su API key
- Ejercicio 11 — AI_PROVIDER no distingue mayúsculas ni espacios
- Ejercicio 12 — Testear el endpoint sin llamar a ninguna IA real
- Ejercicio 13 — Cuando el proveedor falla con un error inesperado
- Ejercicio 14 — AIProvider no se puede instanciar directamente
- Ejercicio 15 — Una subclase incompleta tampoco se puede instanciar
- Ejercicio 16 — Implementa un EchoProvider
- Ejercicio 17 — Registra EchoProvider en el factory
- Ejercicio 18 — Avanzado: límite de longitud combinada en features
- Ejercicio 19 — Analiza el Dockerfile y el Task Definition (sin ejecutar)
- Ejercicio 20 — Reto final: límite de palabras configurable
- Ejercicio 21 — La instrucción final siempre está presente
- Ejercicio 22 — Boundary: el mínimo de features (1 elemento)
- Ejercicio 23 — Boundary: el máximo de features (8 elementos)
- Ejercicio 24 — Boundary: category de 2 caracteres exactos
- Ejercicio 25 — Boundary: audience/tone en su longitud máxima
- Ejercicio 26 — Prompt con público infantil y tono divertido
- Ejercicio 27 — Prompt con público técnico y tono formal
- Ejercicio 28 — El Prompt Builder es determinista (a diferencia de la IA)
- Ejercicio 29 — Los tres campos de la respuesta, siempre los mismos
- Ejercicio 30 — Dos providers mockeados, misma interfaz
- Ejercicio 31 — Medí cuánto tarda la llamada al proveedor
- Ejercicio 32 — Otro tipo de falla del proveedor: ConnectionError
- Ejercicio 33 — Postman: armar la request de un caso de error
- Ejercicio 34 — Postman: una variable con el JSON completo
- Ejercicio 35 — Confirmá que GEMINI_MODEL se refleja en la respuesta
- Ejercicio 36 — Reto: un cuarto proveedor real (estructura, sin llamar a nada externo)
- Ejercicio 37 — Reto: registrar el cuarto proveedor en el factory
- Ejercicio 38 — Comparar los 4 providers uno al lado del otro
- Ejercicio 39 — Reto: un producto con datos al límite de todo a la vez
- Ejercicio 40 — Reto final: pipeline completo con un producto propio
- ❓ Preguntas y respuestas (autoevaluación)
- 📎 Apuntes relacionados
- ➡️ Siguiente
📖 PARTE TEÓRICA
📚 1. Definiciones clave
| Término | Qué es | Se profundiza en |
|---|---|---|
| OrderFlow | El proyecto final del curso (diseñado en la Clase 5, sección 7): ya crea usuarios/productos/pedidos, gestiona inventario, publica eventos y corre en AWS con CI/CD (ver Clase 11). Esta clase le agrega la última pieza: generación de contenido con IA. | sección 2 |
| Descripción comercial | El texto de venta de un producto (el que ve el cliente en el catálogo), a diferencia de sus características (los datos técnicos/estructurados que ya tiene cargados el sistema: talla, material, stock, etc.). El reto de la clase es convertir lo segundo en lo primero, automáticamente. | sección 2 |
| API key | Credencial secreta que identifica a la aplicación ante el proveedor de IA (OpenAI, Gemini) para poder llamar a su API. Si queda expuesta (p. ej. subida por error a GitHub), cualquiera puede usarla a nombre de OrderFlow y generar cargos o abusos. | sección 2 |
| Dato sensible | Cualquier información que no debería salir del sistema hacia un tercero (datos personales de clientes, precios de costo, credenciales, etc.). Al armar el prompt que se envía a la IA hay que asegurarse de no incluir nada de esto. | sección 2 |
| Alucinación de la IA | Cuando el modelo de IA "inventa" datos que no le fueron dados (una característica del producto que no existe, un precio, una talla) porque genera texto plausible, no verificado. Es uno de los riesgos a evitar al generar la descripción comercial. | sección 2 |
| Acoplamiento directo al proveedor (vendor lock-in) | Diseñar el código de OrderFlow para que solo pueda hablar con un proveedor de IA específico (p. ej. llamando al SDK de OpenAI desde todos lados). Si mañana se cambia de proveedor, hay que reescribir toda la integración. | sección 2 |
| Prompt | El texto de instrucción + datos que se le envía al modelo de IA para que genere una respuesta. Cómo se construye (qué datos incluye, qué restricciones pone) determina si la IA "redacta" o "inventa". | sección 3 |
| Fuente de verdad (source of truth) | El lugar del que salen los datos reales y confiables de un sistema — en OrderFlow es siempre la base de datos/el catálogo, nunca la IA. La IA solo transforma esos datos en lenguaje comercial, no los reemplaza ni los complementa por su cuenta. | sección 3 |
ProductRequest | El payload (JSON) que arma OrderFlow con los datos verificados de un producto (name, category, features, audience, tone) antes de pasarlo al Prompt Builder. Es la única fuente de la que el prompt puede tomar información. | sección 3 |
| AI Service | El microservicio nuevo de OrderFlow (mismo patrón que users_service/products_service de la Clase 6) dedicado a generar la descripción comercial. Actúa como capa de abstracción entre la lógica de negocio y los proveedores externos de IA. | sección 4 |
| Prompt Builder | Componente interno del AI Service que arma el prompt final (ver glosario, sección 1) a partir del ProductRequest recibido — es el punto donde se aplican las reglas de la sección 3 (solo datos verificados + restricción explícita). | sección 4 |
| Provider Interface (patrón Adapter) | Capa que abstrae al proveedor de IA real: expone un método genérico (p. ej. generar_descripcion(prompt)) que internamente delega a Gemini u OpenAI según configuración, sin que el resto del código sepa cuál de los dos está activo. | sección 4 |
Variable de entorno AI_PROVIDER | Configuración (mismo mecanismo que Clase 1 §14) que decide en tiempo de ejecución qué proveedor usa el Provider Interface (AI_PROVIDER=gemini o AI_PROVIDER=openai) — cambiar de proveedor es cambiar un valor, no reescribir código. | sección 4 |
| Hardcodear una API key | Escribir el valor real de la credencial directamente en el código fuente (API_KEY = "Alza...") en vez de leerlo desde una variable de entorno. El problema no es solo el estilo: si ese archivo se sube a GitHub (público o privado), la clave queda expuesta para siempre en el historial de commits, aunque se borre después. | sección 5 |
SDK google-genai | Librería oficial de Google para llamar a Gemini desde Python (from google import genai). Expone un Client que se autentica con api_key y un método .interactions.create(...) para generar texto. | sección 6 |
| OpenAI Responses API | Interfaz oficial más reciente del SDK de OpenAI (from openai import OpenAI) para generar texto: un client.responses.create(...) que recibe model, instructions (system prompt) e input (el prompt). | sección 6 |
ABC (Abstract Base Class) | Mecánica de Python (from abc import ABC, abstractmethod) para declarar una clase que no se puede instanciar directamente y que obliga a sus subclases a implementar ciertos métodos (@abstractmethod). Es la forma "de libro" de escribir el Provider Interface: AIProvider(ABC) con generate() abstracto. | Parte práctica |
| Factory (patrón) | Función que decide, en tiempo de ejecución, qué clase concreta instanciar a partir de una configuración (get_ai_provider() lee AI_PROVIDER y devuelve GeminiProvider u OpenAIProvider). Es el mecanismo que hace realidad el Provider Interface de la sección 4. | Parte práctica |
| AWS Systems Manager Parameter Store | Servicio de AWS para guardar configuración y secretos (SecureString) fuera del código. En el Task Definition de ECS, un secreto ahí referenciado se inyecta cifrado como variable de entorno en tiempo de ejecución — nunca queda en el .env, el código o la imagen Docker. | Parte práctica |
🎯 2. El reto: de características a descripción comercial
OrderFlow ya domina el ciclo operativo completo del negocio: crear usuarios, productos y pedidos; gestionar inventario y publicar eventos (ver Clase 9); y ejecutarse en AWS con CI/CD (ver Clase 11).
Lo que falta es la última milla, orientada al negocio y no a la operación: cuando se carga un producto nuevo, sus características son datos técnicos y estructurados (material, talla, especificaciones), pero el catálogo necesita una descripción comercial — un texto atractivo, listo para publicar, que use esas características como base sin inventar nada y sin comprometer la seguridad del sistema.
🗺️ Diagrama: el nuevo flujo con IA
El flujo que propone la clase tiene 4 pasos, y el punto clave es que la IA no reemplaza los datos verificados: los redacta.
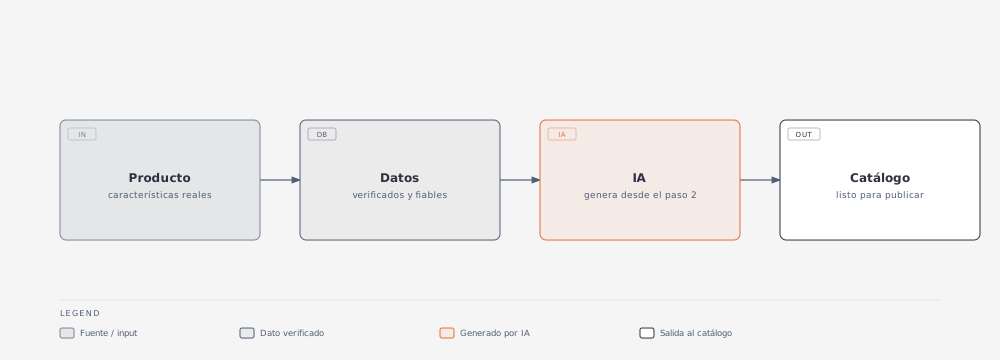
💡 La IA entra recién en el paso 3, y solo con los datos ya verificados del paso 2 como entrada. Esa es la diferencia entre "pedirle a la IA que describa el producto" (riesgo de que invente) y "pedirle que redacte a partir de estos datos exactos" (control de lo que puede decir).
⚠️ Qué debemos evitar
| Riesgo | Por qué importa | Se resuelve en |
|---|---|---|
| ❌ API keys expuestas en GitHub | Cualquiera con la key puede usar la cuenta de IA de OrderFlow a su nombre (costo, abuso, cuota agotada). | sección 5 |
| ❌ Datos sensibles enviados al proveedor | El prompt que arma OrderFlow viaja a un servidor externo (OpenAI/Gemini) — no debe llevar datos personales de clientes ni información de costo interna. | Parte práctica |
| ❌ Información inventada por la IA | Si se le pide "describí este producto" sin pasarle las características reales, puede alucinar datos falsos en la descripción comercial. | sección 3 |
| ❌ Dependencia directa del proveedor de IA | Si el código llama al SDK de un solo proveedor en todos lados, cambiar de proveedor implica reescribir la integración completa. | sección 4 |
📝 Las 4 filas ya se resuelven: "Información inventada por la IA" en la sección 3, "Dependencia directa del proveedor de IA" en la sección 4, "API keys expuestas en GitHub" en la sección 5, y "Datos sensibles enviados al proveedor" en la Parte práctica (validación de longitud +
SYSTEM_GUIDANCE).
🧠 3. ¿Dónde y cómo usar IA? (prompt bien construido)
La idea central de esta sección conecta directo con el diagrama de la sección 2: la IA es una herramienta para enriquecer datos verificados, no para inventar información. La fuente de verdad del catálogo siempre es el sistema (la base de datos de OrderFlow) — la IA solo transforma esos datos en lenguaje comercial, nunca los genera desde cero.
Esto se traduce en cómo se construye el prompt que se le manda a la IA:
| Enfoque | Qué pasa | |
|---|---|---|
| ❌ Mal uso del prompt | "Invéntame una descripción interesante de esta laptop" | Delega la fuente de verdad a la IA: genera información potencialmente falsa o inconsistente con el inventario real (alucinación, ver glosario). |
| ✅ Prompt bien construido | Enviar únicamente información verificada: nombre del producto y categoría, características técnicas reales, público objetivo y tono deseado — más la restricción explícita "No inventes especificaciones." | La IA redacta a partir de datos exactos; no tiene margen para completar huecos con información propia. |
⚠️ La IA nunca debe ser la fuente de verdad del catálogo. El sistema es la fuente de verdad; la IA es el transformador de lenguaje. Esta es la regla que resuelve el riesgo "información inventada por la IA" de la sección 2.
🧪 Tip de entrevista: si te preguntan cómo evitar alucinaciones al integrar un LLM en un flujo de negocio, la respuesta corta es "restringir el prompt a datos verificados + instrucción explícita de no inventar" — no "usar un modelo mejor" (ningún modelo garantiza cero alucinaciones si el prompt le deja margen para inventar).
🧩 Construcción segura del prompt: la fórmula
Un prompt bien construido tiene tres componentes: datos verificados del sistema, una instrucción clara de qué generar, y restricciones explícitas sobre qué no hacer. Ejemplo real de cómo el ProductRequest (ver glosario, sección 1) se convierte en el prompt que recibe la IA:
Request de entrada (ProductRequest, ya verificado por OrderFlow):
json
{
  "name": "Laptop Pro 14",
  "category": "Laptops",
  "features": [
    "16 GB RAM",
    "512 GB SSD",
    "Pantalla 14 pulgadas"
  ],
  "audience": "profesionales",
  "tone": "profesional"
}
Prompt generado por el Prompt Builder (sección 4) a partir de ese JSON:
text
Genera máximo 120 palabras.
Producto: Laptop Pro 14
Características verificadas:
- 16 GB RAM
- 512 GB SSD
- Pantalla 14 pulgadas
No inventes características.
Cada línea del prompt generado viene directo de un campo del JSON — el Prompt Builder no agrega ni interpreta nada que no esté ahí. Esto es lo que convierte la regla abstracta de la tabla anterior ("solo datos verificados + restricción explícita") en código concreto.
📌 La fórmula:
DATOS + INSTRUCCIÓN + RESTRICCIONES = PROMPT SEGURO.
- Datos → las
features,name,categorydelProductRequest(la fuente de verdad, nunca inventados).- Instrucción → qué generar y con qué límite ("Genera máximo 120 palabras").
- Restricciones → qué NO hacer ("No inventes características").
Si al prompt le falta cualquiera de los tres, deja de ser seguro: sin datos, la IA inventa; sin instrucción, el resultado es impredecible (largo, tono, formato); sin restricciones, nada le impide "completar" lo que el JSON no cubre.
🏗️ 4. Arquitectura del AI Service
El AI Service es el microservicio que resuelve el último riesgo pendiente de la sección 2: la dependencia directa del proveedor de IA. Actúa como capa de abstracción entre la lógica de negocio de OrderFlow y los proveedores externos (Gemini, OpenAI) — cambiar de proveedor es cambiar un parámetro de configuración, sin tocar el endpoint ni la lógica del negocio.
🗺️ Diagrama: flujo de una request dentro del AI Service
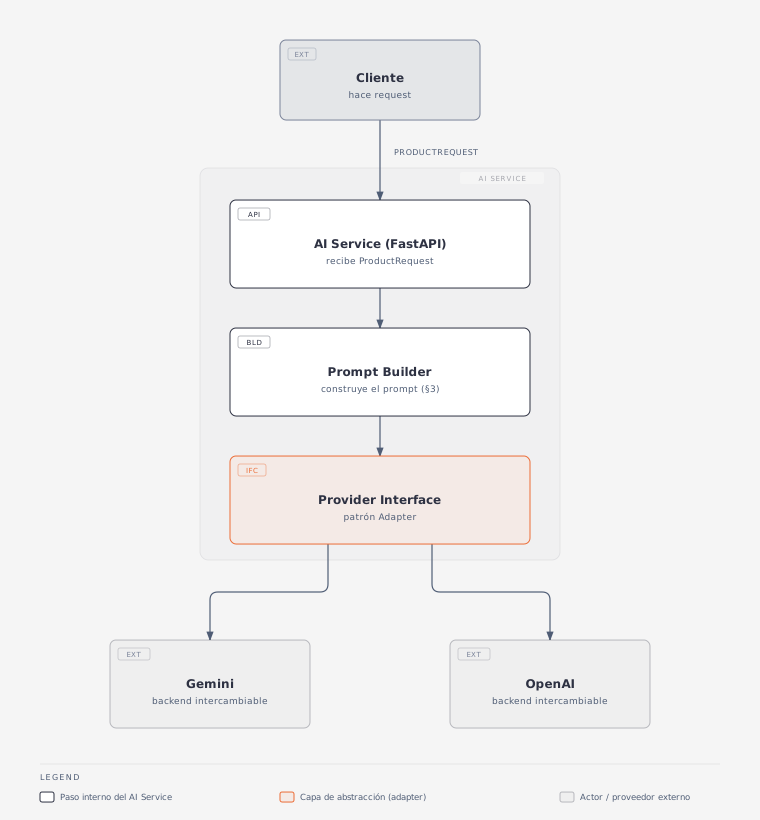
El punto clave de este diagrama: el Prompt Builder y el Provider Interface son dos responsabilidades separadas. El primero decide qué datos entran al prompt (seguridad y calidad de la información — sección 3); el segundo decide a quién se le manda ese prompt (flexibilidad de proveedor — esta sección). Mezclar ambas responsabilidades en un solo lugar del código sería volver a acoplar OrderFlow a un proveedor específico.
🔧 La ventaja clave: un parámetro de configuración, no un redeploy de código
La lógica de negocio no depende directamente de Gemini ni de OpenAI. El proveedor activo se define con una variable de entorno:
bash
# .env del AI Service — cambiar de proveedor es cambiar esta línea
AI_PROVIDER=gemini
# AI_PROVIDER=openai
El endpoint que consume el cliente (POST /descripciones, por ejemplo) permanece idéntico sin importar cuál de los dos esté activo. Solo cambia, por dentro del Provider Interface, qué SDK/cliente HTTP se invoca.
💡 Este es el mismo principio de Repository Pattern que ya se vio con la base de datos en la Clase 4: el código de negocio habla contra una interfaz (
ProductRepository,ProviderInterface), no contra una implementación concreta (PostgreSQL,OpenAI). Cambiar la implementación de atrás no obliga a tocar quien la consume.
🧪 Tip de entrevista: si te preguntan cómo evitar el vendor lock-in al integrar un proveedor externo (de IA, de pagos, de storage), la respuesta es siempre la misma forma: una interfaz propia en el medio (adapter), nunca el SDK del proveedor llamado directo desde la lógica de negocio.
🔐 5. Seguridad en el consumo de APIs de IA
Cierra el último riesgo pendiente de la sección 2: las API keys expuestas en GitHub. La idea de la slide: una API key expuesta no es un descuido menor — puede generar costos inesperados, filtraciones de datos y brechas de seguridad. El manejo seguro de credenciales no es opcional, es parte del contrato de producción.
🚫 Nunca en código
Jamás se escribe la clave directamente en el código fuente ni se sube a un repositorio de GitHub (público o privado — un repo privado igual puede filtrarse, cambiar de visibilidad, o tener colaboradores de más).
python
# ❌ NUNCA — la clave queda expuesta en el historial de Git para siempre,
# aunque se borre o se rote después
API_KEY = "Alza..."
⚠️ Borrar la línea en un commit posterior no alcanza: el valor sigue presente en el historial de Git (
git log -p, cualquier fork o clon anterior lo conserva). Si una key llegó a subirse, hay que rotarla/revocarla en el proveedor — borrar el commit no la invalida.
📝 Esta slide muestra el lado del "qué NO hacer" (hardcodear la key, ver glosario). El cómo sí manejarla en
OrderFlow(variables de entorno / secrets manager) queda pendiente para la siguiente parte de la clase.
🔌 6. Integración con Gemini y OpenAI
Esta sección pone código real detrás de la sección 4: así se ve el Provider Interface por dentro. Ambos proveedores exponen SDKs oficiales con patrones muy similares — la clave es encapsular la llamada al SDK detrás de la interfaz propia, para que el resto del sistema no sepa (ni le importe) qué proveedor está activo.
Gemini — SDK google-genai
python
from google import genai

client = genai.Client(
    api_key=settings.gemini_api_key
)
interaction = client.interactions.create(
    model=settings.gemini_model,
    input=prompt,
)
text = interaction.output_text
OpenAI — Responses API
python
from openai import OpenAI

client = OpenAI(
    api_key=settings.openai_api_key
)
response = client.responses.create(
    model=settings.openai_model,
    instructions=system_prompt,
    input=prompt,
)
text = response.output_text
💡 Fijate en la simetría entre ambos bloques: se crea un
clientcon suapi_key(leída desettings, nunca hardcodeada — sección 5), se llama a un método.create(...)pasándole elmodely elprompt, y se lee.output_textdel resultado. Esa simetría es justo lo que permite que el Provider Interface exponga una sola firma genérica (p. ej.generar_descripcion(prompt) -> str) con dos implementaciones intercambiables por dentro — ninguna filtra su forma particular hacia quien la consume.
⚠️
settings.gemini_api_key/settings.openai_api_keyvienen de la misma claseSettings(BaseSettings)por servicio que ya se vio en la Clase 6 — ambas keys se leen desde variables de entorno, no desde el código.
🧪 Tip de entrevista: "¿Qué parte del endpoint cambia si mañana migramos de Gemini a OpenAI?" — idealmente, ninguna. Solo cambia el provider activo (
AI_PROVIDER, sección 4) y su configuración (gemini_model/openai_model); la interfaz pública (POST /descripciones) permanece intacta. Si la respuesta a esa pregunta es "hay que tocar el router" o "hay que cambiar el contrato del endpoint", es señal de que el proveedor se filtró fuera del Provider Interface.
🔑 Cómo obtener tu propia API key de Gemini (Google AI Studio)
Todo el código de esta sección asume que GEMINI_API_KEY ya existe — esto es cómo se consigue ese valor antes de ponerlo en el .env (nunca en el código, sección 5).
📝 El profe compartió un link tipo
aistudio.google.com/u/2/prompts/new_chat?project=gen-lang-client-...— eseproject=es el ID del proyecto de Google Cloud de su propia cuenta (Google Studio lo crea solo la primera vez que entrás). Entrar a esa URL exacta con tu cuenta no te da acceso al proyecto del profe: te va a redirigir a crear el tuyo propio. El flujo de abajo es el que aplica para cualquier cuenta, sin depender de esa URL puntual.
- Entra a aistudio.google.com e inicia sesión con tu cuenta de Google.
- En el panel lateral izquierdo, bajo "PROYECTO", click en "Claves de API" (
aistudio.google.com/u/2/api-keys). - Arriba a la derecha, click en "Crear clave de API".
- Google Studio te pide asociarla a un proyecto de Google Cloud — si es tu primera vez, te ofrece crear uno nuevo automáticamente (con un nombre tipo
gen-lang-client-XXXXXXXXXX, autogenerado — el mismo patrón que tenía el link del profe, pero con tu propio ID). - Copia la clave generada (empieza con
AIza...). Google Studio solo te la muestra completa una vez — si la perdés, tenés que generar una nueva. - Pégala en tu
.envlocal del AI Service:bash# 02-Ejercicios/Clase-12/.env AI_PROVIDER=gemini GEMINI_API_KEY=AIza... # tu clave real, nunca la del profe ni la de un compañero
⚠️ Cada estudiante genera la suya propia. Compartir una API key (aunque sea "solo para probar") es exactamente el riesgo de la sección 5: cualquiera que la tenga puede consumir cuota a nombre de esa cuenta. La pantalla de "Claves de API" además lista, por clave, el proyecto al que pertenece y la fecha de creación — sirve para auditar qué claves existen y cuándo se generaron, y para revocar una si hace falta.
💡 Tip: la misma pantalla (
Claves de API) tiene en el menú lateral "Uso", "Límite de frecuencia" y "Gasto" — vale la pena revisarlos después de generar la key, para saber desde el día 1 cuánta cuota gratuita tenés y no llevarte una sorpresa de facturación.
🏛️ 7. Arquitectura final de OrderFlow
Cierre del curso: esta es la arquitectura completa construida a lo largo de las 12 sesiones — un sistema distribuido, orientado a eventos, con CI/CD automatizado e inteligencia artificial integrada de forma segura.
🗺️ Diagrama: arquitectura final de OrderFlow (recap de las 12 clases)
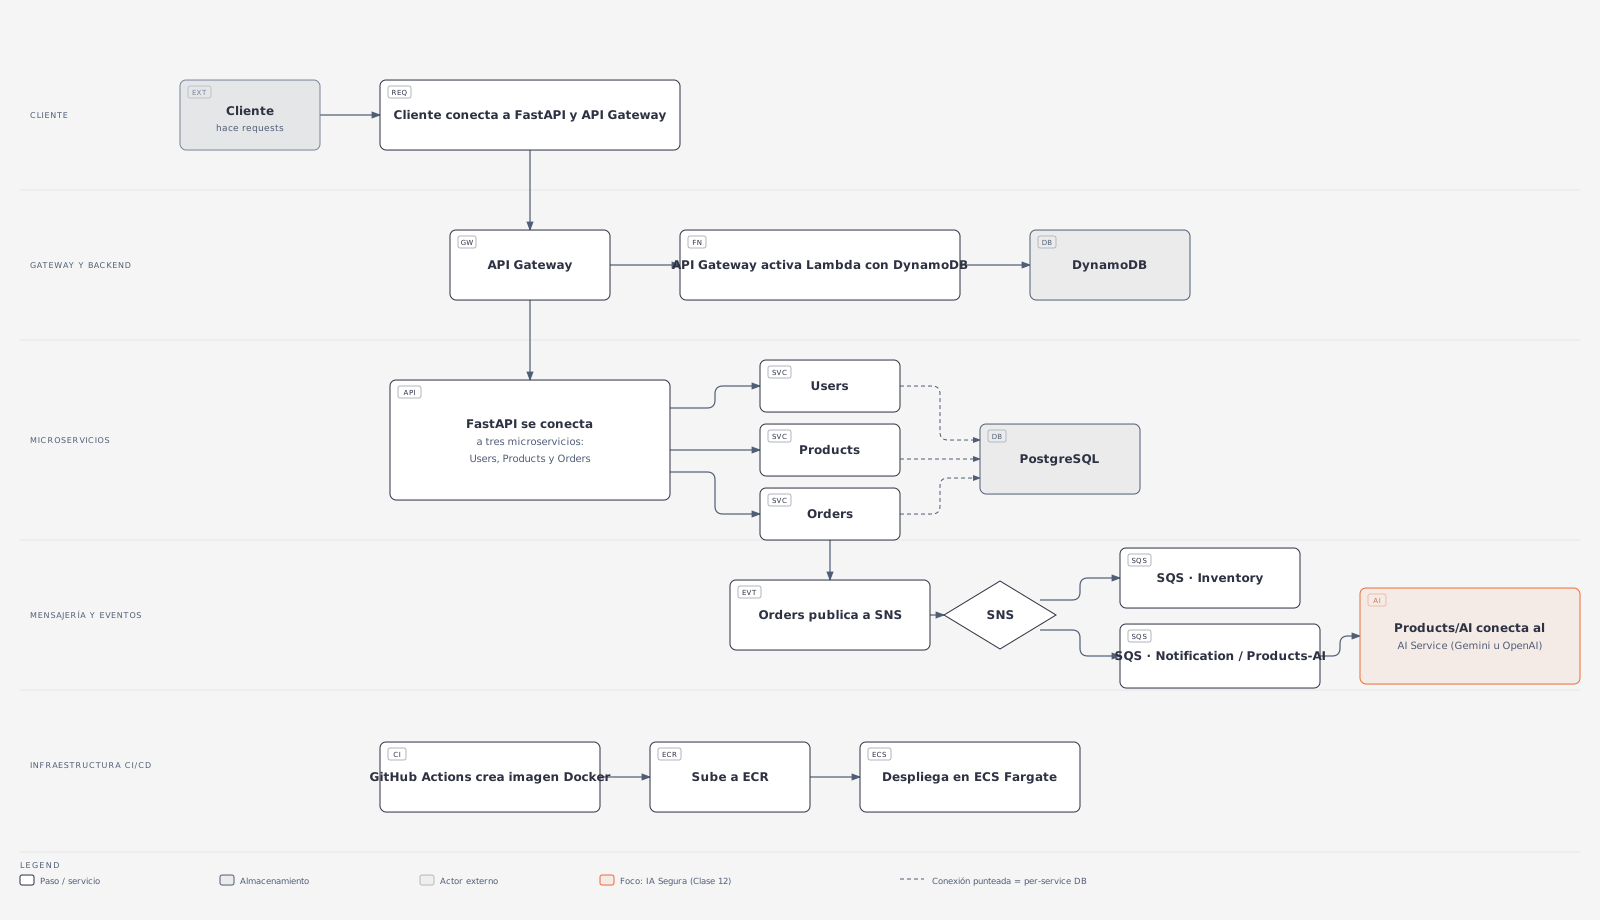
Cada carril es el resultado de una o varias clases del curso — nada en este diagrama es nuevo, es la misma arquitectura, vista de punta a punta:
| Carril | Qué hace | Se construyó en |
|---|---|---|
| Cliente | Conecta a FastAPI y al API Gateway. | Clase 3 |
| Gateway y Backend | API Gateway activa una Lambda que lee/escribe en DynamoDB (serverless). | Clase 8 |
| Microservicios | FastAPI se conecta a Users, Products y Orders, cada uno con su propia conexión a PostgreSQL (Database per Service). | Clase 4, Clase 5, Clase 6, Clase 7 |
| Mensajería y eventos | Orders publica a SNS, que reparte (fan-out) a una cola SQS de inventario y a otra de notificaciones — esta última alimenta al AI Service (Gemini u OpenAI). | Clase 9 + esta clase (secciones 2 a 6) |
| Infraestructura CI/CD | GitHub Actions construye la imagen Docker, la sube a ECR y despliega en ECS Fargate. | Clase 10, Clase 11 |
💡 El nodo en coral (
Products/AI conecta al AI Service) es a propósito el único foco visual del diagrama: es el punto donde toda la Clase 12 — prompt seguro, Provider Interface, manejo de la API key y el código de integración — se conecta con el resto del sistema construido en las 11 clases anteriores.
La slide cierra con 3 tarjetas que resumen, en una línea cada una, los tres pilares no-funcionales que atraviesan toda esta arquitectura:
| Tarjeta | Resumen en una línea |
|---|---|
| CI/CD Pipeline | GitHub → Actions → Docker → ECR → ECS Fargate |
| Mensajería | SNS → SQS → Consumers desacoplados |
| IA Segura | Provider Interface → Gemini / OpenAI intercambiables |
💡 Las tres tarjetas son, en el fondo, la misma idea repetida tres veces a distintos niveles de la arquitectura: una capa intermedia que desacopla — el pipeline desacopla "escribir código" de "tenerlo corriendo en AWS" (Clase 11), SNS/SQS desacopla "publicar un evento" de "quién y cuántos lo consumen" (Clase 9), y el Provider Interface desacopla "generar la descripción" de "qué proveedor de IA la genera" (secciones 4 y 6 de esta clase). Es el mismo principio de desacoplamiento de la Clase 5 aplicado tres veces.
💻 PARTE PRÁCTICA
💻 8. El AI Service real de OrderFlow
Código de trabajo en 02-Ejercicios/Clase-12/. Es el AI Service completo de las secciones 3-6, ya andando: FastAPI + Prompt Builder + Provider Interface + despliegue en ECS con la API key en Secrets Manager/Parameter Store.
🗂️ Estructura del proyecto
text
02-Ejercicios/Clase-12/
├── app/
│   ├── config.py            # Settings (pydantic-settings) — Clase 6
│   ├── schemas.py            # ProductDescriptionRequest / Response
│   ├── prompting.py          # SYSTEM_GUIDANCE + build_product_prompt (§3)
│   ├── providers/
│   │   ├── base.py           # AIProvider (ABC) — la interfaz (§4)
│   │   ├── gemini_provider.py
│   │   ├── openai_provider.py
│   │   └── factory.py        # get_ai_provider() — decide por AI_PROVIDER
│   ├── routers/ai.py         # POST /api/v1/ai/product-description
│   └── main.py
├── tests/
│   ├── test_health.py
│   └── test_prompting.py     # NO llama a Gemini/OpenAI real
├── Dockerfile                 # usuario no-root
├── ecs-task-definition.json   # API key vía SSM Parameter Store
└── requirements.txt
🔍 El recorrido de una request
python
# app/routers/ai.py
@router.post("/product-description", response_model=ProductDescriptionResponse)
def generate_product_description(data: ProductDescriptionRequest):
    logger.info(
        "AI request provider=%s product=%s",
        settings.ai_provider, data.name,
    )  # nunca la API key ni el prompt completo

    provider = get_ai_provider()                       # factory (§4)
    model, text = provider.generate(
        SYSTEM_GUIDANCE,
        build_product_prompt(data),                     # prompt seguro (§3)
    )
    return ProductDescriptionResponse(
        provider=settings.ai_provider, model=model, description=text,
)ProductDescriptionRequest(schema) ya rechaza requests confeaturesfuera de rango (1-8 ítems) o campos demasiado largos, antes de que lleguen al prompt.get_ai_provider()leesettings.ai_providery devuelve una instancia concreta (GeminiProvideruOpenAIProvider) — el router nunca importa esas clases directamente, solo conoceAIProvider(interfaz deproviders/base.py).provider.generate(...)llama al SDK real (mismo código de la sección 6).- Los errores del proveedor (
RuntimeErrorsi falta la key, cualquier otra excepción del SDK) se traducen a503/502— el cliente nunca ve el error crudo del SDK externo.
🗺️ Diagrama: cómo se construye el prompt y viaja a Gemini
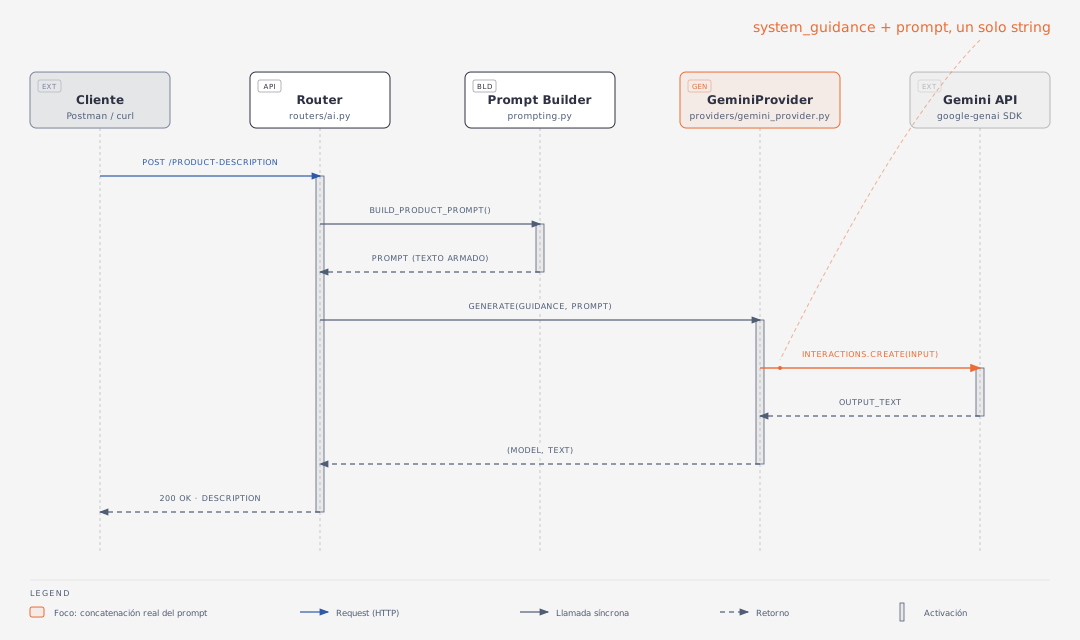
El punto en coral es el corazón de la pregunta "¿cómo recibe las instrucciones la IA?": GeminiProvider.generate() no le manda a Gemini el SYSTEM_GUIDANCE y el prompt por separado — los concatena en un solo string antes de la llamada real:
python
# app/providers/gemini_provider.py
interaction = self.client.interactions.create(
    model=settings.gemini_model,
    input=(
        f"{system_guidance}\n\n"
        f"{prompt}"
    ),
)
Es la razón por la que SYSTEM_GUIDANCE (fijo, con las restricciones de la sección 3) y build_product_prompt(data) (variable, armado desde el ProductRequest) tienen que combinarse en algún punto antes de salir del sistema — ese punto es exactamente acá, dentro del Provider Interface, no antes. El Prompt Builder solo arma su parte (el texto del producto); el Provider es quien decide cómo empaquetar eso junto con las restricciones del sistema para el formato que espera cada SDK (Gemini usa input con todo concatenado; OpenAI en cambio separa instructions de input — ver sección 6).
🔒 Cómo se resuelve "datos sensibles" y "API key" en este proyecto
python
# app/schemas.py — límite de qué puede entrar al prompt
class ProductDescriptionRequest(BaseModel):
    name: str = Field(min_length=2, max_length=120)
    features: list[str] = Field(min_length=1, max_length=8)
    # ...
python
# app/prompting.py — límite de qué puede salir en la respuesta
SYSTEM_GUIDANCE = """
No inventes especificaciones que no estén en los datos recibidos.
No incluyas afirmaciones médicas, legales o financieras.
""".strip()
json
// ecs-task-definition.json — la API key nunca es texto plano
"environment": [{ "name": "AI_PROVIDER", "value": "gemini" }],
"secrets": [{
  "name": "GEMINI_API_KEY",
  "valueFrom": "arn:aws:ssm:us-east-2:<AWS_ACCOUNT_ID>:parameter/orderflow/gemini-api-key"
}]
⚠️ La distinción clave del Task Definition:
environmentes texto plano (visible en la consola de AWS, en logs de despliegue) — solo config no sensible.secretsapunta a un parámetroSecureStringen AWS Systems Manager Parameter Store; ECS lo resuelve e inyecta cifrado en tiempo de ejecución. La API key nunca pasa por el.envdel contenedor ni queda horneada en la imagen Docker.
💡 El
ecsTaskExecutionRolenecesita permiso explícitossm:GetParameterssobre ese parámetro — mismo principio de mínimo privilegio de IAM que ya se vio en la Clase 8.
🧪 Por qué los tests no llaman a la IA real
python
# tests/test_prompting.py
def test_prompt_contains_verified_data():
    data = ProductDescriptionRequest(name="Laptop Pro 14", features=["16 GB RAM"], ...)
    prompt = build_product_prompt(data)
    assert "Laptop Pro 14" in prompt   # verifica el prompt, no la respuesta de la IA
El test verifica que el Prompt Builder arme bien el prompt — nunca invoca a GeminiProvider/OpenAIProvider de verdad. Mismo principio del pipeline de CI/CD de la Clase 11: un test que llamara a una API externa real sería lento, costaría dinero en cada git push, y fallaría si el proveedor está caído — nada de eso debería tumbar el pipeline de OrderFlow.
✅ Prueba real: el endpoint funcionando de punta a punta
Con uvicorn corriendo, una GEMINI_API_KEY real (obtenida siguiendo la sección 6) y google-genai>=2.0 instalado (ver este error si te aparece un 502), el endpoint responde con una descripción generada de verdad:
bash
curl -s -X POST http://127.0.0.1:8000/api/v1/ai/product-description \
  -H "Content-Type: application/json" \
  -d '{"name": "Mochila Urbana X", "category": "Mochilas", "features": ["30 litros", "Compartimento para laptop"], "audience": "estudiantes", "tone": "cercano"}' \
  | python3 -m json.tool
json
{
    "provider": "gemini",
    "model": "gemini-3.8-flash",
    "description": "¡Lleva todo lo necesario para tus clases con la Mochila Urbana X! Pensada para acompañarte en tu día a día como estudiante, te ofrece una capacidad de 30 litros para organizar tus útiles y libros sin complicaciones. Además, cuenta con un compartimento para laptop, ideal para llevar tu computadora a la escuela o la universidad de manera práctica y cómoda. Haz que tu rutina de estudio sea mucho más fácil y muévete por la ciudad con la Mochila Urbana X."
}
💡 Fijate que la descripción usa solo los datos que se enviaron (30 litros, compartimento para laptop, público "estudiantes", tono "cercano") — ninguna característica inventada. Es la fórmula
DATOS + INSTRUCCIÓN + RESTRICCIONESde la sección 3 funcionando con un modelo real, no solo en teoría.
📝 La respuesta cruda que devuelve FastAPI escapa cada carácter no ASCII (tildes,
¡,¿) como una secuencia Unicode de 4 dígitos hexadecimales (u+00a1para¡,u+00f3paraó, etc.) — es JSON igual de válido,json.toolsimplemente no las "desescapa" al imprimir por defecto. No es un error ni un problema de encoding, solo una forma de representar el mismo texto.
🖱️ Cómo se hizo en Postman (capturas propias)
Mismo endpoint, probado desde Postman en vez de curl — útil para guardar la petición y reusarla sin reescribirla cada vez (ver Clase 4, sección 15 si querés el recorrido completo de Environment/Collection con Postman).
1. Environment — variable base_url_gateway apuntando a http://127.0.0.1:8000 (mismo concepto que base_url en la Clase 4, solo que acá el nombre elegido fue base_url_gateway).
2. Request "Health" (colección Clase 12 - Prompting):
| Campo | Valor |
|---|---|
| Method | GET |
| URL | {{base_url_gateway}}/health/live |
| Respuesta | 200 OK en 35 ms |
json
{
    "status": "ok",
    "service": "OrderFlow AI Service",
    "provider": "gemini"
}
📝 La colección aparece nombrada "Clase 12 - Promteting" en la captura (typo de "Prompting") — queda documentado tal cual se guardó, se puede corregir el nombre en Postman cuando quieras sin que afecte nada de lo ya probado.
3. Request "Generar descripción (la real, con IA)" — Body → raw → JSON:
| Campo | Valor |
|---|---|
| Method | POST |
| URL | {{base_url_gateway}}/api/v1/ai/product-description |
| Body | raw → JSON |
| Respuesta | 200 OK · 4.88 s · 734 B |
json
// Body enviado
{
    "name": "Mochila Urbana X",
    "category": "Mochilas",
    "features": ["30 litros", "Compartimento para laptop"],
    "audience": "estudiantes",
    "tone": "cercano"
}
json
// Respuesta real de Gemini
{
    "provider": "gemini",
    "model": "gemini-3.8-flash",
    "description": "¿Listo para tus clases? La Mochila Urbana X es la compañera ideal para tu vida de estudiante. Con una práctica capacidad de 30 litros, tendrás el espacio necesario para llevar todo lo que requieres en tu día a día académico. Además, incorpora un compartimento especial para tu laptop, facilitando el transporte organizado de tu equipo a la escuela o la universidad. Es una alternativa funcional pensada para adaptarse a tu ritmo y acompañarte en cada jornada de estudio. ¡Lleva la Mochila Urbana X y mantén tus cosas siempre a mano!"
}
💡 Fijate que el texto es distinto al de la prueba con
curlde más arriba, aunque elProductRequestenviado es idéntico — Gemini no es determinístico: la misma entrada puede generar redacciones distintas cada vez, aunque respetando siempre los mismos datos verificados (30 litros, compartimento para laptop, nunca una característica inventada).
💡 La única diferencia real entre probar con
curly con Postman es la UI — la request HTTP que sale "por la red" es idéntica. Postman suma la variable de Environment (para no reescribir la URL en cada request) y el historial de respuestas guardado, quecurlno te da gratis.
🏋️ 9. EJERCICIOS CON SOLUCIÓN
Todos los ejercicios trabajan sobre
02-Ejercicios/Clase-12/. Antes de empezar:bashcd 02-Ejercicios/Clase-12 python3 -m venv .venv source .venv/bin/activate # macOS/Linux python -m pip install -r requirements.txtLa mayoría de los ejercicios no necesita una API key real (usan
TestClient, variables de entorno o providers mockeados) — la excepción son los ejercicios 33 y 34 (Postman contra el endpoint real) y cualquiera que quieras confirmar además con una llamada real a Gemini/OpenAI.
Ejercicio 1 — Levantar el servicio y confirmar el health check
Levanta el AI Service en local (uvicorn app.main:app --reload) y consulta su endpoint de salud con curl o desde /docs.
🎯 Qué deberías lograr: GET /health/live responde 200 con {"status": "ok", "service": "OrderFlow AI Service", "provider": "gemini"} (el provider depende de tu .env, gemini si no configuraste nada).
💡 ¿Sabías que…? — el health check nunca depende de servicios externos
Un endpoint de salud (/health/live, ver Clase 11 §2) debe responder rápido y sin depender de nada externo — ni base de datos, ni un proveedor de IA. Si /health/live llamara a Gemini para "probar que anda", un corte de Gemini tumbaría el health check de todo el servicio, aunque el resto funcione bien. Por eso este endpoint solo lee settings, nunca invoca al Provider Interface.
python
# ejemplo de referencia — orders_service (Clase 6), mismo principio
@app.get("/health/live")
def liveness():
    return {"status": "ok", "service": settings.app_name}
Ver solución
bash
source .venv/bin/activate
uvicorn app.main:app --reload
# en otra terminal:
curl http://127.0.0.1:8000/health/live
json
{"status": "ok", "service": "OrderFlow AI Service", "provider": "gemini"}Ejercicio 2 — Confirmar el error real sin API key configurada
Sin crear ningún .env, manda un POST /api/v1/ai/product-description con un producto válido (usa /docs o curl). Observa el código de estado y el detail del error.
🎯 Qué deberías lograr: la respuesta es 503 con {"detail": "GEMINI_API_KEY no está configurada"}.
💡 ¿Sabías que…? — un 503 y un 500 no significan lo mismo
503 Service Unavailable dice "el servicio sabe que algo externo necesario no está disponible" (en este caso, la configuración falta) — es distinto de un 500 genérico, que sugiere un bug no controlado. app/routers/ai.py atrapa RuntimeError específicamente para convertirlo en 503, y deja que cualquier otra excepción caiga en el except Exception que responde 502 (ver Ejercicio 13). Ese es el patrón: cada tipo de falla se traduce al código HTTP que mejor describe lo que pasó, no todo cae en un catch-all.
python
# ejemplo de referencia — otro caso típico de 503
if not settings.database_url:
    raise HTTPException(503, "Base de datos no configurada")
Ver solución
bash
curl -X POST http://127.0.0.1:8000/api/v1/ai/product-description \
  -H "Content-Type: application/json" \
  -d '{"name": "Silla Gamer Vortex", "category": "Sillas de oficina", "features": ["Reposabrazos 4D"]}'
json
{"detail": "GEMINI_API_KEY no está configurada"}Código de estado: 503.
Ejercicio 3 — features vacío
Manda el mismo request pero con "features": [].
🎯 Qué deberías lograr: la respuesta es 422 (Unprocessable Entity) — el request ni siquiera llega al Prompt Builder.
💡 ¿Sabías que…? — Pydantic corta el paso antes que tu código
Field(min_length=1, max_length=8) sobre una list[str] valida la cantidad de elementos de la lista, no el largo del texto. Si la validación falla, FastAPI nunca llega a ejecutar el cuerpo de generate_product_description — por eso este caso no consume cuota de la IA ni pasa por el Provider Interface.
python
# ejemplo de referencia — otro caso de min_length en una lista
class PedidoRequest(BaseModel):
    items: list[str] = Field(min_length=1, max_length=20)
Ver solución
python
from fastapi.testclient import TestClient
from app.main import app

client = TestClient(app)
r = client.post("/api/v1/ai/product-description", json={
    "name": "Auriculares NovaSound", "category": "Audio", "features": [],
})
assert r.status_code == 422
Ejercicio 4 — Más de 8 características
Manda un request con 9 elementos en features.
🎯 Qué deberías lograr: 422 — mismo motivo que el ejercicio 3, pero por el límite superior (max_length=8).
💡 ¿Sabías que…? — por qué existe un tope superior
El límite de arriba (max_length=8) no es arbitrario: cada característica extra es más texto en el prompt (más costo por token hacia el proveedor de IA) y más margen para que el modelo se disperse. Limitar la entrada es, indirectamente, otra forma de controlar costo — el mismo espíritu del "límite de costo y consumo" que menciona el README.md del proyecto.
python
# ejemplo de referencia — mismo patrón con un tope superior distinto
tags: list[str] = Field(min_length=0, max_length=5)
Ver solución
python
r = client.post("/api/v1/ai/product-description", json={
    "name": "Kit de Herramientas ProFix", "category": "Herramientas",
    "features": [f"feature {i}" for i in range(9)],
})
assert r.status_code == 422
Ejercicio 5 — name demasiado corto
Manda "name": "M" (un solo carácter).
🎯 Qué deberías lograr: 422 — min_length=2 en name lo rechaza.
💡 ¿Sabías que…? — por qué `name` también tiene un mínimo
Un min_length=2 puede parecer exagerado, pero cumple el mismo propósito que min_length=1 en features: evitar que llegue al prompt un valor "vacío en la práctica" (un espacio, una sola letra) que la IA tendría que interpretar sin información real — abriendo la puerta, otra vez, a que invente.
python
# ejemplo de referencia — Clase 3, validación de un query param
q: str = Query(min_length=3)
Ver solución
python
r = client.post("/api/v1/ai/product-description", json={
    "name": "M", "category": "Tablets", "features": ["Pantalla 10 pulgadas"],
})
assert r.status_code == 422
Ejercicio 6 — Valores por defecto de audience y tone
Crea un ProductDescriptionRequest sin pasar audience ni tone e imprime esos dos campos.
🎯 Qué deberías lograr: audience vale exactamente "cliente general" y tone vale exactamente "profesional" — los defaults del schema.
💡 ¿Sabías que…? — un default no es lo mismo que un campo opcional
audience: str = Field(default="cliente general", ...) significa que el campo siempre tiene un valor — nunca es None — aunque el cliente no lo mande. Es distinto de gemini_api_key: str | None = None en config.py (Clase 12, sección 1), donde None sí es un estado válido y esperado (todavía no se configuró la key).
python
# ejemplo de referencia
prioridad: str = Field(default="media")   # nunca None, siempre "media" si no se manda
Ver solución
python
from app.schemas import ProductDescriptionRequest

r = ProductDescriptionRequest(
    name="Cafetera Aurora", category="Electrodomésticos",
    features=["1.5 litros", "Filtro reutilizable"],
)
assert r.audience == "cliente general"
assert r.tone == "profesional"
Ejercicio 7 — Construir tu propio prompt
Usa build_product_prompt con un producto inventado por vos (no una laptop, ni una mochila, ni una cafetera — ya usados en ejercicios anteriores) y confirma que los datos aparecen tal cual en el texto generado.
🎯 Qué deberías lograr: cada valor que le pasaste (name, cada feature) aparece como substring exacto dentro del prompt devuelto.
💡 ¿Sabías que…? — probar la forma, no el contenido creativo
Este test (igual que tests/test_prompting.py ya incluido) no puede verificar si el prompt "es bueno" — eso es subjetivo. Lo que sí puede verificar en CI, de forma determinística, es que el armado mecánico es correcto: que los datos verificados llegan íntegros al texto. Es la frontera entre lo que un test automatizado puede garantizar y lo que requiere revisión humana.
python
# ejemplo de referencia — mismo patrón, otro producto
data = ProductDescriptionRequest(name="Silla Ergo", category="Muebles", features=["Ajuste lumbar"])
prompt = build_product_prompt(data)
assert "Silla Ergo" in prompt
Ver solución
python
from app.prompting import build_product_prompt
from app.schemas import ProductDescriptionRequest

data = ProductDescriptionRequest(
    name="Bicicleta Urbana Volt", category="Bicicletas",
    features=["Motor eléctrico 250W", "Autonomía 40km"],
    audience="ciclistas urbanos", tone="aventurero",
)
prompt = build_product_prompt(data)
assert "Bicicleta Urbana Volt" in prompt
assert "Motor eléctrico 250W" in prompt
assert "Autonomía 40km" in prompt
Ejercicio 8 — Confirmar las restricciones del SYSTEM_GUIDANCE
Sin modificar nada, escribe un test que confirme que SYSTEM_GUIDANCE prohíbe explícitamente inventar especificaciones y hacer afirmaciones médicas/legales.
🎯 Qué deberías lograr: el test pasa confirmando que ambas frases están presentes en la constante.
💡 ¿Sabías que…? — probar el prompt de sistema es parte de la seguridad
SYSTEM_GUIDANCE es la implementación real de la fórmula DATOS + INSTRUCCIÓN + RESTRICCIONES de la sección 3 — específicamente la parte de "restricciones". Un test que confirme que esas frases siguen ahí protege contra que alguien las borre sin querer en un refactor futuro ("regression test" de una regla de negocio, no solo de código).
python
# ejemplo de referencia — mismo patrón con otra restricción de negocio
from app.pricing import DISCOUNT_RULES
assert "no acumulable" in DISCOUNT_RULES.lower()
Ver solución
python
from app.prompting import SYSTEM_GUIDANCE

def test_system_guidance_prohibe_inventar_y_temas_sensibles():
    assert "No inventes especificaciones" in SYSTEM_GUIDANCE
    assert "médicas" in SYSTEM_GUIDANCE
    assert "legales" in SYSTEM_GUIDANCE
Ejercicio 9 — Proveedor no soportado
Con AI_PROVIDER=azure (un valor que no existe en el factory), llama a get_ai_provider().
🎯 Qué deberías lograr: se lanza RuntimeError con el mensaje "Proveedor no soportado: azure".
💡 ¿Sabías que…? — fallar rápido y explícito en la configuración
El factory.py no tiene un else silencioso ni devuelve None — lanza un error inmediatamente con el valor incorrecto incluido en el mensaje. Esto es "fail fast": preferís que OrderFlow truene apenas arranca con una config mala, antes que descubrirlo en producción cuando un cliente pida una descripción.
python
# ejemplo de referencia — mismo patrón fail-fast en otro factory
def get_notifier(kind: str):
    if kind == "email": return EmailNotifier()
    if kind == "sms": return SmsNotifier()
    raise RuntimeError(f"Notificador no soportado: {kind}")
Ver solución
bash
AI_PROVIDER=azure python3 -c "
from app.providers.factory import get_ai_provider
try:
    get_ai_provider()
except RuntimeError as e:
    print(e)
"
text
Proveedor no soportado: azureEjercicio 10 — OpenAI sin su API key
Con AI_PROVIDER=openai y sin OPENAI_API_KEY en el entorno, llama a get_ai_provider().
🎯 Qué deberías lograr: RuntimeError con el mensaje "OPENAI_API_KEY no está configurada" — no el mensaje de Gemini.
💡 ¿Sabías que…? — cada provider valida su propia key
GeminiProvider.__init__ y OpenAIProvider.__init__ validan su propia key, no una validación centralizada en el factory. Esto respeta el mismo principio de la sección 4: cada implementación concreta encapsula todo lo que necesita para funcionar, sin filtrar detalles hacia el resto del código.
python
# ejemplo de referencia — mismo patrón, un tercer proveedor
class ClaudeProvider(AIProvider):
    def __init__(self):
        if not settings.claude_api_key:
            raise RuntimeError("CLAUDE_API_KEY no está configurada")
Ver solución
bash
AI_PROVIDER=openai python3 -c "
from app.providers.factory import get_ai_provider
try:
    get_ai_provider()
except RuntimeError as e:
    print(e)
"
text
OPENAI_API_KEY no está configuradaEjercicio 11 — AI_PROVIDER no distingue mayúsculas ni espacios
Prueba AI_PROVIDER=" GEMINI " (con espacios y en mayúsculas) y confirma que el factory igual reconoce gemini.
🎯 Qué deberías lograr: el error que obtenés es "GEMINI_API_KEY no está configurada" (reconoció "gemini"), no "Proveedor no soportado: GEMINI ".
💡 ¿Sabías que…? — normalizar la entrada evita bugs tontos en producción
settings.ai_provider.lower().strip() es una línea chica que evita un bug real: alguien escribe AI_PROVIDER=Gemini (con mayúscula) en la consola de ECS a las 11pm y el servicio entero cae con "Proveedor no soportado" — un typo de capitalización, no un error de lógica. Normalizar la entrada externa (variables de entorno, query params, headers) es una defensa barata contra ese tipo de error humano.
python
# ejemplo de referencia — mismo principio con un query param
formato = request.query_params.get("formato", "json").lower().strip()
Ver solución
bash
AI_PROVIDER=" GEMINI " python3 -c "
from app.providers.factory import get_ai_provider
try:
    get_ai_provider()
except RuntimeError as e:
    print(e)
"
text
GEMINI_API_KEY no está configuradaEjercicio 12 — Testear el endpoint sin llamar a ninguna IA real
Usa unittest.mock.patch para reemplazar get_ai_provider (tal como se importa en app/routers/ai.py) por un objeto falso que devuelve un texto fijo, y llama al endpoint con TestClient.
🎯 Qué deberías lograr: 200 con {"provider": "gemini", "model": "fake-model-1", "description": "..."} — sin que se haya llamado nunca a google-genai ni a openai.
💡 ¿Sabías que…? — mockear en el punto donde se importó, no donde se definió
patch("app.routers.ai.get_ai_provider", ...) funciona porque el router hizo from app.providers.factory import get_ai_provider — el nombre vive ahora en el namespace de app.routers.ai, no en app.providers.factory. Mockear app.providers.factory.get_ai_provider en este caso no tendría efecto, porque el router ya tiene su propia referencia a la función original. Es uno de los errores más comunes al mockear en Python.
python
# ejemplo de referencia — mismo error común, otro módulo
# archivo b.py: from a import enviar_email
# CORRECTO:   patch("b.enviar_email", ...)
# INCORRECTO: patch("a.enviar_email", ...)  # no afecta a b.py
Ver solución
python
from unittest.mock import patch
from fastapi.testclient import TestClient
from app.main import app

client = TestClient(app)

class FakeProvider:
    def generate(self, system_guidance, prompt):
        return ("fake-model-1", "Descripción de prueba generada sin llamar a ningún proveedor real.")

def test_endpoint_con_provider_mockeado():
    with patch("app.routers.ai.get_ai_provider", return_value=FakeProvider()):
        r = client.post("/api/v1/ai/product-description", json={
            "name": "Zapatillas TrailX", "category": "Calzado deportivo",
            "features": ["Suela antideslizante", "Malla transpirable"],
        })
        assert r.status_code == 200
        assert r.json()["model"] == "fake-model-1"
Ejercicio 13 — Cuando el proveedor falla con un error inesperado
Con el mismo mecanismo de mock, haz que generate() lance un TimeoutError genérico (no un RuntimeError) y observa qué responde el endpoint.
🎯 Qué deberías lograr: 502 con {"detail": "No fue posible obtener respuesta del proveedor de IA"} — el mensaje real del TimeoutError no se filtra al cliente.
💡 ¿Sabías que…? — no expongas el error crudo de un proveedor externo
El except Exception de app/routers/ai.py hace dos cosas a propósito: loguea el traceback completo (logger.exception(...), para que vos como desarrollador lo veas en CloudWatch) pero responde al cliente un mensaje genérico. Esto evita filtrar detalles internos (nombres de librerías, rutas de archivos, mensajes de error del proveedor) que no le sirven al cliente y sí le sirven a un atacante.
python
# ejemplo de referencia — mismo patrón en otro servicio
except Exception:
    logger.exception("Error consultando el proveedor de pagos")
    raise HTTPException(502, "No fue posible procesar el pago")
Ver solución
python
class BrokenProvider:
    def generate(self, system_guidance, prompt):
        raise TimeoutError("El proveedor tardó demasiado en responder")

def test_endpoint_con_provider_roto():
    with patch("app.routers.ai.get_ai_provider", return_value=BrokenProvider()):
        r = client.post("/api/v1/ai/product-description", json={
            "name": "Lámpara SmartGlow", "category": "Iluminación",
            "features": ["Control por app", "12 tonalidades de luz"],
        })
        assert r.status_code == 502
        assert r.json()["detail"] == "No fue posible obtener respuesta del proveedor de IA"
Ejercicio 14 — AIProvider no se puede instanciar directamente
Intenta crear una instancia de AIProvider directamente (sin subclasificarla) y observa qué pasa.
🎯 Qué deberías lograr: Python lanza TypeError al intentar instanciarla, mencionando el método abstracto generate sin implementar.
💡 ¿Sabías que…? — `ABC` + `@abstractmethod` es la interfaz "de libro" de Python
Python no tiene una palabra clave interface como Java o TypeScript, pero el módulo abc (Abstract Base Class) cumple el mismo rol: class AIProvider(ABC) con un método marcado @abstractmethod no puede instanciarse hasta que una subclase implemente ese método. Es la forma más explícita de declarar "esto es un contrato, no una implementación" — el Provider Interface de la sección 4 hecho con mecánica de lenguaje, no solo convención.
python
# ejemplo de referencia — mismo patrón, otro dominio
from abc import ABC, abstractmethod

class Repositorio(ABC):
    @abstractmethod
    def guardar(self, entidad): ...
Ver solución
python
from app.providers.base import AIProvider

try:
    AIProvider()
except TypeError as e:
    print(e)
text
Can't instantiate abstract class AIProvider without an implementation for abstract method 'generate'Ejercicio 15 — Una subclase incompleta tampoco se puede instanciar
Define class ProveedorIncompleto(AIProvider): pass (sin implementar generate) e intenta instanciarla.
🎯 Qué deberías lograr: el mismo TypeError que en el ejercicio 14 — ABC no perdona subclases a medias.
💡 ¿Sabías que…? — el chequeo es sobre el método, no sobre la herencia
Heredar de AIProvider no alcanza — Python revisa, al momento de instanciar, que todos los métodos marcados @abstractmethod en la cadena de herencia tengan una implementación concreta en algún punto. Es la garantía en tiempo de ejecución de que ningún provider "a medias" pueda llegar a producción.
python
# ejemplo de referencia
class RepositorioIncompleto(Repositorio):
    pass  # sigue siendo abstracta: TypeError al instanciarla
Ver solución
python
class ProveedorIncompleto(AIProvider):
    pass

try:
    ProveedorIncompleto()
except TypeError as e:
    print(e)
text
Can't instantiate abstract class ProveedorIncompleto without an implementation for abstract method 'generate'Ejercicio 16 — Implementa un EchoProvider
Crea una clase EchoProvider(AIProvider) que no llame a ninguna IA real: su generate() debe devolver ("echo-local", <un texto derivado del prompt>). Instánciala y llamá a generate() para confirmar que funciona.
🎯 Qué deberías lograr: EchoProvider().generate(...) devuelve una tupla (str, str) sin lanzar ningún error, y sin necesitar ninguna API key.
💡 ¿Sabías que…? — un provider "falso" es útil más allá de los tests
Un provider como este no es solo para testear: en desarrollo local, un AI_PROVIDER=echo te deja iterar sobre el resto del sistema (validaciones, logging, manejo de errores) sin gastar cuota de la API real ni necesitar credenciales — muy útil para practicar sin tener una cuenta de Gemini/OpenAI todavía. Es el mismo motivo por el que LocalStack existe para simular AWS.
python
# ejemplo de referencia — un provider falso con comportamiento distinto
class UpperCaseProvider(AIProvider):
    def generate(self, system_guidance, prompt):
        return ("upper-local", prompt.upper())
Ver solución
python
# app/providers/echo_provider.py
from app.providers.base import AIProvider


class EchoProvider(AIProvider):
    def generate(self, system_guidance: str, prompt: str) -> tuple[str, str]:
        return ("echo-local", f"[eco] {prompt[:60]}...")
python
from app.providers.echo_provider import EchoProvider

echo = EchoProvider()
model, text = echo.generate("guia", "Crea una descripción de una campera de invierno")
assert model == "echo-local"
assert text.startswith("[eco]")
Ejercicio 17 — Registra EchoProvider en el factory
Modifica get_ai_provider() para que AI_PROVIDER=echo devuelva tu EchoProvider del ejercicio anterior.
🎯 Qué deberías lograr: con AI_PROVIDER=echo, un POST al endpoint responde 200 sin que exista ninguna API key configurada en el .env.
💡 ¿Sabías que…? — agregar un proveedor no debería tocar el router
Si implementaste bien el ejercicio 16, este paso solo toca factory.py — ni app/routers/ai.py ni app/main.py cambian una línea. Esa es la prueba de que el Provider Interface (sección 4) realmente desacopla: agregar un tercer proveedor es un cambio aislado y local, no una modificación en cascada por todo el proyecto.
python
# ejemplo de referencia — mismo patrón de "un if más" en el factory
if provider == "claude":
    return ClaudeProvider()
Ver solución
python
# app/providers/factory.py
from app.providers.echo_provider import EchoProvider

def get_ai_provider() -> AIProvider:
    provider = settings.ai_provider.lower().strip()
    if provider == "gemini":
        return GeminiProvider()
    if provider == "openai":
        return OpenAIProvider()
    if provider == "echo":
        return EchoProvider()
    raise RuntimeError(f"Proveedor no soportado: {settings.ai_provider}")
bash
AI_PROVIDER=echo uvicorn app.main:app --reload
curl -X POST http://127.0.0.1:8000/api/v1/ai/product-description \
  -H "Content-Type: application/json" \
  -d '{"name": "Guitarra Acústica Cedro", "category": "Instrumentos musicales", "features": ["Cuerpo de cedro macizo"]}'
# 200 OK, sin ninguna API key configurada
Ejercicio 18 — Avanzado: límite de longitud combinada en features
Agrega un @field_validator a ProductDescriptionRequest que rechace el request si la suma de caracteres de todas las features supera 500.
🎯 Qué deberías lograr: un request con features cuyo total supera 500 caracteres lanza ValidationError (422 vía la API); uno por debajo del límite sigue funcionando igual que antes.
💡 ¿Sabías que…? — un validador de campo ve el valor ya parcialmente validado
@field_validator("features") corre después de que Pydantic ya aplicó min_length/max_length sobre la lista — para cuando tu función se ejecuta, ya sabés que hay entre 1 y 8 elementos. Podés combinar validaciones "estructurales" (las de Field) con validaciones "de negocio" (una regla propia) sin duplicar lo que Pydantic ya te garantiza.
python
# ejemplo de referencia — validador sobre otro campo
@field_validator("tone")
@classmethod
def tono_no_puede_ser_agresivo(cls, tone: str) -> str:
    if "agresivo" in tone.lower():
        raise ValueError("El tono no puede ser agresivo")
    return tone
Ver solución
python
# app/schemas.py
from pydantic import BaseModel, Field, field_validator


class ProductDescriptionRequest(BaseModel):
    name: str = Field(min_length=2, max_length=120)
    category: str = Field(min_length=2, max_length=80)
    features: list[str] = Field(min_length=1, max_length=8)
    audience: str = Field(default="cliente general", max_length=120)
    tone: str = Field(default="profesional", max_length=40)

    @field_validator("features")
    @classmethod
    def limitar_longitud_total(cls, features: list[str]) -> list[str]:
        total = sum(len(f) for f in features)
        if total > 500:
            raise ValueError(
                f"El total de caracteres en 'features' ({total}) supera el límite de 500"
            )
        return features
python
import pytest
from pydantic import ValidationError

def test_rechaza_features_demasiado_largas():
    with pytest.raises(ValidationError):
        ProductDescriptionRequest(
            name="Set de Pinceles ArtPro", category="Arte",
            features=["x" * 100 for _ in range(6)],  # 600 caracteres
        )
Ejercicio 19 — Analiza el Dockerfile y el Task Definition (sin ejecutar)
Sin correr docker build, responde por escrito: (a) ¿qué pasaría si se eliminara la línea USER appuser del Dockerfile? (b) ¿por qué GEMINI_API_KEY está en el bloque "secrets" del ecs-task-definition.json y no en "environment" junto a AI_PROVIDER?
🎯 Qué deberías lograr: una respuesta escrita para cada pregunta, sin necesidad de ejecutar nada — es un ejercicio de lectura de infraestructura.
💡 ¿Sabías que…? — "environment" en el Task Definition no es privado
Cualquiera con acceso de lectura a la consola de ECS (o al describe-tasks de la CLI de AWS) puede ver los valores del bloque "environment" en texto plano — por eso ahí solo va config no sensible (AI_PROVIDER, nombres de modelo). El bloque "secrets" en cambio solo guarda una referencia (el ARN del parámetro en SSM); el valor real nunca aparece en la definición de la tarea, solo se resuelve al arrancar el contenedor.
json
// ejemplo de referencia — mismo patrón con una URL de base de datos
"environment": [{"name": "DB_HOST", "value": "prod.cluster.rds.amazonaws.com"}],
"secrets": [{"name": "DB_PASSWORD", "valueFrom": "arn:aws:ssm:...:parameter/orderflow/db-password"}]
Ver solución
(a) Sin USER appuser, el proceso uvicorn correría como root dentro del contenedor. Si alguien lograra ejecutar código arbitrario a través de una vulnerabilidad en el servicio o en una dependencia, tendría privilegios de root dentro del contenedor — más superficie de daño (aunque siga contenido por Docker, no hay razón para regalar ese privilegio de más).
(b) AI_PROVIDER no es secreto — solo dice "gemini" u "openai", no da acceso a nada por sí solo. GEMINI_API_KEY sí otorga acceso directo a la cuenta de IA de OrderFlow; por eso va en "secrets", resuelto en tiempo de ejecución desde AWS Systems Manager Parameter Store, y nunca queda expuesto en la definición de la tarea ni en logs de despliegue.
Ejercicio 20 — Reto final: límite de palabras configurable
Actualmente build_product_prompt siempre pide "máximo 120 palabras" (un valor fijo, hardcodeado en el f-string). Agrega un campo opcional max_words: int al schema (con un default de 120) y úsalo en build_product_prompt en vez del número fijo.
🎯 Qué deberías lograr: un request sin max_words genera el mismo prompt de siempre ("máximo 120 palabras"); un request con "max_words": 60 genera un prompt que dice "máximo 60 palabras". El test existente (test_prompting.py) sigue pasando sin modificarlo.
💡 ¿Sabías que…? — hardcodear un límite es una forma de acoplamiento
Un valor fijo dentro de una función ("máximo 120 palabras", texto plano dentro de build_product_prompt) es análogo a hardcodear una API key (sección 5): funciona, pero acopla una decisión de negocio ("120 palabras es el límite correcto") al código de la función, en vez de dejarla como un parámetro que quien llama puede decidir. Es el mismo espíritu de "sacar la configuración del código" aplicado a un valor de negocio, no solo a un secreto.
python
# ejemplo de referencia — mismo principio con otro límite de negocio
def construir_resumen(texto: str, max_lineas: int = 3) -> str:
    return "\n".join(texto.splitlines()[:max_lineas])
Ver solución
python
# app/schemas.py
class ProductDescriptionRequest(BaseModel):
    name: str = Field(min_length=2, max_length=120)
    category: str = Field(min_length=2, max_length=80)
    features: list[str] = Field(min_length=1, max_length=8)
    audience: str = Field(default="cliente general", max_length=120)
    tone: str = Field(default="profesional", max_length=40)
    max_words: int = Field(default=120, ge=20, le=300)
python
# app/prompting.py
def build_product_prompt(data: ProductDescriptionRequest) -> str:
    features = "\n".join(f"- {feature}" for feature in data.features)
    return f"""
Crea una descripción comercial de máximo {data.max_words} palabras.

Producto: {data.name}
Categoría: {data.category}
Público: {data.audience}
Tono: {data.tone}

Características verificadas:
{features}

Devuelve únicamente la descripción final.
""".strip()
python
def test_max_words_por_defecto_y_personalizado():
    base = ProductDescriptionRequest(
        name="Robot Aspiradora CleanBot", category="Electrodomésticos inteligentes",
        features=["Mapeo láser", "Vacía automática"],
        audience="familias ocupadas", tone="práctico",
    )
    assert "máximo 120 palabras" in build_product_prompt(base)

    corto = ProductDescriptionRequest(
        name="Robot Aspiradora CleanBot", category="Electrodomésticos inteligentes",
        features=["Mapeo láser", "Vacía automática"], max_words=60,
    )
    assert "máximo 60 palabras" in build_product_prompt(corto)
Ejercicio 21 — La instrucción final siempre está presente
Confirma que build_product_prompt siempre termina con la instrucción "Devuelve únicamente la descripción final.", sin importar qué producto le pases.
🎯 Qué deberías lograr: el test pasa con cualquier ProductRequest válido — la frase no depende de los datos del producto.
💡 ¿Sabías que…? — separar el "qué datos" del "qué formato de salida"
Esa instrucción no es parte de los datos del producto ni de las restricciones de seguridad (SYSTEM_GUIDANCE) — es una instrucción de formato de salida, fija en la plantilla del prompt. Está para evitar que la IA agregue texto extra (saludos, aclaraciones, "aquí tienes tu descripción:") antes o después de lo que realmente necesita ProductDescriptionResponse.description.
python
# ejemplo de referencia — misma idea con otra instrucción de formato fija
PLANTILLA = "Responde solo con un JSON válido, sin texto adicional."
Ver solución
python
from app.prompting import build_product_prompt
from app.schemas import ProductDescriptionRequest

data = ProductDescriptionRequest(
    name="Reloj Inteligente PulseFit", category="Wearables",
    features=["Monitor cardíaco", "GPS integrado"],
)
prompt = build_product_prompt(data)
assert "Devuelve únicamente la descripción final." in prompt
Ejercicio 22 — Boundary: el mínimo de features (1 elemento)
Manda un request con exactamente 1 elemento en features (el mínimo permitido) y confirma que pasa.
🎯 Qué deberías lograr: 201/200 (según cómo lo pruebes) o, si lo probás directo con el schema, que ProductDescriptionRequest se construye sin error — el límite inferior es inclusive.
💡 ¿Sabías que…? — probar los bordes, no solo el medio
Los tests de los ejercicios 3 y 4 prueban los casos que fallan (0 y 9 elementos). Este ejercicio prueba el caso que debería pasar justo en el límite (1 elemento, el mínimo válido) — un "boundary test" clásico: no alcanza con probar un caso típico (3-4 features), hay que confirmar que los bordes exactos del rango (min_length, max_length) se comportan como esperás, no uno más ni uno menos.
python
# ejemplo de referencia — boundary test de otro campo
tags: list[str] = Field(min_length=1, max_length=3)
# probar con 1 (mínimo, debe pasar) y con 3 (máximo, debe pasar)
Ver solución
python
from app.schemas import ProductDescriptionRequest

r = ProductDescriptionRequest(
    name="Vela Aromática Zen", category="Decoración", features=["Aroma lavanda"],
)
assert len(r.features) == 1
Ejercicio 23 — Boundary: el máximo de features (8 elementos)
Manda un request con exactamente 8 elementos en features (el máximo permitido) y confirma que pasa — no 9 (eso ya se prueba en el ejercicio 4).
🎯 Qué deberías lograr: ProductDescriptionRequest se construye sin error con 8 elementos exactos.
💡 ¿Sabías que…? — el límite superior también es inclusive
max_length=8 significa "hasta 8 inclusive" — 8 elementos pasan, 9 no (ya verificado en el ejercicio 4). Confirmar el borde exacto (8, no 7 ni 9) es lo que distingue un test completo de uno que solo prueba "un caso que falla y listo".
python
# ejemplo de referencia
ids: list[int] = Field(min_length=1, max_length=5)
# 5 elementos: pasa. 6 elementos: falla.
Ver solución
python
r = ProductDescriptionRequest(
    name="Set de Cocina ChefPro", category="Cocina",
    features=[f"Pieza {i}" for i in range(8)],
)
assert len(r.features) == 8
Ejercicio 24 — Boundary: category de 2 caracteres exactos
Probá "category": "TV" (2 caracteres, el mínimo permitido) y confirmá que pasa; después probá con 1 carácter y confirmá que falla.
🎯 Qué deberías lograr: "TV" pasa; "T" lanza ValidationError.
💡 ¿Sabías que…? — un mismo `min_length` en dos campos distintos
name y category comparten el mismo min_length=2, pero son campos independientes — cada uno se valida por separado. Un category de 2 caracteres válidos (como una sigla real: "TV", "PC") no es un caso raro, por eso vale la pena confirmar que el límite no rechaza abreviaturas legítimas.
python
# ejemplo de referencia — otra sigla de 2 caracteres real
categoria: str = Field(min_length=2, max_length=80)
# "PC" pasa, "P" no
Ver solución
python
r = ProductDescriptionRequest(name="Televisor OLED", category="TV", features=["Pantalla 55 pulgadas"])
assert r.category == "TV"

try:
    ProductDescriptionRequest(name="Televisor OLED", category="T", features=["Pantalla 55 pulgadas"])
    raise AssertionError("no debería haber pasado")
except ValidationError:
    pass
Ejercicio 25 — Boundary: audience/tone en su longitud máxima
Probá audience con exactamente 120 caracteres y tone con exactamente 40 — deben pasar. Después probá audience con 121 caracteres — debe fallar.
🎯 Qué deberías lograr: el caso de 120/40 pasa; el de 121 lanza ValidationError.
💡 ¿Sabías que…? — los límites de texto libre también se prueban en el borde
A diferencia de features (una lista), audience y tone son texto libre — pero el mismo principio de boundary testing aplica: el límite superior (max_length=120, max_length=40) es inclusive, y vale la pena confirmarlo con el valor exacto, no solo con un texto "obviamente corto".
python
# ejemplo de referencia
comentario: str = Field(max_length=280)  # como un tuit — probar con 280 y con 281
Ver solución
python
r = ProductDescriptionRequest(
    name="Silla de Playa Coral", category="Aire libre", features=["Plegable"],
    audience="a" * 120, tone="b" * 40,
)
assert len(r.audience) == 120 and len(r.tone) == 40

try:
    ProductDescriptionRequest(
        name="Silla de Playa Coral", category="Aire libre", features=["Plegable"],
        audience="a" * 121,
    )
    raise AssertionError("no debería haber pasado")
except ValidationError:
    pass
Ejercicio 26 — Prompt con público infantil y tono divertido
Construí un prompt para un producto pensado para chicos, con audience="niños" y tone="divertido", y confirmá que ambos valores aparecen en el prompt.
🎯 Qué deberías lograr: el prompt generado incluye literalmente "niños" y "divertido" en las líneas de Público y Tono.
💡 ¿Sabías que…? — el Prompt Builder no "traduce" el tono, solo lo declara
build_product_prompt no genera un texto "divertido" por sí mismo — solo le dice a la IA, en la línea Tono: {data.tone}, qué tono usar. Quien realmente adapta el registro (emojis, exclamaciones, vocabulario simple) es el modelo, guiado por esa instrucción. El Prompt Builder arma el pedido, no el estilo final del texto.
python
# ejemplo de referencia — mismo mecanismo con otro público
data = ProductDescriptionRequest(name="Set de Plastilina ColorMix", category="Juguetes",
                                  features=["12 colores"], audience="niños", tone="alegre")
Ver solución
python
data = ProductDescriptionRequest(
    name="Peluche Osito Lumi", category="Juguetes",
    features=["Se ilumina de noche", "Suave al tacto"],
    audience="niños", tone="divertido",
)
prompt = build_product_prompt(data)
assert "niños" in prompt
assert "divertido" in prompt
Ejercicio 27 — Prompt con público técnico y tono formal
Mismo ejercicio que el anterior, pero para un producto técnico: audience="ingenieros de sistemas", tone="técnico".
🎯 Qué deberías lograr: el prompt incluye ambos valores tal cual.
💡 ¿Sabías que…? — el mismo mecanismo sirve para cualquier extremo del espectro
Comparado con el ejercicio 26 (público infantil, tono divertido), este usa el extremo opuesto (público técnico, tono formal) — y el código que lo procesa es exactamente el mismo build_product_prompt. La diversidad de resultados no viene de tener casos especiales en el código, sino de que audience/tone son datos de entrada como cualquier otro campo.
python
# ejemplo de referencia — un tercer extremo: público mayorista, tono directo
data = ProductDescriptionRequest(name="Pallet de Tornillos Industrial", category="Ferretería",
                                  features=["500 unidades"], audience="mayoristas", tone="directo")
Ver solución
python
data = ProductDescriptionRequest(
    name="Router WiFi 6E MeshPro", category="Redes",
    features=["Cobertura 300m2", "6 antenas"],
    audience="ingenieros de sistemas", tone="técnico",
)
prompt = build_product_prompt(data)
assert "ingenieros de sistemas" in prompt
assert "técnico" in prompt
Ejercicio 28 — El Prompt Builder es determinista (a diferencia de la IA)
Llamá a build_product_prompt dos veces con el mismo ProductRequest y confirmá que el prompt generado es idéntico las dos veces.
🎯 Qué deberías lograr: prompt_1 == prompt_2 — el armado del prompt no tiene ninguna parte aleatoria.
💡 ¿Sabías que…? — determinismo del código vs. no-determinismo del modelo
Esto contrasta a propósito con lo que viste en la sección 8 ("Prueba real"): el mismo ProductRequest probado dos veces contra Gemini generó dos descripciones distintas (la IA no es determinística). Pero el paso anterior — construir el prompt — sí lo es: build_product_prompt es una función pura, sin aleatoriedad ni estado. La variabilidad entra recién cuando el texto sale del sistema y lo procesa el modelo.
python
# ejemplo de referencia — otra función determinista del proyecto
assert build_product_prompt(data) == build_product_prompt(data)  # siempre True
Ver solución
python
data = ProductDescriptionRequest(
    name="Peluche Osito Lumi", category="Juguetes",
    features=["Se ilumina de noche", "Suave al tacto"],
    audience="niños", tone="divertido",
)
prompt_1 = build_product_prompt(data)
prompt_2 = build_product_prompt(data)
assert prompt_1 == prompt_2
Ejercicio 29 — Los tres campos de la respuesta, siempre los mismos
Con un provider mockeado, confirmá que ProductDescriptionResponse devuelve exactamente las claves provider, model y description — ni una más, ni una menos — sin importar qué producto se le pida.
🎯 Qué deberías lograr: set(response.json().keys()) == {"provider", "model", "description"}.
💡 ¿Sabías que…? — un `response_model` es un contrato, no una sugerencia
@router.post(..., response_model=ProductDescriptionResponse) hace que FastAPI filtre la respuesta a esas tres claves exactas, aunque el provider devolviera algo con más campos por error. Es la misma idea de "contrato estable" que ya viste con POST /api/v1/ai/product-description en la pregunta 9 — el contrato no cambia aunque cambie el proveedor por dentro.
python
# ejemplo de referencia — mismo principio en otro endpoint
@router.get("/users/{id}", response_model=UserPublic)  # nunca filtra password_hash
Ver solución
python
class FakeProvider:
    def generate(self, system_guidance, prompt):
        return ("fake-model", "Descripción de prueba.")

with patch("app.routers.ai.get_ai_provider", return_value=FakeProvider()):
    r = client.post("/api/v1/ai/product-description", json={
        "name": "Parlante Portátil BoomWave", "category": "Audio",
        "features": ["Resistente al agua", "20 horas de batería"],
    })
    assert set(r.json().keys()) == {"provider", "model", "description"}
Ejercicio 30 — Dos providers mockeados, misma interfaz
Mockeá get_ai_provider dos veces en el mismo test — una devolviendo un FakeGemini y otra un FakeOpenAI, ambos implementando AIProvider — y confirmá que el endpoint responde 200 en los dos casos, con el model correspondiente a cada uno.
🎯 Qué deberías lograr: ambas llamadas devuelven 200, cada una con el model de su fake correspondiente.
💡 ¿Sabías que…? — esto es polimorfismo, no una coincidencia
Que el router funcione igual sin importar cuál de los dos fakes le inyectes es la prueba concreta de que AIProvider cumple su rol de interfaz: cualquier objeto que implemente generate(system_guidance, prompt) -> (str, str) sirve, sea GeminiProvider, OpenAIProvider, un FakeGemini de test, o un EchoProvider (ejercicio 16). El router nunca pregunta "¿sos Gemini u OpenAI?" — solo llama a .generate(...).
python
# ejemplo de referencia — mismo principio con otro contrato compartido
def total_a_pagar(carrito, calculadora_impuestos):  # cualquier objeto con .calcular()
    return carrito.subtotal + calculadora_impuestos.calcular(carrito)
Ver solución
python
class FakeGemini(AIProvider):
    def generate(self, system_guidance, prompt):
        return ("gemini-fake", "Descripción generada por Gemini simulado.")

class FakeOpenAI(AIProvider):
    def generate(self, system_guidance, prompt):
        return ("openai-fake", "Descripción generada por OpenAI simulado.")

payload = {"name": "Mesa de Trabajo FlexDesk", "category": "Muebles de oficina",
           "features": ["Altura ajustable", "Superficie 120x60cm"]}

for fake, esperado in [(FakeGemini(), "gemini-fake"), (FakeOpenAI(), "openai-fake")]:
    with patch("app.routers.ai.get_ai_provider", return_value=fake):
        r = client.post("/api/v1/ai/product-description", json=payload)
        assert r.status_code == 200
        assert r.json()["model"] == esperado
Ejercicio 31 — Medí cuánto tarda la llamada al proveedor
Con un provider mockeado que simula demora (time.sleep(0.05) dentro de generate), medí el tiempo total de la request desde el cliente y confirmá que refleja esa demora — sin loguear ni exponer ningún dato sensible en la medición.
🎯 Qué deberías lograr: el tiempo medido es >= 0.05 segundos.
💡 ¿Sabías que…? — medir performance no es lo mismo que loguear contenido
Podés (y en un proyecto real, deberías) instrumentar cuánto tarda cada llamada al proveedor de IA — es información operativa útil (¿está lento Gemini hoy?) — sin que eso implique loguear el prompt o la respuesta completa. Medir "cuánto" es distinto de exponer "qué" — la sección 5/8 ya estableció que el log solo lleva provider y product name, nunca el contenido.
python
# ejemplo de referencia — mismo patrón de medición en otro servicio
inicio = time.perf_counter()
resultado = servicio_externo.llamar()
logger.info("llamada externa tardó %.2fs", time.perf_counter() - inicio)
Ver solución
python
import time

class SlowFakeProvider:
    def generate(self, system_guidance, prompt):
        time.sleep(0.05)
        return ("slow-fake", "Descripción con demora simulada.")

with patch("app.routers.ai.get_ai_provider", return_value=SlowFakeProvider()):
    start = time.perf_counter()
    r = client.post("/api/v1/ai/product-description", json={
        "name": "Parlante Portátil BoomWave", "category": "Audio",
        "features": ["Resistente al agua", "20 horas de batería"],
    })
    elapsed = time.perf_counter() - start
    assert r.status_code == 200
    assert elapsed >= 0.05
Ejercicio 32 — Otro tipo de falla del proveedor: ConnectionError
El ejercicio 13 ya probó un TimeoutError. Ahora hacé que generate() lance un ConnectionError (simulando que Gemini es inalcanzable por red) y confirmá que el resultado es el mismo 502 genérico.
🎯 Qué deberías lograr: 502 con el mismo mensaje genérico del ejercicio 13, sin importar el tipo exacto de excepción.
💡 ¿Sabías que…? — el `except Exception` no distingue tipos de fallo de red
TimeoutError, ConnectionError, o cualquier excepción del SDK de Gemini que no sea RuntimeError caen todas en el mismo except Exception genérico del router — el cliente recibe siempre el mismo 502 con el mismo mensaje, sin importar la causa técnica exacta. Distinguir esos casos (reintentar en un timeout, no reintentar en un 401) es trabajo para una capa de reintentos (fuera del alcance de esta clase), no para lo que el cliente ve.
python
# ejemplo de referencia — mismo principio con otro tipo de error de red
except (TimeoutError, ConnectionError, OSError):
    logger.exception("Error de red hacia el proveedor")
    raise HTTPException(502, "No fue posible obtener respuesta del proveedor de IA")
Ver solución
python
class UnreachableProvider:
    def generate(self, system_guidance, prompt):
        raise ConnectionError("No se pudo establecer conexión con el proveedor")

with patch("app.routers.ai.get_ai_provider", return_value=UnreachableProvider()):
    r = client.post("/api/v1/ai/product-description", json={
        "name": "Impresora 3D MakerPro", "category": "Impresión 3D",
        "features": ["Volumen de impresión 25x25x25cm"],
    })
    assert r.status_code == 502
Ejercicio 33 — Postman: armar la request de un caso de error
En tu colección de Postman (sección 8), agregá una tercera request llamada "Error de validación" que mande features: [] al mismo endpoint, y guardá la respuesta 422 como referencia.
🎯 Qué deberías lograr: una request guardada en Postman que devuelve 422 de forma reproducible — útil para no tener que recordar cómo provocar ese error cada vez que quieras probarlo.
💡 ¿Sabías que…? — una colección no es solo para el "camino feliz"
Guardar también los casos de error (no solo el 200 exitoso) convierte tu colección de Postman en una suite de regresión manual: antes de un deploy, podés correr las 3 requests (Health, Product description, Error de validación) y confirmar de un vistazo que nada se rompió — mismo espíritu que los tests automatizados de pytest, pero para probar manualmente.
text
# ejemplo de referencia — otra request de error guardada en una colección
"Error 401" -> GET {{base_url}}/admin sin header Authorization -> 401 esperado
Ver solución
En Postman: click derecho sobre la colección → Add request → nombrarla "Error de validación" → mismo POST {{base_url_gateway}}/api/v1/ai/product-description → Body:
json
{"name": "Cualquier Producto", "category": "Cualquiera", "features": []}→ Send → confirmar 422 → Save Response para dejarlo como referencia.
Ejercicio 34 — Postman: una variable con el JSON completo
Creá una variable de Environment llamada producto_ejemplo con el JSON completo de un ProductRequest, y usala en el Body de la request con {{producto_ejemplo}} en vez de escribir el JSON a mano.
🎯 Qué deberías lograr: la request sigue funcionando igual (200), pero el Body ahora es solo {{producto_ejemplo}}.
💡 ¿Sabías que…? — las variables de Postman no son solo para URLs
{{base_url_gateway}} (sección 8) es el uso más común de una variable, pero Postman las reemplaza en cualquier parte de la request — headers, body, params. Guardar un payload de ejemplo completo como variable es útil cuando lo reusás en varias requests (por ejemplo, la misma data de producto contra distintos endpoints).
json
// ejemplo de referencia — otra variable con JSON completo
{{usuario_ejemplo}} = {"name": "Ana Torres", "email": "ana@example.com"}
Ver solución
En el Environment: variable producto_ejemplo con valor {"name": "Cámara Instantánea SnapMoment", "category": "Fotografía", "features": ["Impresión al instante", "Flash automático"]} — en el Body de la request, reemplazar el JSON completo por {{producto_ejemplo}} y confirmar que Postman lo expande antes de enviar (200 OK idéntico a mandarlo a mano).
Ejercicio 35 — Confirmá que GEMINI_MODEL se refleja en la respuesta
Cambiá GEMINI_MODEL en tu .env a un valor distinto (aunque sea inválido, para esta prueba) y confirmá, con un provider mockeado que lee settings.gemini_model, que ese valor aparece en el campo model de la respuesta.
🎯 Qué deberías lograr: el model de la respuesta coincide exactamente con lo que pusiste en GEMINI_MODEL, no un valor hardcodeado en el código.
💡 ¿Sabías que…? — el nombre del modelo también es configuración, no código
GeminiProvider.generate() devuelve settings.gemini_model (leído del .env), nunca un string fijo como "gemini-3.8-flash" escrito en gemini_provider.py. Esto significa que actualizar a un modelo nuevo de Gemini (cuando salga) es cambiar una variable de entorno, no tocar código — mismo principio de "sacar configuración del código" que ya viste con AI_PROVIDER.
python
# ejemplo de referencia — mismo patrón con otra configuración de modelo
class Settings(BaseSettings):
    whisper_model: str = "whisper-large-v3"  # cambiar el modelo = cambiar .env
Ver solución
python
from app.config import settings

class FakeProviderConModelo:
    def generate(self, system_guidance, prompt):
        return (settings.gemini_model, "Descripción de prueba.")

with patch("app.routers.ai.get_ai_provider", return_value=FakeProviderConModelo()):
    r = client.post("/api/v1/ai/product-description", json={
        "name": "Cámara Instantánea SnapMoment", "category": "Fotografía",
        "features": ["Impresión al instante"],
    })
    assert r.json()["model"] == settings.gemini_model
Ejercicio 36 — Reto: un cuarto proveedor real (estructura, sin llamar a nada externo)
Sin usar ningún SDK externo, creá la estructura de un ClaudeProvider (clase que hereda de AIProvider, con generate() implementado) que simplemente devuelva un texto fijo — el objetivo es practicar el patrón de extensión, no integrar una API real.
🎯 Qué deberías lograr: ClaudeProvider().generate(...) funciona igual que EchoProvider (ejercicio 16), sin heredar nada de GeminiProvider ni OpenAIProvider.
💡 ¿Sabías que…? — cada provider es independiente, no hay herencia entre ellos
GeminiProvider y OpenAIProvider (y ahora ClaudeProvider) no heredan entre sí — cada uno hereda directo de AIProvider. Esto evita que un cambio en la lógica de Gemini afecte por accidente a OpenAI: son implementaciones hermanas del mismo contrato, no una jerarquía de una heredando de otra.
python
# ejemplo de referencia — la estructura correcta (hermanos, no jerarquía)
class ProviderA(AIProvider): ...
class ProviderB(AIProvider): ...  # NO class ProviderB(ProviderA)
Ver solución
python
# app/providers/claude_provider.py
from app.providers.base import AIProvider


class ClaudeProvider(AIProvider):
    def generate(self, system_guidance: str, prompt: str) -> tuple[str, str]:
        return ("claude-stub", "Descripción generada por un stub de Claude.")
python
claude = ClaudeProvider()
model, text = claude.generate("guia", "Crea una descripción de una cámara")
assert model == "claude-stub"
Ejercicio 37 — Reto: registrar el cuarto proveedor en el factory
Continuando el ejercicio 36, agregá "claude" al get_ai_provider() para que AI_PROVIDER=claude devuelva tu ClaudeProvider.
🎯 Qué deberías lograr: con AI_PROVIDER=claude, el endpoint responde 200 usando tu stub, sin tocar app/routers/ai.py.
💡 ¿Sabías que…? — cuatro proveedores, un solo `if` más cada vez
Después de este ejercicio, factory.py soporta 4 proveedores (gemini, openai, echo, claude) y sigue siendo la única pieza que cambió respecto al proyecto original de la clase — ni el router, ni los schemas, ni el Prompt Builder se tocaron una sola vez en todo este recorrido. Esa es la métrica real de qué tan bien desacoplado quedó el Provider Interface.
python
# ejemplo de referencia — el factory completo con los 4
if provider == "claude": return ClaudeProvider()
Ver solución
python
# app/providers/factory.py
from app.providers.claude_provider import ClaudeProvider

def get_ai_provider() -> AIProvider:
    provider = settings.ai_provider.lower().strip()
    if provider == "gemini":
        return GeminiProvider()
    if provider == "openai":
        return OpenAIProvider()
    if provider == "echo":
        return EchoProvider()
    if provider == "claude":
        return ClaudeProvider()
    raise RuntimeError(f"Proveedor no soportado: {settings.ai_provider}")
bash
AI_PROVIDER=claude uvicorn app.main:app --reload
curl -X POST http://127.0.0.1:8000/api/v1/ai/product-description \
  -H "Content-Type: application/json" \
  -d '{"name": "Cámara Instantánea SnapMoment", "category": "Fotografía", "features": ["Impresión al instante"]}'
# 200 OK, usando ClaudeProvider
Ejercicio 38 — Comparar los 4 providers uno al lado del otro
Escribí un solo test parametrizado (o un loop) que pruebe GeminiProvider, OpenAIProvider, EchoProvider y ClaudeProvider sin llamar a ninguna API real — mockeando o usando directamente los que no necesitan key (Echo/Claude) — y confirmá que los 4 devuelven una tupla (str, str).
🎯 Qué deberías lograr: un test que recorre los 4 providers y confirma la forma de su retorno, sin gastar ninguna cuota real.
💡 ¿Sabías que…? — probar el contrato, no cada implementación por separado
En vez de escribir 4 tests casi idénticos (uno por provider), un test parametrizado prueba que todos cumplen el mismo contrato — exactamente lo que garantiza heredar de AIProvider. Si mañana agregás un quinto proveedor, alcanza con sumarlo a la lista de parámetros del test.
python
# ejemplo de referencia — mismo patrón con otro contrato compartido
import pytest

@pytest.mark.parametrize("provider", [EchoProvider(), ClaudeProvider()])
def test_todos_devuelven_tupla(provider):
    model, text = provider.generate("guia", "prompt de prueba")
    assert isinstance(model, str) and isinstance(text, str)
Ver solución
python
from app.providers.echo_provider import EchoProvider
from app.providers.claude_provider import ClaudeProvider

def test_providers_locales_devuelven_tupla_str_str():
    for provider in [EchoProvider(), ClaudeProvider()]:
        model, text = provider.generate("guia", "Crea una descripción de prueba")
        assert isinstance(model, str)
        assert isinstance(text, str)
        assert len(text) > 0
📝
GeminiProvideryOpenAIProviderquedan fuera de este loop porque su__init__exige una API key real (RuntimeErrorsi falta) — probarlos acá requeriría además mockeargenai.Client/OpenAI, fuera del alcance de este ejercicio.
Ejercicio 39 — Reto: un producto con datos al límite de todo a la vez
Construí un ProductRequest que esté simultáneamente en el límite de varios campos: name de exactamente 120 caracteres, features con exactamente 8 elementos, y audience/tone en sus valores por defecto (sin pasarlos). Confirmá que pasa la validación y que el prompt se arma bien.
🎯 Qué deberías lograr: el ProductRequest se construye sin error y build_product_prompt genera un texto que incluye las 8 características.
💡 ¿Sabías que…? — los bugs reales aparecen en la combinación de bordes, no en uno solo
Los ejercicios 22-25 probaron cada límite por separado. Este ejercicio los combina — es el tipo de caso que un test unitario aislado por campo puede no detectar, pero que sí aparece en producción cuando un cliente real manda un producto con nombre largo y muchas características a la vez. Combinar bordes es una técnica real de testing, no solo un ejercicio académico.
python
# ejemplo de referencia — combinar dos bordes en otro modelo
Pedido(items=[...8 items...], notas="a" * 500)  # ambos en su máximo a la vez
Ver solución
python
data = ProductDescriptionRequest(
    name="P" * 120,
    category="Equipamiento industrial",
    features=[f"Característica técnica número {i}" for i in range(8)],
)
prompt = build_product_prompt(data)
assert len(data.name) == 120
assert len(data.features) == 8
for i in range(8):
    assert f"Característica técnica número {i}" in prompt
Ejercicio 40 — Reto final: pipeline completo con un producto propio
Elegí un producto que no se haya usado en ningún ejercicio anterior de esta clase, y escribí un solo test de integración que recorra el pipeline completo: validación del schema → build_product_prompt → provider mockeado que confirma que su nombre aparece en el prompt recibido → respuesta con las 3 claves esperadas.
🎯 Qué deberías lograr: un test que, en un solo bloque, prueba de punta a punta lo mismo que viste separado en toda la clase — sección 8 (recorrido de la request), sección 3 (prompt seguro) y sección 4 (Provider Interface) — con datos 100% tuyos.
💡 ¿Sabías que…? — un test de integración no reemplaza a los unitarios, los completa
Todos los ejercicios anteriores probaron una pieza a la vez (el schema, el Prompt Builder, el provider, el router) — eso es lo que hace que, si algo falla, sepas exactamente dónde mirar. Este último test prueba que todas esas piezas ya verificadas por separado también funcionan juntas — es el complemento, no el reemplazo, de los tests unitarios (mismo principio que ya viste con el pipeline de CI/CD de la Clase 11: pruebas rápidas y unitarias primero, un chequeo de extremo a extremo al final).
python
# ejemplo de referencia — misma idea, un test de integración de otro flujo
def test_pipeline_completo_de_checkout():
    orden = crear_orden(...)
    factura = generar_factura(orden)
    assert factura.total == orden.subtotal + orden.impuestos
Ver solución
python
class FakeProviderE2E(AIProvider):
    def generate(self, system_guidance, prompt):
        assert "Cortadora de Césped EcoMow" in prompt
        return ("fake-e2e", "Descripción end-to-end generada.")

def test_pipeline_completo_end_to_end():
    with patch("app.routers.ai.get_ai_provider", return_value=FakeProviderE2E()):
        r = client.post("/api/v1/ai/product-description", json={
            "name": "Cortadora de Césped EcoMow", "category": "Jardinería",
            "features": ["Motor eléctrico", "Bolsa recolectora 40L"],
            "audience": "propietarios de jardín", "tone": "práctico",
        })
        body = r.json()
        assert r.status_code == 200
        assert set(body.keys()) == {"provider", "model", "description"}
        assert body["model"] == "fake-e2e"
❓ Preguntas y respuestas (autoevaluación)
1. ¿Cuál es la diferencia entre las "características" de un producto y su "descripción comercial"?
Las características son datos técnicos y estructurados que el sistema ya tiene cargados (talla, material, RAM). La descripción comercial es el texto de venta que ve el cliente en el catálogo. El reto de la clase es convertir lo primero en lo segundo, usando la IA solo como redactora — nunca como fuente de los datos.
2. ¿Por qué la IA nunca debe ser la fuente de verdad del catálogo?
Porque puede alucinar: inventar una característica, un precio o una talla que no existe si el prompt no le da datos concretos. La fuente de verdad siempre es el sistema (la base de datos/
ProductRequest); la IA solo transforma esos datos en lenguaje comercial.
3. ¿Qué tres componentes tiene un prompt seguro, según la fórmula de la clase?
DATOS + INSTRUCCIÓN + RESTRICCIONES. Datos verificados del sistema, una instrucción clara de qué generar (y con qué límite), y restricciones explícitas sobre qué no hacer ("no inventes especificaciones").
4. ¿Qué patrón resuelve la dependencia directa de un proveedor de IA, y cómo se llama el componente que lo implementa en OrderFlow?
El patrón Adapter (una interfaz propia que abstrae al proveedor real). En
OrderFlowse llama Provider Interface (AIProvider, una clase abstracta con un métodogenerate()), conGeminiProvideryOpenAIProvidercomo implementaciones concretas intercambiables.
5. ¿Por qué borrar el commit que subió una API key a GitHub no alcanza para protegerla?
Porque el valor sigue presente en el historial de Git — cualquiera con acceso al repo (o a un fork/clon previo) puede recuperarlo con
git log -p. La única forma de neutralizar el riesgo es rotar/revocar la key en el proveedor.
6. En el código real, ¿por qué get_ai_provider() puede devolver GeminiProvider u OpenAIProvider sin que el router lo sepa?
Porque es una Factory: lee
settings.ai_providery decide, en tiempo de ejecución, qué clase concreta instanciar. El router solo llama aget_ai_provider()y usa el resultado a través de la interfazAIProvider— nunca importaGeminiProviderniOpenAIProviderdirectamente.
7. ¿Cuál es la diferencia entre el bloque "environment" y el bloque "secrets" en un ECS Task Definition?
"environment"guarda configuración en texto plano, visible en la consola de AWS (solo para valores no sensibles, comoAI_PROVIDER)."secrets"guarda una referencia (ARN) a un parámetroSecureStringen AWS Systems Manager Parameter Store — el valor real (la API key) se resuelve cifrado recién al arrancar el contenedor, nunca queda expuesto en la definición de la tarea.
8. ¿Por qué los tests de este proyecto (test_prompting.py, test_health.py) no llaman nunca a Gemini u OpenAI real?
Porque un test que dependa de una API externa real sería lento, costaría dinero en cada ejecución del pipeline de CI/CD (Clase 11), y fallaría si el proveedor está caído — nada de eso debería tumbar el pipeline de
OrderFlow. Por eso solo se testea la lógica propia (el armado del prompt, el health check) o se usa un provider mockeado.
9. Si mañana OrderFlow migrara de Gemini a OpenAI en producción, ¿qué habría que tocar además de configurar la nueva API key?
Idealmente, solo la variable de entorno
AI_PROVIDER(degeminiaopenai). Ni el router, ni el schema, ni el contrato del endpoint (POST /api/v1/ai/product-description) deberían cambiar — si hiciera falta tocarlos, es señal de que el proveedor se filtró fuera del Provider Interface.
10. ¿Qué pasa si intentás instanciar AIProvider() directamente, y por qué?
Python lanza
TypeError, porqueAIProviderhereda deABCy declaragenerate()como@abstractmethodsin implementación. Una clase abstracta con métodos abstractos pendientes no puede instanciarse — solo una subclase que implemente todos esos métodos (comoGeminiProvideruOpenAIProvider).
11. ¿Qué es un ProductRequest y de dónde saca sus datos el Prompt Builder?
Es el payload JSON (
name,category,features,audience,tone) que armaOrderFlowcon los datos ya verificados de un producto. El Prompt Builder (build_product_prompt) toma exclusivamente esos campos — no tiene ninguna otra fuente de información sobre el producto.
12. ¿Qué diferencia hay entre Field(min_length=1, max_length=8) aplicado a features (una lista) y aplicado a name (un string)?
Sobre una lista,
min_length/max_lengthcuentan elementos (1 a 8 características). Sobre un string, cuentan caracteres (2 a 120). Es el mismo parámetro de Pydantic, pero su unidad depende del tipo del campo.
13. ¿Por qué gemini_api_key: str | None = None usa None como default en vez de una cadena vacía ""?
Porque
Nonerepresenta de forma explícita "todavía no configurado" — un estado distinto de "configurado pero vacío". Si el default fuera"",GeminiProvider.__init__tendría que revisarif not settings.gemini_api_keyigual, pero perdería la claridad semántica de "esto es opcional y puede faltar" questr | Nonecomunica al leer el código.
14. ¿Qué pasa si mandás AI_PROVIDER=OPENAI (todo en mayúsculas) al servicio?
Funciona igual que
openaien minúsculas —settings.ai_provider.lower().strip()normaliza la entrada antes de comparar. El factory nunca ve la diferencia entre mayúsculas, minúsculas o espacios de más.
15. ¿Cuál es la diferencia entre cómo Gemini y OpenAI reciben las instrucciones del sistema?
GeminiProviderconcatenasystem_guidancey elprompten un solo string (input=f"{system_guidance}\n\n{prompt}").OpenAIProviderlos manda separados:instructions=system_guidanceeinput=promptcomo parámetros distintos deresponses.create(). Cada SDK espera un formato distinto — y esa diferencia queda encapsulada dentro de cada provider, nunca sale hacia el router.
16. ¿Por qué el router nunca importa GeminiProvider ni OpenAIProvider directamente?
Porque solo conoce la interfaz
AIProvider(víaget_ai_provider()). Si importara las clases concretas, el router quedaría acoplado a un proveedor específico — exactamente el riesgo de "dependencia directa" de la sección 2.
17. ¿Qué pasaría si get_ai_provider() no lanzara una excepción para un proveedor desconocido, sino que devolviera None?
El error se movería más adelante y sería más confuso: en vez de un
RuntimeErrorclaro ("Proveedor no soportado: azure") en el momento de pedir el provider, tendrías unAttributeErrorcríptico ("NoneTypeobject has no attributegenerate") varias líneas después, enprovider.generate(...). Fallar rápido y explícito (ejercicio 9) evita ese tipo de error confuso.
18. ¿Por qué mockear app.providers.factory.get_ai_provider no afecta al test del endpoint, pero mockear app.routers.ai.get_ai_provider sí?
Porque
app/routers/ai.pyhizofrom app.providers.factory import get_ai_provider— eseimportcopia una referencia a la función dentro del namespace deapp.routers.ai. Parchear el nombre en el módulo original no cambia la referencia que el router ya tiene guardada; hay que parchear el nombre donde se usa, no donde se define.
19. ¿Qué diferencia de comportamiento hay entre lanzar un RuntimeError y dejar que se propague una excepción genérica, dentro del router?
RuntimeErrorse traduce a503(falla de configuración/disponibilidad, mensaje específico). Cualquier otra excepción cae en elexcept Exceptiongenérico y se traduce a502con un mensaje fijo — el detalle real solo queda en el log del servidor (logger.exception), nunca en la respuesta.
20. ¿Por qué el AI Service loguea el provider y el nombre del producto, pero nunca el prompt completo ni la API key?
Porque el prompt puede contener datos del producto que no hace falta exponer en logs, y la API key es una credencial — si un log queda expuesto (por un sistema de monitoreo mal configurado, por ejemplo), no debería filtrar ni la key ni el contenido completo enviado a un tercero.
21. ¿Qué es AWS Systems Manager Parameter Store y qué rol cumple en el Task Definition de ECS?
Es el servicio de AWS donde se guardan configuración y secretos (
SecureString) fuera del código. En el Task Definition, un secreto referenciado ahí (por ARN) se resuelve e inyecta cifrado como variable de entorno recién al arrancar el contenedor — nunca queda en texto plano en la definición de la tarea.
22. ¿Por qué AI_PROVIDER va en "environment" del Task Definition pero GEMINI_API_KEY va en "secrets"?
Porque
AI_PROVIDERno otorga acceso a nada por sí solo (solo dice "gemini" u "openai") — es seguro tenerlo en texto plano.GEMINI_API_KEYsí da acceso directo a la cuenta de IA deOrderFlow, así que necesita quedar cifrada y resuelta en tiempo de ejecución, no expuesta en la definición.
23. ¿Qué permiso IAM mínimo necesita el ecsTaskExecutionRole para leer la API key desde Parameter Store?
ssm:GetParameters, con elResourceacotado al ARN exacto del parámetro (arn:aws:ssm:...:parameter/orderflow/gemini-api-key) — no un*genérico. Es el mismo principio de mínimo privilegio de IAM visto en la Clase 8.
24. ¿Qué significa que google-genai haya tenido un breaking change de la versión 1.x a la 2.x, y por qué el rango en requirements.txt importa?
En versionado semántico, un salto de versión MAYOR (1→2) señala que puede romper compatibilidad hacia atrás — acá rompió del lado del servidor: Google dejó de soportar el schema viejo de la Interactions API. Un
requirements.txtcon>=1.0,<2.0seguía "permitiendo" instalar una versión ya incompatible con la API real.
25. Sin ver el código, ¿cómo distinguís si un error del proveedor de IA es por una API key inválida o por un SDK desactualizado?
Por el código de estado y el mensaje: una key inválida da un error de autenticación (401/403). Un SDK desactualizado frente a un breaking change de la API da un 400 Bad Request con un mensaje sobre el formato del request (como el "legacy Interactions API schema" real de esta clase) — la request llegó y se procesó, pero el formato ya no es válido.
26. En el diagrama de secuencia de la sección 8, ¿en qué mensaje se concatenan SYSTEM_GUIDANCE y el prompt del producto?
En el mensaje
GeminiProvider → Gemini API(interactions.create(input=...)) — el mensaje marcado en coral. Es el único punto de todo el flujo donde ambos textos se combinan en un solo string antes de salir del sistema.
27. ¿Por qué el Prompt Builder y el Provider Interface son dos responsabilidades separadas, en vez de una sola función que arme todo?
Porque resuelven riesgos distintos: el Prompt Builder decide qué datos entran al prompt (seguridad y calidad de la información, sección 3); el Provider Interface decide a quién se le manda y en qué formato cada SDK lo espera (flexibilidad de proveedor, sección 4). Mezclarlas volvería a acoplar el sistema a un proveedor específico.
28. En un diagrama de secuencia, ¿cómo se distingue visualmente una llamada síncrona de un mensaje de retorno?
La llamada síncrona es una flecha sólida con punta rellena. El retorno es una flecha punteada (
stroke-dasharray) también con punta rellena (nunca abierta — la punta abierta se reserva para mensajes asíncronos tipo "fire-and-forget").
29. En la arquitectura final de OrderFlow (sección 7), ¿qué microservicio publica el evento que termina disparando al AI Service?
Orders— publica a SNS cuando se crea un pedido; SNS reparte (fan-out) a una cola SQS de inventario y a otra de notificaciones, y esta última es la que alimenta al AI Service.
30. ¿Por qué SNS + SQS (Clase 9) conecta a Products/Orders con el AI Service en vez de una llamada HTTP directa?
Porque desacopla: quien publica el evento (
Orders) no necesita saber que el AI Service existe, ni esperar su respuesta, ni que esté disponible en ese momento. Es el mismo principio de desacoplamiento aplicado a mensajería en vez de a un proveedor de IA — la Clase 12 lo repite a nivel arquitectura.
31. ¿Qué tienen en común el Repository Pattern (Clase 4) y el Provider Interface (Clase 12)?
Ambos hacen que el código de negocio hable contra una interfaz (
ProductRepository,AIProvider) en vez de una implementación concreta (PostgreSQL,Gemini). Cambiar la implementación de atrás no obliga a tocar quien la consume — el mismo patrón aplicado a dos capas distintas.
32. ¿Qué diferencia hay entre validar con Field(...) y validar con @field_validator en Pydantic?
Field()cubre validaciones estructurales simples y declarativas (longitud, rango, cantidad de elementos).@field_validatorpermite lógica de negocio arbitraria (una regla propia, como sumar caracteres de toda una lista) que no tiene un parámetro dedicado enField().
33. ¿Por qué un @field_validator sobre features puede asumir que la lista ya tiene entre 1 y 8 elementos, sin volver a chequearlo?
Porque Pydantic ejecuta las validaciones de
Field()(min_length,max_length) antes que los@field_validatorpersonalizados — para cuando tu función corre, esas garantías estructurales ya se cumplieron.
34. ¿Qué pasaría si ProductDescriptionRequest no limitara max_length en features, y un cliente mandara 500 características?
El prompt resultante sería enorme: más costo por token hacia el proveedor de IA, más tiempo de respuesta, y más superficie para que el modelo se disperse o alucine con tanto texto de entrada. El límite superior es, indirectamente, control de costo y de calidad del resultado.
35. ¿Por qué probar el endpoint desde Postman y desde curl produce exactamente la misma request HTTP?
Porque ambos son solo clientes distintos armando el mismo método, URL, headers y body — lo que viaja por la red es idéntico. La diferencia es únicamente de interfaz: Postman guarda la request, muestra historial y permite variables de Environment;
curlno.
36. ¿Qué ventaja tiene usar una variable de Environment ({{base_url_gateway}}) en Postman en vez de escribir la URL completa en cada request?
Si el host o el puerto cambian (por ejemplo, al desplegar en ECS con otro dominio), se actualiza un solo lugar (la variable) en vez de editar cada request guardada una por una.
37. ¿Qué significa que Gemini "no sea determinístico", y por qué eso no es un problema de seguridad si el prompt está bien construido?
Significa que el mismo input puede generar redacciones distintas en cada llamada (confirmado en la sección 8: el mismo
ProductRequestgeneró dos descripciones distintas de la Mochila Urbana X). No es un problema de seguridad porque la variabilidad es solo de redacción — los datos que puede usar siguen acotados por elProductRequesty las restricciones delSYSTEM_GUIDANCE; lo que puede cambiar es el estilo, no los hechos.
38. ¿Por qué el AI Service usa un usuario no-root (appuser) en el Dockerfile en vez de correr como root?
Para reducir el daño posible si alguien lograra ejecutar código arbitrario dentro del contenedor (por una vulnerabilidad en el servicio o en una dependencia) — con un usuario sin privilegios de
root, ese código arbitrario queda más limitado dentro del propio contenedor.
39. Si tuvieras que agregar un cuarto proveedor de IA (por ejemplo, Claude), ¿qué archivos tocarías como mínimo, según el diseño de esta clase?
Un archivo nuevo (
claude_provider.pycon una claseClaudeProvider(AIProvider)) y una línea nueva enfactory.py(if provider == "claude": return ClaudeProvider()). Niapp/routers/ai.pyniapp/main.pydeberían cambiar — es la prueba de que el Provider Interface desacopla de verdad (mismo razonamiento del ejercicio 17).
40. Resumen final — enumerá, en una frase cada uno, los 4 riesgos de la sección 2 y dónde se resuelve cada uno.
- API keys expuestas en GitHub → nunca hardcodear, usar
.envlocal y AWS Systems Manager Parameter Store en producción (sección 5).- Datos sensibles enviados al proveedor → validación de longitud/tipo en el schema +
SYSTEM_GUIDANCEque restringe el contenido (sección 8).- Información inventada por la IA → prompt con solo datos verificados + restricción explícita de no inventar (sección 3).
- Dependencia directa del proveedor → Provider Interface + Factory, intercambiable con una variable de entorno (sección 4).
📎 Apuntes relacionados
- Clase 5 — diseño del proyecto
OrderFlowy principio de desacoplamiento. - Clase 6 — patrón
Settings(BaseSettings)reutilizado enapp/config.py. - Clase 8 — IAM de mínimo privilegio, aplicado acá al
ecsTaskExecutionRole. - Clase 9 — SNS/SQS, el mecanismo que dispara al AI Service en la arquitectura final.
- Clase 11 — pipeline de CI/CD y la filosofía de tests que no llaman a servicios externos.
- 00-Notas/02-Conceptos.md — resumen de "de características a descripción comercial" y "Provider Interface".
➡️ Siguiente
(fin del curso — pasar a 90-Resumen)