Apariencia
📙 Clase 8 — Microservicios Serverless con AWS
Python para Backend · 2026-09-01 · Carpeta:
02-Ejercicios/Clase-08/PYT30JUL26/S08⬅️ Volver al índice de clases
🎯 Qué aprendí
- Arquitectura serverless:
Amazon API Gateway (HTTP API)→AWS Lambda (Python 3.12)→Amazon DynamoDB, sin un solo servidor que administrar - Modelar una tabla DynamoDB de partition key simple (
product_id) conPAY_PER_REQUEST(sin aprovisionar capacidad) - Operaciones condicionales atómicas de DynamoDB (
ConditionExpression) para evitar condiciones de carrera: crear sin duplicar, no dejar stock negativo, no reservar más de lo disponible - Un límite real de sintaxis de DynamoDB:
ConditionExpressionno admite aritmética (campo + :valor) — soloUpdateExpressionla admite. Bug real encontrado y corregido en el código de la sesión - IAM de mínimo privilegio: una policy que solo permite
GetItem/PutItem/UpdateItemsobre UNA tabla puntual, ni un permiso de más - Infraestructura como código con AWS SAM (
template.yaml): un solo archivo declara el HTTP API, la tabla DynamoDB y la función Lambda, consam build/sam deploy - Dos formas de tener el mismo Lambda desplegado: pegado a mano en el editor de la consola AWS (
console_lambda/) vs. como código versionado con SAM (src/inventory/) — mismo servicio, dos caminos con trade-offs distintos - Simular eventos de API Gateway sin desplegar nada, con archivos JSON de
events/(parasam local invoke)
🗺️ Índice
Ancla directo a cualquier sección — todos los enlaces apuntan dentro de esta misma página (
01-Clases/Clase-08). La numeración (1., 2., 3.…) es la que ya trae cada título, no una numeración aparte.
⚠️ Antes de leer: esta clase tiene DOS CAMINOS alternativos, no secuenciales (no hace falta hacer los dos, ni en este orden):
Camino Quién lo hizo, en esta nota Dónde está documentado 🖱️ Consola de AWS, a mano El profesor (capturas propias en vivo) Sección 8 ( console_lambda/) — clic por clic: código de la Lambda, corregir su rol IAM (el ARN con región equivocada), crear el HTTP API💻 Código + CLI (SAM) Styp, con su propia cuenta AWS, de punta a punta Secciones 5-7, 9-10 ( src/inventory/) —sam build,sam deploy --guided, probado concurlreal contra la URL públicaLos dos terminan en el mismo resultado (una Lambda
orderflow-inventoryfuncionando) — la numeración de las secciones es solo el orden de LECTURA de estas notas, no un orden que haya que EJECUTAR. El camino que de verdad se probó de punta a punta, con cuenta propia ycurlcontra una URL real, fue el de SAM (ver 🧭 Tu propio despliegue real, pieza por pieza en la sección 2, y el resultado real desam deployen la sección 10).
- 🎯 Qué aprendí
- 📖 PARTE TEÓRICA
- 💻 PARTE PRÁCTICA
- 🗂️ 5. Estructura del proyecto (02-Ejercicios/Clase-08/PYT30JUL26/S08)
- 📦 6. template.yaml — la infraestructura como código (SAM)
- 🧩 7. src/inventory/app.py y responses.py — el Lambda desplegado con SAM
- 🖥️ 8. console_lambda/lambda_function.py — la misma lógica, a mano en la consola
- 🧪 9. events/*.json — simular API Gateway sin desplegar
- 🚀 10. Desplegar, probar y limpiar los recursos
- 🏋️ 11. EJERCICIOS CON SOLUCIÓN
- ❓ Preguntas y respuestas (autoevaluación)
- 📎 Apuntes relacionados
- ➡️ Siguiente
📖 PARTE TEÓRICA
📚 1. Definiciones clave
Serverless en AWS
| Término | Qué es | Se profundiza en |
|---|---|---|
| Serverless | Modelo donde el proveedor cloud (AWS) administra los servidores por vos: no hay una instancia fija corriendo 24/7 — el código solo se ejecuta cuando algo lo dispara (una petición HTTP), y se paga por invocación, no por hora de servidor prendido. | Sección 2 |
| AWS Lambda | El servicio de cómputo serverless de AWS: subís una función (acá, Python) y AWS la ejecuta bajo demanda, la escala sola (de 0 a miles de invocaciones simultáneas) y la apaga cuando no hay tráfico. | Sección 2 |
| Amazon API Gateway | El servicio que expone una URL pública HTTP y la conecta con un backend (acá, una Lambda) — es la puerta de entrada, similar en espíritu al API Gateway Pattern de la Clase 7, pero acá lo provee AWS en vez de programarlo a mano. | Sección 2 |
| HTTP API (vs. REST API) | El tipo de API Gateway más simple y barato de los dos que ofrece AWS — menos funciones avanzadas que "REST API" (el tipo más viejo), pero de sobra para este servicio: rutas, métodos, CORS. | Sección 2 |
routeKey | El campo del evento que le llega a la Lambda cuando la dispara un HTTP API (formato "MÉTODO /ruta", ej. "GET /health") — así una sola función sabe qué endpoint la llamó, sin tener 5 Lambdas separadas. | Secciones 2 y 7 |
| Cold start | La primera invocación de una Lambda después de un rato sin tráfico tarda más (AWS tiene que inicializar el entorno de ejecución desde cero); las siguientes, mientras el entorno siga "caliente", son más rápidas. | Sección 2 |
def lambda_handler(event, context) | El contrato fijo que AWS exige en cualquier función Lambda de Python: exactamente 2 parámetros posicionales. event es el dato que disparó la invocación (acá, el request de API Gateway); context es un objeto que AWS inyecta con metadatos de ESTA ejecución puntual (aws_request_id, tiempo restante, nombre/versión de la función) — nunca datos del negocio. | Sección 7 |
event | Un dict de Python con la forma exacta que define el servicio que disparó la Lambda — para un HTTP API (esta clase) trae routeKey, rawPath, pathParameters, body, etc. (ver events/*.json, sección 9); para otro disparador (S3, SQS) tendría una forma totalmente distinta. | Secciones 7 y 9 |
context | Objeto que Lambda arma y pasa en cada invocación (no un dict, un objeto con atributos: context.aws_request_id, context.get_remaining_time_in_millis(), etc.) — sirve para logging/trazabilidad y para reaccionar si la ejecución se está por quedar sin tiempo, nunca para leer el request en sí (eso es trabajo de event). | Sección 7 |
| CloudWatch Logs | El servicio de AWS donde Lambda manda automáticamente todo lo que la función escribe con print/logging (o el Log output que ya se vio en la consola, sección 8) — cada invocación queda com su propio Request ID, buscable después. | Sección 8 |
Amazon DynamoDB
| Término | Qué es | Se profundiza en |
|---|---|---|
boto3 | El SDK oficial de AWS para Python — la librería que traduce llamadas de Python (table.get_item(...), table.put_item(...)) en requests HTTP reales contra los servicios de AWS (DynamoDB, S3, Lambda, etc.), con autenticación y reintentos ya resueltos. Es la única dependencia de producción del servicio (requirements.txt, sección 5). | Sección 7 |
| DynamoDB | Base de datos NoSQL de clave-valor/documentos de AWS, totalmente administrada — sin servidor propio que instalar, escala sola y no tiene un schema fijo de columnas (cada item puede tener atributos distintos, salvo la clave). | Sección 3 |
| Partition key | El atributo que identifica de forma única cada item de la tabla (acá, product_id) — DynamoDB lo usa para decidir en qué partición física guarda el dato. Es el equivalente conceptual a una clave primaria simple en SQL, sin poder combinarse con otras columnas salvo que se declare también una sort key (no es el caso acá). | Sección 3 |
PAY_PER_REQUEST | Modo de facturación de DynamoDB: se paga por lectura/escritura real hecha, sin reservar capacidad fija de antemano (el otro modo, PROVISIONED, exige estimar y pagar una capacidad fija, la uses o no). Ideal para tráfico impredecible o de práctica. | Sección 3 |
ConditionExpression | Una condición que DynamoDB evalúa en el servidor, de forma atómica, antes de aplicar un PutItem/UpdateItem/DeleteItem — si la condición no se cumple, la operación entera se cancela (nada queda a medio aplicar). Es el mecanismo que evita condiciones de carrera sin necesitar un lock manual. | Sección 3 |
UpdateExpression | El lenguaje de DynamoDB para describir qué cambiar en un item existente (SET campo = campo + :delta) — a diferencia de ConditionExpression, este SÍ admite aritmética, porque describe una escritura, no una comparación. | Sección 3 |
ConditionalCheckFailedException | La excepción concreta que boto3 lanza cuando una ConditionExpression no se cumplió — se atrapa con except ClientError y se distingue mirando exc.response["Error"]["Code"]. | Sección 3 |
Decimal | DynamoDB no tiene un tipo float nativo — todos los números se guardan y devuelven como Decimal de Python (más preciso, sin errores de redondeo binario). Por eso el proyecto necesita un JSONEncoder propio (DecimalEncoder) para poder convertir la respuesta a JSON. | Sección 7 |
AWS SAM (Serverless Application Model)
| Término | Qué es | Se profundiza en |
|---|---|---|
| AWS SAM | Una extensión de CloudFormation (Infrastructure as Code de AWS) pensada específicamente para apps serverless — con AWS::Serverless::Function, AWS::Serverless::HttpApi, etc., en vez de tener que escribir CloudFormation "crudo" mucho más verboso. | Sección 6 |
template.yaml | El archivo donde SAM declara TODA la infraestructura del servicio (API, tabla, función, permisos) como texto versionable — es el equivalente serverless de un docker-compose.yaml o de las migraciones de Alembic: la infraestructura queda en el repo, no solo en la consola de AWS. | Sección 6 |
sam build | Empaqueta el código y sus dependencias (requirements.txt) en el formato que Lambda necesita, sin subir nada todavía. | Sección 10 |
sam deploy --guided | Sube el paquete y crea/actualiza los recursos reales en AWS (vía CloudFormation) — el flag --guided hace preguntas interactivas (nombre del stack, región) la primera vez y las guarda para las siguientes. | Sección 10 |
sam local invoke | Corre la Lambda en tu máquina (con Docker) pasándole un evento de prueba — sirve para probar la lógica sin desplegar nada a AWS todavía. | Secciones 9 y 10 |
CodeUri | Dentro de template.yaml, la carpeta local que SAM empaqueta y sube como el código de la función (src/inventory/) — todo lo que esa carpeta importe entre sí (como app.py importando responses.py) viaja junto. | Sección 6 |
Handler (app.lambda_handler) | Le dice a Lambda qué función Python llamar cuando llega un evento: archivo.funcion (sin .py) — acá, la función lambda_handler dentro de app.py. | Sección 6 |
IAM y seguridad
| Término | Qué es | Se profundiza en |
|---|---|---|
| IAM (Identity and Access Management) | El servicio de AWS que controla quién puede hacer qué sobre qué recursos — cada Lambda corre con un rol IAM que define sus permisos; sin el permiso explícito, la acción se rechaza aunque el código la intente. | Sección 4 |
| Root user | El usuario que se crea automáticamente al abrir la cuenta AWS (login con el email de registro) — tiene acceso total, sin restricciones posibles, ni siquiera con una IAM policy. Por eso AWS mismo recomienda no usarlo para el trabajo diario. | Sección 5 |
| Usuario de IAM (IAM user) | Una identidad separada del root, creada dentro de la cuenta (IAM → Usuarios de IAM → Crear persona), con sus propias credenciales (contraseña de consola y/o access keys) y los permisos que se le asignen vía IAM policies — nunca más de lo que se le dio explícitamente. Es la identidad recomendada para el uso diario. | Sección 5 |
| Rol IAM (IAM role) | Parecido a un usuario de IAM en que también lleva policies de permisos, pero no tiene credenciales propias para loguearse — lo "asume" temporalmente otra cosa (una Lambda, un servicio de AWS, o una persona vía switch role). Es lo que usa InventoryFunction para hablarle a DynamoDB (secciones 4 y 6), no un usuario. | Secciones 4 y 6 |
| IAM policy | Un documento JSON que declara permisos: qué Action (ej. dynamodb:GetItem) están permitidas (Effect: Allow) sobre qué Resource (el ARN de un recurso puntual, o * para todos). | Sección 4 |
| Principio de mínimo privilegio | Dar exactamente los permisos que una pieza necesita para hacer su trabajo, ni uno más — así, si algo se compromete (un bug, una credencial filtrada), el daño posible queda acotado. | Sección 4 |
DynamoDBCrudPolicy | Una policy predefinida que trae SAM (AWS::Serverless::Function.Policies) que arma automáticamente los permisos típicos de CRUD (GetItem, PutItem, UpdateItem, DeleteItem, Query, Scan...) sobre UNA tabla puntual — evita escribir el JSON de permisos a mano. | Secciones 4 y 6 |
☁️ 2. Arquitectura serverless: API Gateway → Lambda → DynamoDB
El servicio de esta clase (OrderFlow Inventory) tiene una arquitectura de tres piezas, todas administradas por AWS — no hay un solo servidor propio que instalar, actualizar ni escalar a mano:
🗺️ Diagrama: arquitectura de OrderFlow Inventory Serverless
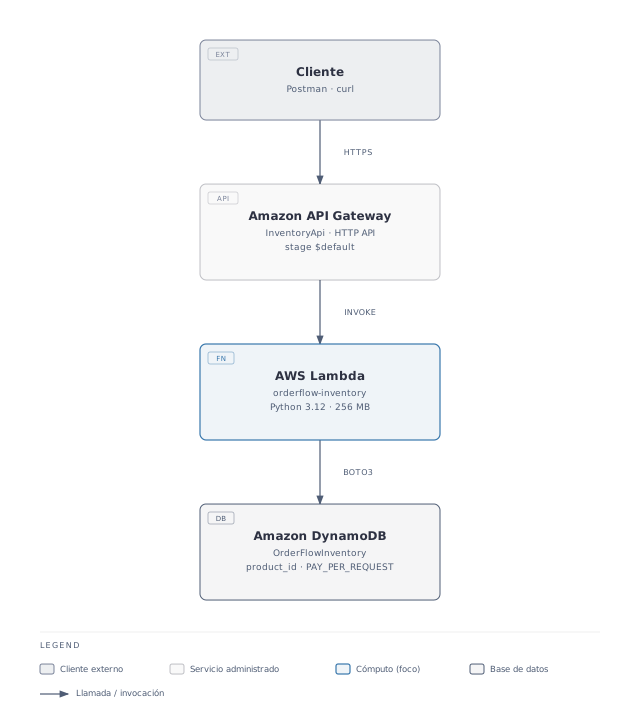
Leyendo el diagrama de arriba a abajo — el mismo camino que recorre una petición real:
| Pieza | Qué es | Se detalla en |
|---|---|---|
| Cliente | Quien arma el request HTTP (Postman, curl, o cualquier otro cliente) — le habla siempre al API Gateway, nunca directo a la Lambda | Secciones 8 y 10 |
HTTPS → | El cliente entra por acá; es el único punto de entrada público de todo el servicio | — |
Amazon API Gateway (InventoryApi) | La puerta de entrada administrada por AWS — recibe la petición, la matchea contra una de sus 5 rutas y arma el evento que le pasa a la Lambda | Secciones 2 y 8 |
INVOKE → | El evento que arma API Gateway trae el campo routeKey ("MÉTODO /ruta") — es lo único que la Lambda necesita para saber qué endpoint la llamó | Sección 7 |
AWS Lambda (orderflow-inventory) | El código Python que corre la lógica real: valida, decide y llama a DynamoDB — un solo lambda_handler() para las 5 rutas | Secciones 7 y 8 |
BOTO3 → | La Lambda usa el SDK de AWS para hablarle a DynamoDB — GetItem/PutItem/UpdateItem, según la operación | Sección 3 |
Amazon DynamoDB (OrderFlowInventory) | Donde vive el dato — un item por product_id, sin schema fijo de columnas | Sección 3 |
🧭 Tu propio despliegue real, pieza por pieza
El diagrama de arriba es genérico (así queda válido para cualquier cuenta) — esta tabla lo conecta con los valores reales y concretos de tu propio despliegue (cuenta 038774852355, región us-east-2, stack orderflow-session8):
| Pieza del diagrama | Tu valor real | Verificado con |
|---|---|---|
| Cliente | curl desde tu terminal (Styp Canto ~) | Los 4 curl de la sección 10 |
Amazon API Gateway (InventoryApi) | https://896oe8brva.execute-api.us-east-2.amazonaws.com | GET /health → 200 {"status": "ok", ...} |
AWS Lambda (orderflow-inventory) | Función real del stack orderflow-session8, código = src/inventory/app.py con el fix de la sección 3 ya aplicado (no solo documentado — el archivo real del repo) | PATCH /inventory/PROD-001 (delta_stock: -4) → 200, available_stock: 16 (antes del fix, esto fallaba) |
Amazon DynamoDB (OrderFlowInventory) | Tabla real en us-east-2, con el item PROD-001 cargado (available_stock: 13, reserved_stock: 3 después de la cadena completa) | POST → PATCH → PATCH .../reserve, los 3 pasos de la sección 10 |
✅ Esto es lo que significa, en la práctica, que el camino de SAM (sección 7) haya funcionado de punta a punta: cada caja del diagrama de arriba dejó de ser un concepto y pasó a ser un recurso real, con nombre y URL propios, en TU cuenta — no la del profesor.
template.yaml(sección 6) fue el único lugar donde se declaró esta arquitectura;sam deployla convirtió en estos 4 recursos reales (más los 5 permisos de Lambda, sección 10) sin un solo clic manual en la consola.
🗺️ Diagrama: secuencia de las 2 llamadas reales, ya desplegado
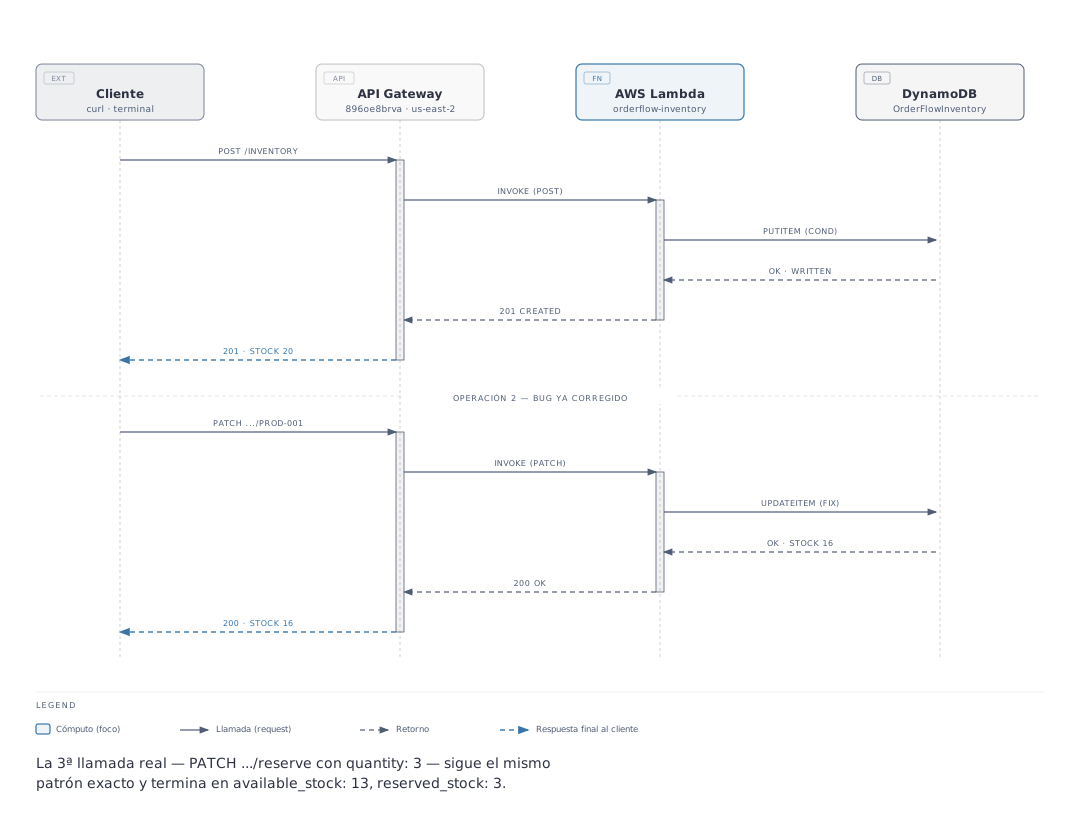
Mismas 4 piezas que el diagrama de arquitectura de la sección 2, pero ahora en el eje temporal — quién le habla a quién, en qué orden, con la respuesta real de cada paso. Las dos operaciones dibujadas son exactamente los 2 curl que ya corriste (sección 10):
- Operación 1 (
POST /inventory):PutItemconConditionExpression= attribute_not_exists(product_id)(sección 3) — comoPROD-001no existía todavía, pasa sin problema y responde201. - Operación 2 (
PATCH /inventory/PROD-001): la operación que antes del fix fallaba — acá se dibuja ya conUpdateExpression/ConditionExpressioncorregidos (el mismo fix que se aplicó al archivo real, más arriba), y responde200conavailable_stock: 16.
💡 Por qué no se dibuja la 3ª operación (
reserve): un diagrama de secuencia tiene un presupuesto de complejidad (máximo ~12 mensajes) para seguir siendo legible — 2 operaciones completas (6 mensajes cada una) ya lo llenan. La 3ª sigue el patrón idéntico de la Operación 2 (mismo camino: Cliente → API Gateway → Lambda → DynamoDB → vuelta), conquantity: 3en vez dedelta_stock, y termina enavailable_stock: 13,reserved_stock: 3— el resultado real que ya confirmaste en la sección 10.
💡 Por qué las 5 rutas no aparecen en el diagrama: todas apuntan a la MISMA
InventoryFunction(sin una Lambda por endpoint) — mostrar cada ruta por separado repetiría 5 veces la misma pieza. El detalle de rutas ya está en la tabla de la sección 10; el diagrama muestra la forma de la arquitectura.
💡 Comparado con la arquitectura "clásica" de la Clase 7 (FastAPI corriendo 24/7 en un proceso propio, con Postgres detrás), acá nada corre permanentemente: ni el API Gateway, ni la Lambda, ni DynamoDB tienen un proceso fijo esperando conexiones — todo se activa por evento y AWS cobra solo por lo que realmente se usó.
🧪 Tip de entrevista: ¿cuál es la principal ventaja de serverless frente a tener un servidor (o contenedor) corriendo siempre? Pagás por uso real, no por tiempo encendido, y no administrás sistema operativo, parches ni escalado — a cambio, perdés control fino sobre el entorno de ejecución y hay que diseñar pensando en cold starts y en que cada invocación es efímera (no hay estado en memoria entre una invocación y la siguiente, a diferencia de un proceso FastAPI que sí mantiene estado mientras vive).
🗄️ 3. DynamoDB: modelo de datos y operaciones condicionales atómicas
La tabla OrderFlowInventory no tiene columnas fijas declaradas de antemano (a diferencia de una tabla SQL con CREATE TABLE) — DynamoDB solo exige declarar la clave (product_id, tipo S = string). El resto de los atributos de cada item los define el código de la aplicación al escribir:
python
item = {
    "product_id": product_id,          # clave (partition key)
    "product_name": product_name,
    "available_stock": available_stock,
    "reserved_stock": 0,
}
🗺️ Diagrama: modelo de datos de OrderFlowInventory
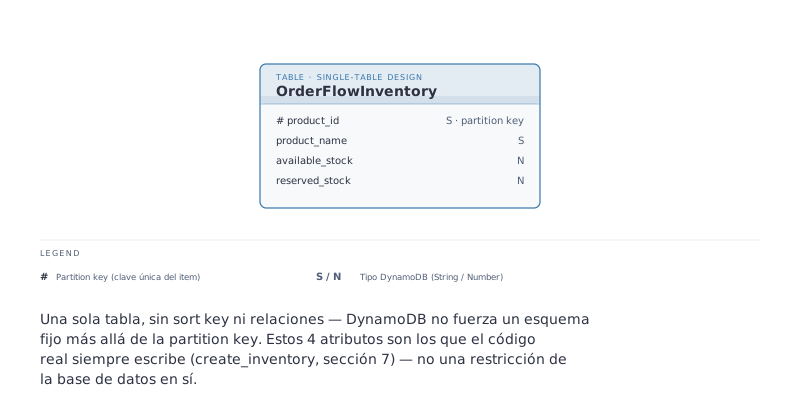
Una sola tabla, sin sort key, sin relaciones con otras tablas — a diferencia de los diagramas entidad-relación de bases SQL ya vistos en el curso (ej. Clase 4), acá no hay nada que "unir": product_id identifica el item por sí solo, y los otros 3 atributos son una decisión del código, no una restricción de la base — DynamoDB dejaría guardar un item con atributos distintos sin quejarse.
Las tres operaciones condicionales del servicio, todas con el mismo patrón (ConditionExpression que puede fallar con ConditionalCheckFailedException):
| Operación | ConditionExpression | Qué evita |
|---|---|---|
create_inventory (POST /inventory) | attribute_not_exists(product_id) | Sobrescribir un producto que ya existe (409 en vez de pisar datos) |
update_inventory (PATCH /inventory/{id}) | attribute_exists(product_id) AND available_stock >= :min_needed | Ajustar stock de un producto inexistente, o dejarlo en negativo |
reserve_inventory (PATCH /inventory/{id}/reserve) | attribute_exists(product_id) AND available_stock >= :q | Reservar más unidades de las que hay disponibles |
💡 Por qué esto importa en un servicio con tráfico concurrente: sin
ConditionExpression, dos peticiones simultáneas dereserve_inventorypodrían leeravailable_stock = 5, ambas decidir "alcanza" y ambas restar — dejando el stock en negativo (una condición de carrera clásica). Al evaluar la condición en el mismo request atómico que la escritura, DynamoDB garantiza que si dos peticiones compiten por el mismo item, como mucho una gana — la otra recibeConditionalCheckFailedExceptionlimpio, sin dato corrupto.
🧪 Tip de entrevista: ¿por qué no alcanza con hacer
GetItem(leer el stock), revisar en Python si hay suficiente, y recién ahí hacerUpdateItem? Porque entre elGetItemy elUpdateItemotra invocación de la misma Lambda (o de otro cliente) puede colarse y modificar el mismo item — el "leer, decidir, escribir" en dos pasos separados nunca es atómico.ConditionExpressionmueve esa decisión adentro de la propia operación de escritura, que DynamoDB sí garantiza atómica.
⚠️ El bug real: ConditionExpression no admite aritmética
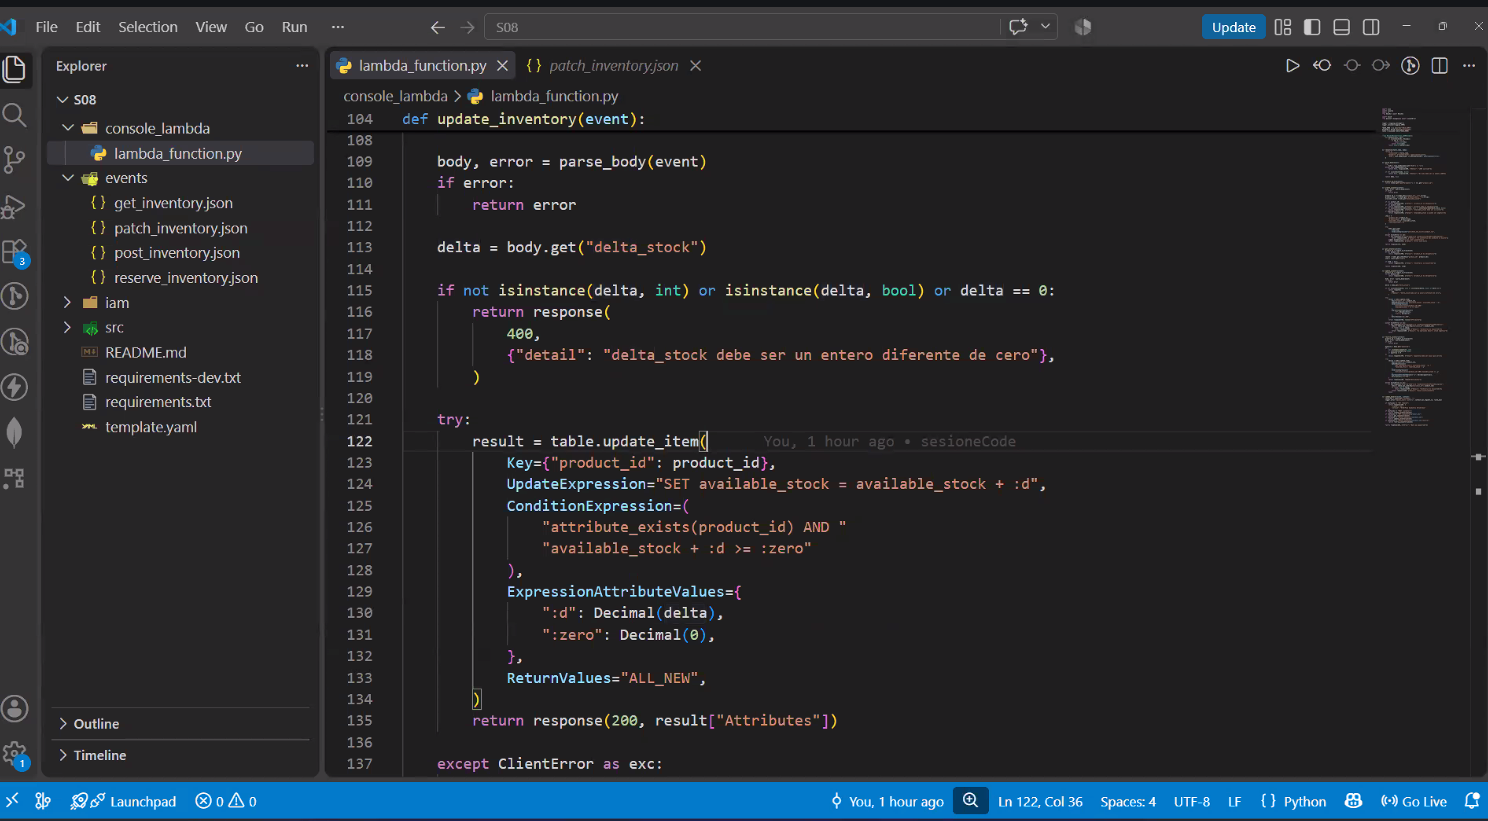
Así se explicó en vivo, en VS Code — el mismo update_inventory de console_lambda/lambda_function.py (sección 8), con git blame confirmando que es el mismo commit (sesioneCode) que el resto de las capturas de esta clase:
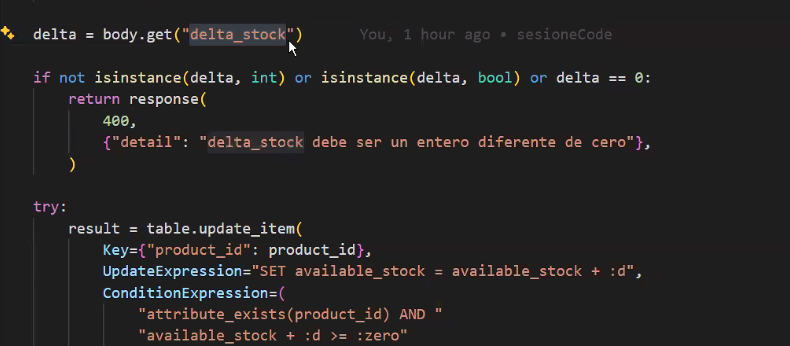
Verificando el código de update_inventory con una tabla DynamoDB real (simulada con moto, la librería de testing que emula los servicios de AWS), la condición tal como está escrita en el repo del curso falla:
python
# código original — FALLA en DynamoDB real, no solo en el test
ConditionExpression=(
    "attribute_exists(product_id) AND "
    "available_stock + :delta >= :zero"     # ← "+" no es válido acá
),
ExpressionAttributeValues={
    ":delta": Decimal(delta_stock),
    ":zero": Decimal(0),
},
ValueError: Cannot parse condition starting at: + :delta >= :zeroCausa: a diferencia de UpdateExpression (que sí permite SET x = x + :delta), la gramática de ConditionExpression de DynamoDB no admite operadores aritméticos — solo acepta comparar un path (nombre de atributo) o un value contra otro, más funciones como attribute_exists. available_stock + :delta no es ni un path ni un value válidos ahí, aunque sí lo sea dentro de un UpdateExpression.
✅ Solución: calcular el umbral en Python antes de armar la condición, y comparar el atributo directo contra ese valor ya calculado (sin sumas dentro de la expresión):
python
delta_stock = -4  # ejemplo: se quiere restar 4 unidades

result = table.update_item(
    Key={"product_id": product_id},
    UpdateExpression="SET available_stock = available_stock + :delta",   # acá SÍ va la suma
    ConditionExpression=(
        "attribute_exists(product_id) AND "
        "available_stock >= :min_needed"       # acá NO, solo comparación directa
    ),
    ExpressionAttributeValues={
        ":delta": Decimal(delta_stock),
        # si delta es negativo, hace falta AL MENOS esa cantidad de stock disponible;
        # si delta es positivo (sumar stock), la condición es siempre verdadera (:0)
        ":min_needed": Decimal(-delta_stock) if delta_stock < 0 else Decimal(0),
    },
    ReturnValues="ALL_NEW",
)
Verificado con moto simulando DynamoDB real: delta=-4 sobre available_stock=20 actualiza a 16 (200 OK); delta=-999 sobre el mismo item lanza ConditionalCheckFailedException (409, como se espera); delta=5 (sumar) siempre pasa. Ver el error completo documentado en 06-Errores.
✅ Confirmado también en AWS real, no solo simulado.
src/inventory/app.pyya tiene el fix aplicado en el repo de esta sesión (no solo en el bloque de código de arriba) — desplegado consam build && sam deployen una cuenta propia, la cadena completa contra la URL pública real dio exactamente lo esperado:POST /inventory→201(available_stock: 20),PATCH .../PROD-001condelta_stock: -4→200(available_stock: 16),PATCH .../reserveconquantity: 3→200(available_stock: 13,reserved_stock: 3).
⚠️ Este mismo patrón (
available_stock + :d >= :zero) también está enconsole_lambda/lambda_function.py(sección 8) — esa copia sigue con el bug sin corregir a propósito (es el camino alternativo de consola, no el que se desplegó), y sigue siendo el Ejercicio 19 (aplicar el mismo fix ahí).
📝
reserve_inventory(la tercera operación de la tabla de arriba) no tiene este bug: su condición (available_stock >= :q) ya compara el atributo directo contra un valor, sin sumarle nada adentro de la expresión — por eso nunca tuvo que corregirse.
🔐 4. IAM: permisos de mínimo privilegio
iam/dynamodb-policy.json es la policy que necesitaría el rol de la Lambda si se armara a mano (por ejemplo, para el Lambda de la consola, sección 8):
json
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "OrderFlowInventoryAccess",
      "Effect": "Allow",
      "Action": [
        "dynamodb:GetItem",
        "dynamodb:PutItem",
        "dynamodb:UpdateItem"
      ],
      "Resource": "ARN_DE_LA_TABLA_ORDERFLOWINVENTORY"
    }
  ]
}
Por qué es mínimo privilegio, punto por punto:
- Solo 3 acciones, las que el código realmente usa (
get_item,put_item,update_item— se ve confirmando contraapp.py, sección 7). No incluyeDeleteItem,ScanniQuery, porque el servicio nunca los llama. Resourceapunta a UNA tabla puntual (el ARN real reemplazaría el placeholderARN_DE_LA_TABLA_ORDERFLOWINVENTORY), no"*"— así, aunque alguien comprometiera esta Lambda, no podría tocar ninguna otra tabla DynamoDB de la cuenta.
💡 En el
template.yaml(sección 6) no aparece este JSON — SAM usaDynamoDBCrudPolicy: { TableName: !Ref InventoryTable }, una policy predefinida que genera automáticamente un JSON equivalente (algo más amplio: agrega tambiénDeleteItem,Query,Scan,BatchGetItem,BatchWriteItemsobre esa misma tabla) sin tener que escribirlo a mano. El archivodynamodb-policy.jsondeiam/documenta el equivalente mínimo real que usa el código, útil como referencia si algún día se arma el rol manualmente (como en la consola, sección 8).
⚠️ El placeholder
ARN_DE_LA_TABLA_ORDERFLOWINVENTORYno es un ARN válido tal cual — hay que reemplazarlo por el ARN real de la tabla (visible en la consola de DynamoDB, o en el outputInventoryTableNamedel stack de SAM) antes de adjuntar esta policy a un rol de verdad.
⚠️ Caso real de la sesión: armar este ARN a mano (como en la consola, sección 8) tiene un riesgo concreto — un ARN de DynamoDB incluye la región como parte del identificador (
arn:aws:dynamodb:REGIÓN:cuenta:table/Nombre), y una región equivocada ahí no es "la misma tabla en otro lado": para IAM es directamente otro recurso, que no existe. Con eso, la Lambda queda "autorizada" sobre nada, y el síntoma es indistinguible de no tener el permiso. Caso completo, con capturas propias del diagnóstico y la corrección, en 06-Errores.
💻 PARTE PRÁCTICA
🗂️ 5. Estructura del proyecto (02-Ejercicios/Clase-08/PYT30JUL26/S08)
🧭 Antes de empezar: crear tu propia cuenta AWS
Todas las capturas de esta clase (secciones 8 y 10) son de la cuenta AWS del profesor (instructor-orderflow, sección 8) — para replicar el laboratorio hace falta una cuenta propia. Pasos:
- Entrar a aws.amazon.com/free → "Create an AWS Account" — pide email, nombre de cuenta y contraseña.
- Tarjeta de crédito/débito obligatoria — AWS la pide como verificación de identidad, aunque se use solo el free tier; no cobra nada mientras no se superen los límites gratuitos.
- Verificación por teléfono (SMS o llamada) y elegir un plan de soporte — Basic (gratis) alcanza de sobra.
- Al entrar por primera vez se ve la página de inicio de la consola — ahí arriba a la derecha está el nombre de cuenta y su ID de 12 dígitos, y la región activa (acá,
us-east-2= Ohio, la misma que usa toda esta clase):
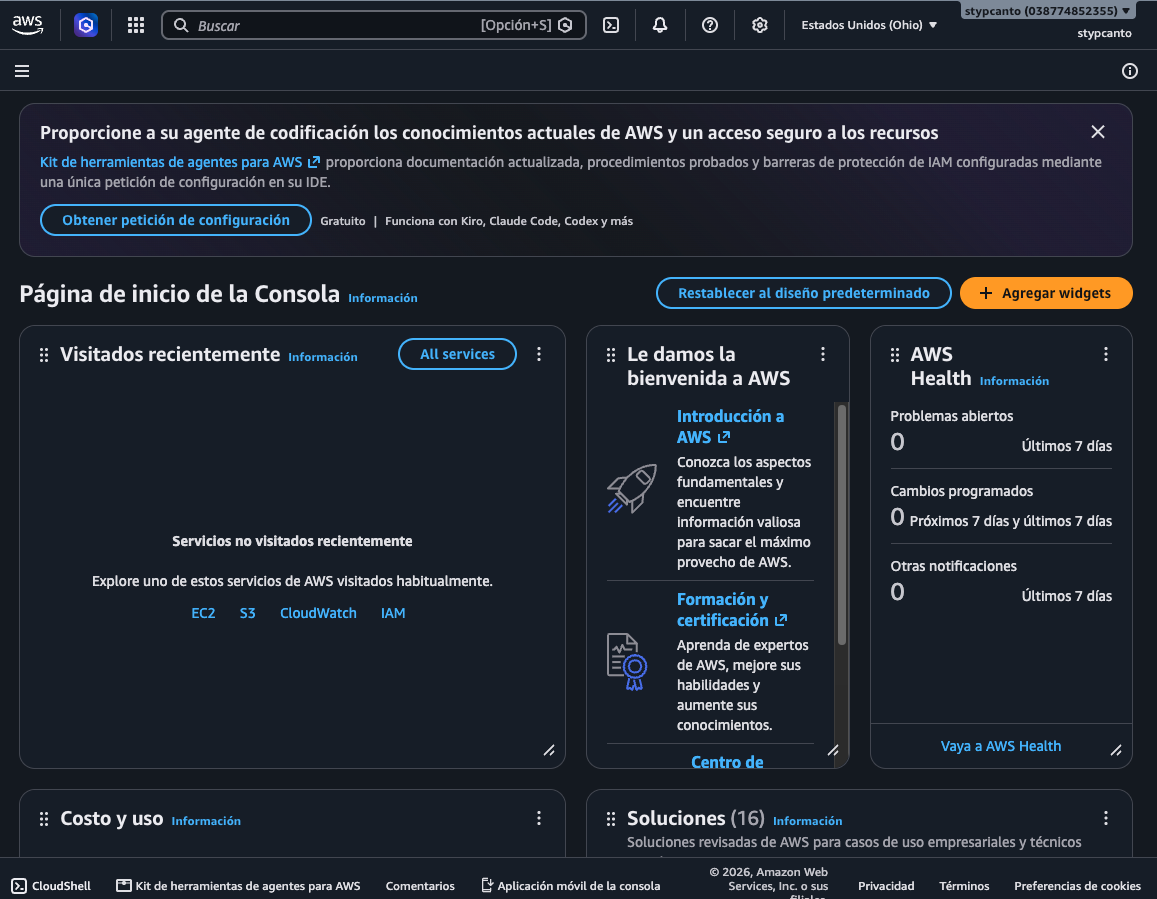
💡 Ese ID de cuenta de 12 dígitos es el mismo número que ya apareció, sin saberlo, en cada ARN de esta clase (
arn:aws:dynamodb:us-east-2:540659180627: table/OrderFlowInventory, sección 3) — es el ID de la cuenta del profesor. Con cuenta propia, ese número cambia (acá,038774852355) y aparece en TODOS los ARN que se generen (tabla, función, rol IAM).
📌 Al entrar por primera vez se está logueado como root user — para trabajar del día a día (y para este laboratorio) conviene crear antes un usuario IAM propio con permisos de administrador y usar ese, no el root — el mismo principio de mínimo privilegio de la sección 4, aplicado a la propia cuenta.
Crear ese usuario IAM propio, paso a paso (capturas propias): IAM → Usuarios de IAM → Crear persona, con estas dos pantallas:
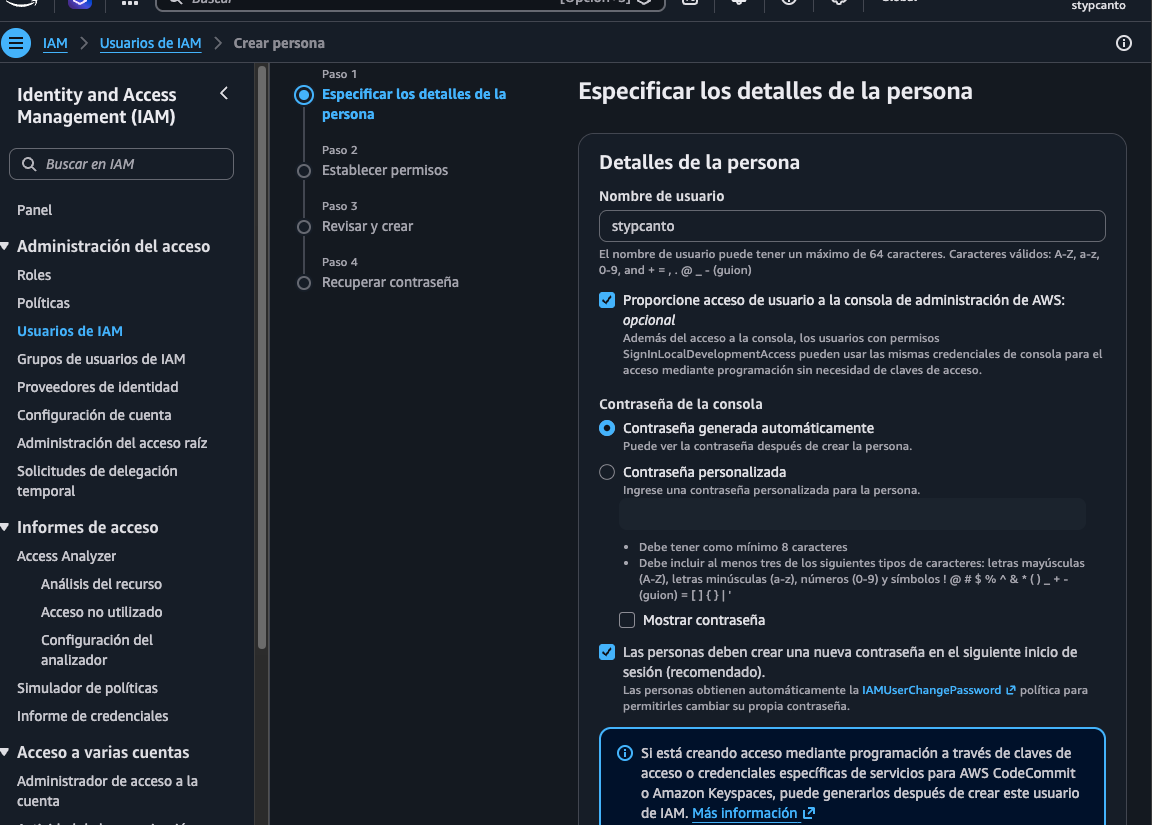
Paso 1 — Detalles de la persona:
- Nombre de usuario identificable (no genérico) — acá
stypcanto. - "Proporcione acceso de usuario a la consola" marcado — hace falta para poder entrar por navegador (como en toda esta clase); si el usuario fuera solo para automatización/CI, se dejaría sin marcar.
- Contraseña generada automáticamente + "Deben crear una nueva contraseña en el siguiente inicio de sesión" marcado — ambas son las opciones recomendadas por AWS por defecto: no hay que inventar una contraseña fuerte a mano, y la generada se cambia sola en el primer login (nadie más la conserva).
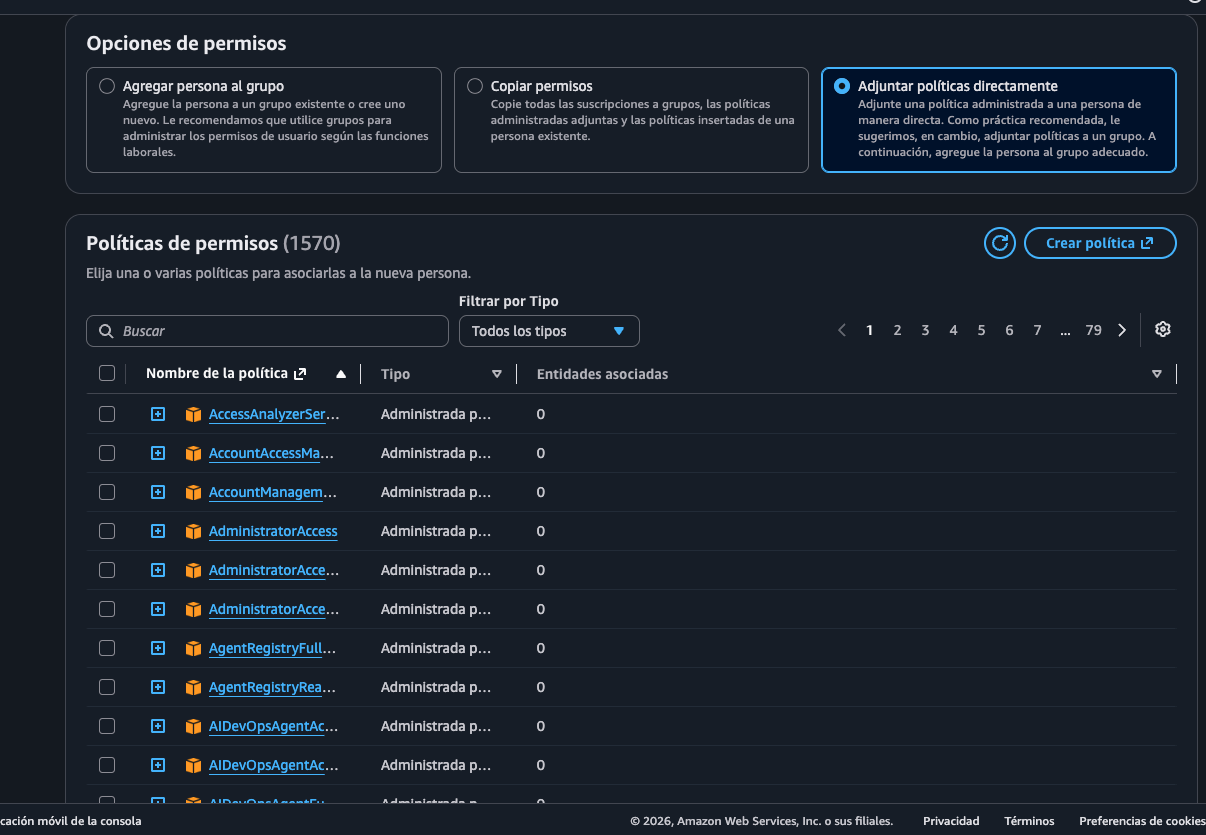
Paso 2 — Establecer permisos, con las 3 opciones que ofrece el asistente:
| Opción | Qué hace | ¿Cuándo conviene? |
|---|---|---|
| Agregar persona a un grupo | El permiso vive en el grupo; la persona lo hereda al sumarse | La que recomienda AWS — escala mejor cuando hay varios usuarios con el mismo rol |
| Copiar permisos | Clona los permisos exactos de otro usuario ya existente | Cuando ya hay alguien con el perfil correcto |
| Adjuntar políticas directamente | El permiso queda pegado a ESTE usuario puntual, sin grupo de por medio | Más simple para una cuenta personal de práctica, con un solo usuario — la elegida acá |
Con "Adjuntar políticas directamente" seleccionado, se busca y marca AdministratorAccess (visible en la lista de la captura) — la policy administrada de AWS que da acceso total, cómoda para practicar sin fricción de permisos mientras se aprende (en un entorno de trabajo real, se ajustaría a mínimo privilegio, como ya se vio en la sección 4).
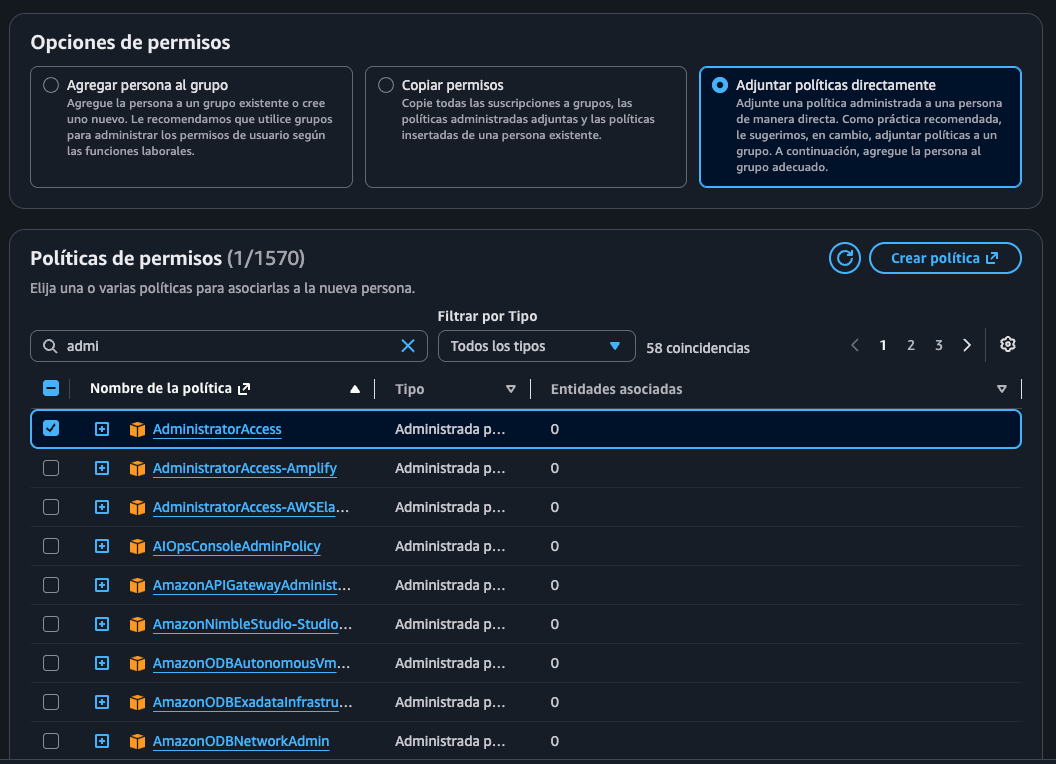
⚠️ El buscador de políticas trae varias parecidas (
AdministratorAccess-Amplify,AdministratorAccess-AWSElasticBeanstalk, etc.) — hay que marcar solo la que diceAdministratorAccessa secas, primera de la lista, sin ningún sufijo después del guion. El contador(1/1570)de la captura confirma que quedó una sola policy marcada.
Paso 3 — Revisar y crear, el último antes de confirmar:
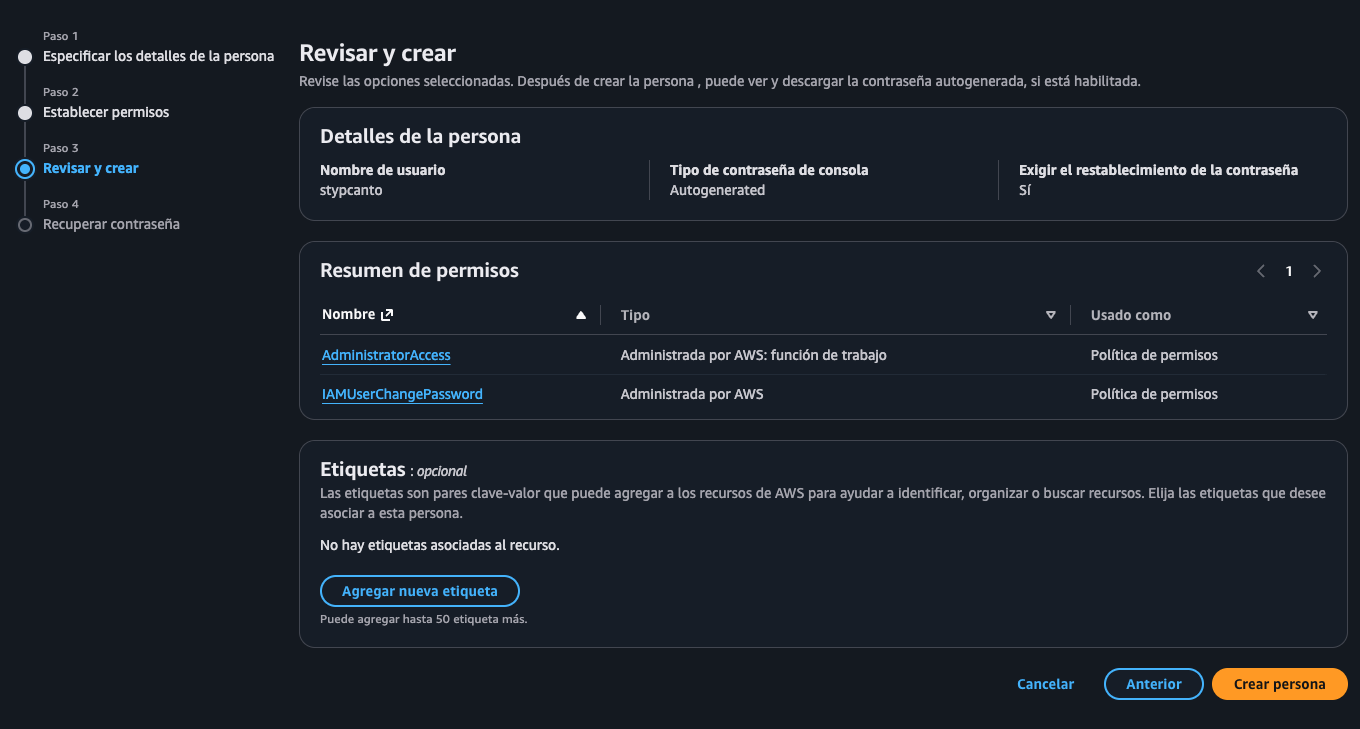
Todo el resumen coincide con lo elegido en los Pasos 1 y 2 — y aparece una policy extra que nadie marcó a mano: IAMUserChangePassword. No es un error: AWS se la agrega automáticamente a cualquier usuario con acceso a consola (se mencionó en el cuadro informativo del Paso 1) — sin ella, el usuario no podría cambiar su propia contraseña la primera vez que entre. Con esto revisado, "Crear persona" (botón naranja) cierra el asistente y muestra la contraseña autogenerada — hay que guardarla o descargarla en ese momento, es la única vez que la consola la muestra en texto plano.
Confirmación — el usuario ya existe:
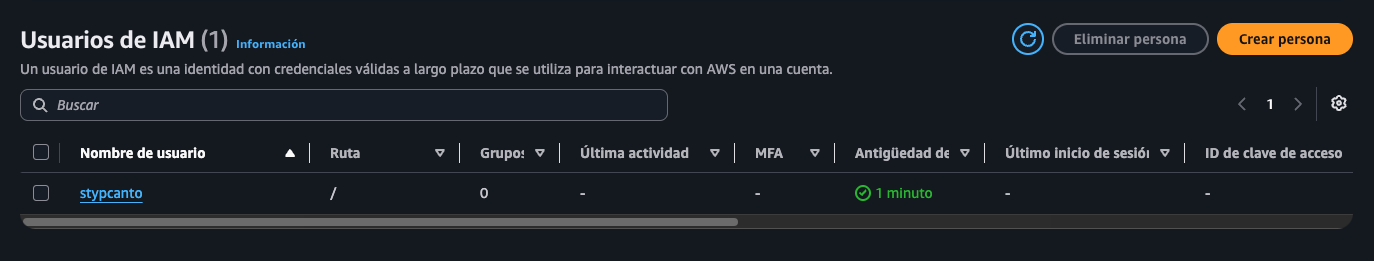
stypcanto aparece en IAM → Usuarios de IAM, recién creado ("Antigüedad: 1 minuto"). La columna "ID de clave de acceso" está vacía a propósito — la contraseña de consola (Pasos 1-3) y las access keys para sam deploy/aws configure son dos credenciales completamente distintas; estas últimas se generan aparte, entrando al usuario → pestaña "Credenciales de seguridad".
Login con el usuario de IAM (ya no root):
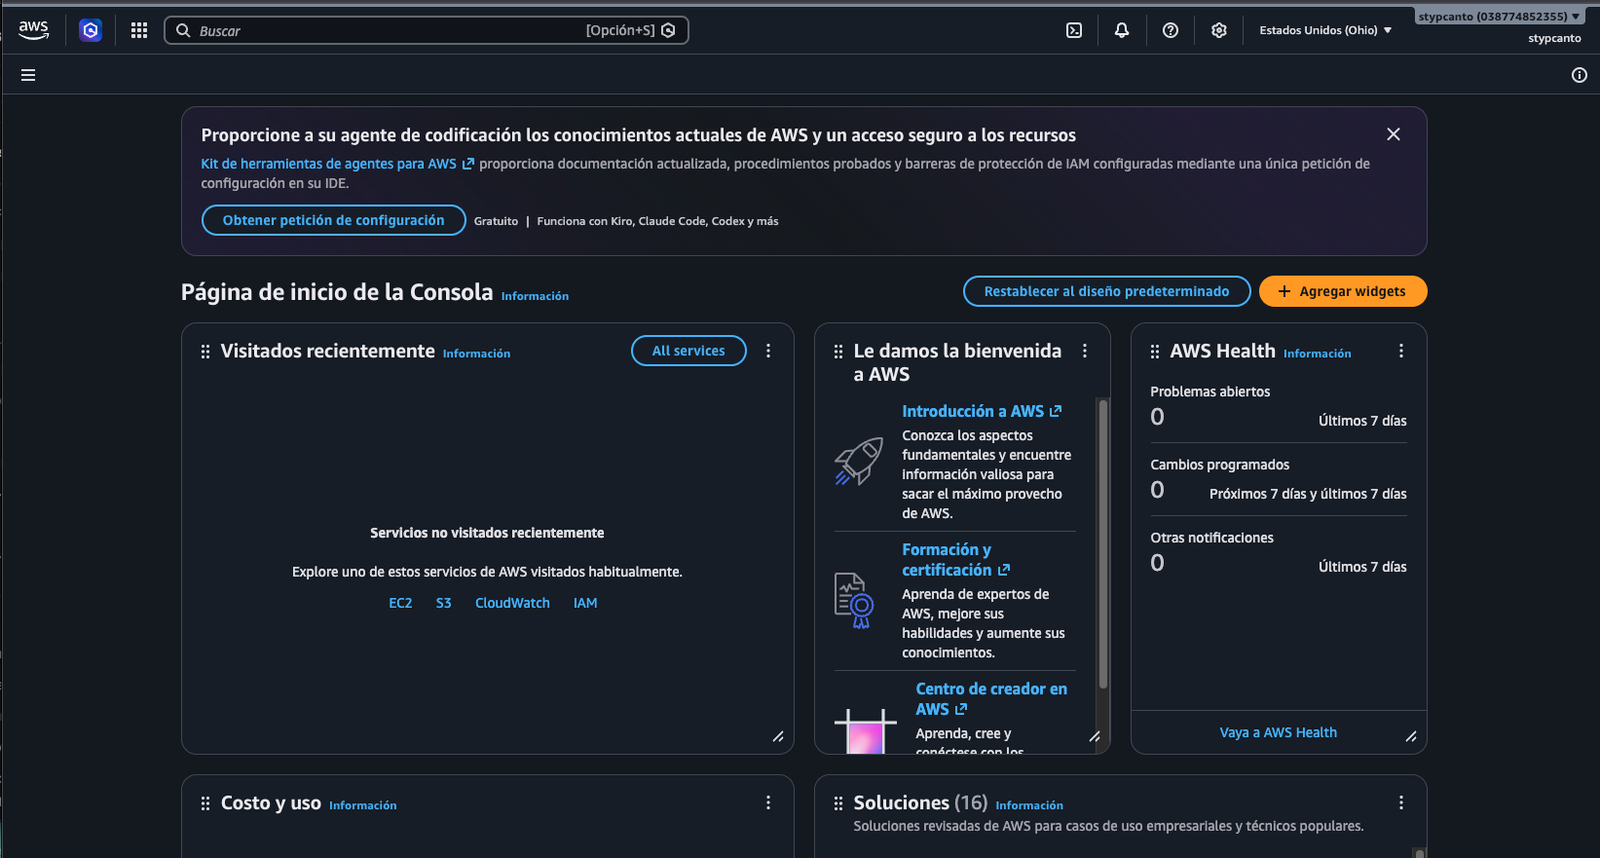
Entrando por https://<id-de-cuenta>.signin.aws.amazon.com/console (en vez de la URL de root) con usuario stypcanto + la contraseña del Paso 3, ya se está adentro como usuario de IAM, no como root.
📝 Aclaración honesta sobre esta captura: el texto de la esquina superior derecha (
stypcanto (038774852355)/stypcanto) es idéntico al que mostraba la consola como root, al principio de esta sección — porque acá coincide que el nombre de la cuenta y el nombre del usuario de IAM son la misma palabra (stypcanto). Ese texto solo no alcanza para confirmar 100% cuál de los dos sos. La forma segura: hacer clic en esa esquina (se despliega un menú) y fijarse si aparece un campo separado "Usuario de IAM" — solo existe si es login de IAM; como root, ese campo directamente no aparece.
Confirmación definitiva, con el menú desplegado:
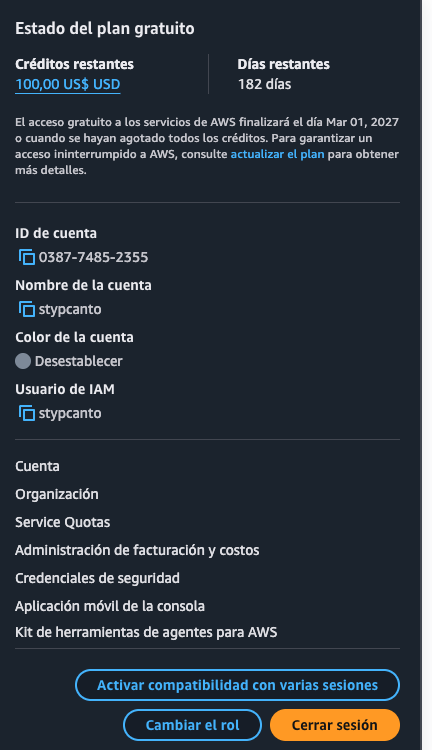
El campo "Usuario de IAM: stypcanto" aparece ahí, separado del "Nombre de la cuenta" — confirma sin dudas que es un login de IAM, no de root.
💡 Dato extra que trae este mismo menú, relevante para "¿cuesta algo?":"Estado del plan gratuito" → Créditos restantes: 100,00 US$ USD, Días restantes: 182 días. Es el programa de créditos de prueba de AWS (distinto del free tier permanente de Lambda/DynamoDB) — un colchón extra de $100 USD válido por 6 meses desde que se creó la cuenta, más que de sobra para cualquier cosa que se pruebe en esta clase. Credenciales de seguridad (mismo menú) es, además, por donde se generan las access keys para
aws configure/sam deploy.
¿Cuesta algo probar este laboratorio puntual? No debería, por el tamaño real de uso:
| Servicio | Por qué sale gratis acá |
|---|---|
| AWS Lambda | Free tier permanente (no solo 12 meses): 1 millón de invocaciones/mes gratis |
| Amazon DynamoDB | PAY_PER_REQUEST cobra por operación real — con una tabla de práctica (unos pocos GetItem/PutItem) el costo es casi $0 |
| Amazon API Gateway (HTTP API) | Free tier los primeros 12 meses; el volumen de este laboratorio es insignificante igual |
⚠️ El riesgo real no es "usar de más" este laboratorio puntual — es crear por error otro recurso con costo por hora (EC2, RDS, NAT Gateway), nada de lo cual aparece en esta clase. Configurar una alerta de presupuesto (AWS Budgets, ej. $1 o $5) antes de arrancar avisa por mail si algo sale mal. Y al terminar,
sam delete --stack-name orderflow-session8(sección 10) borra todo lo creado.
🔑 Access keys para aws configure / sam deploy
El login de consola (arriba) sirve para navegar por el navegador — pero sam deploy/aws configure necesitan una credencial distinta: una access key. Se genera en IAM → Usuarios de IAM → stypcanto → pestaña "Credenciales de seguridad":
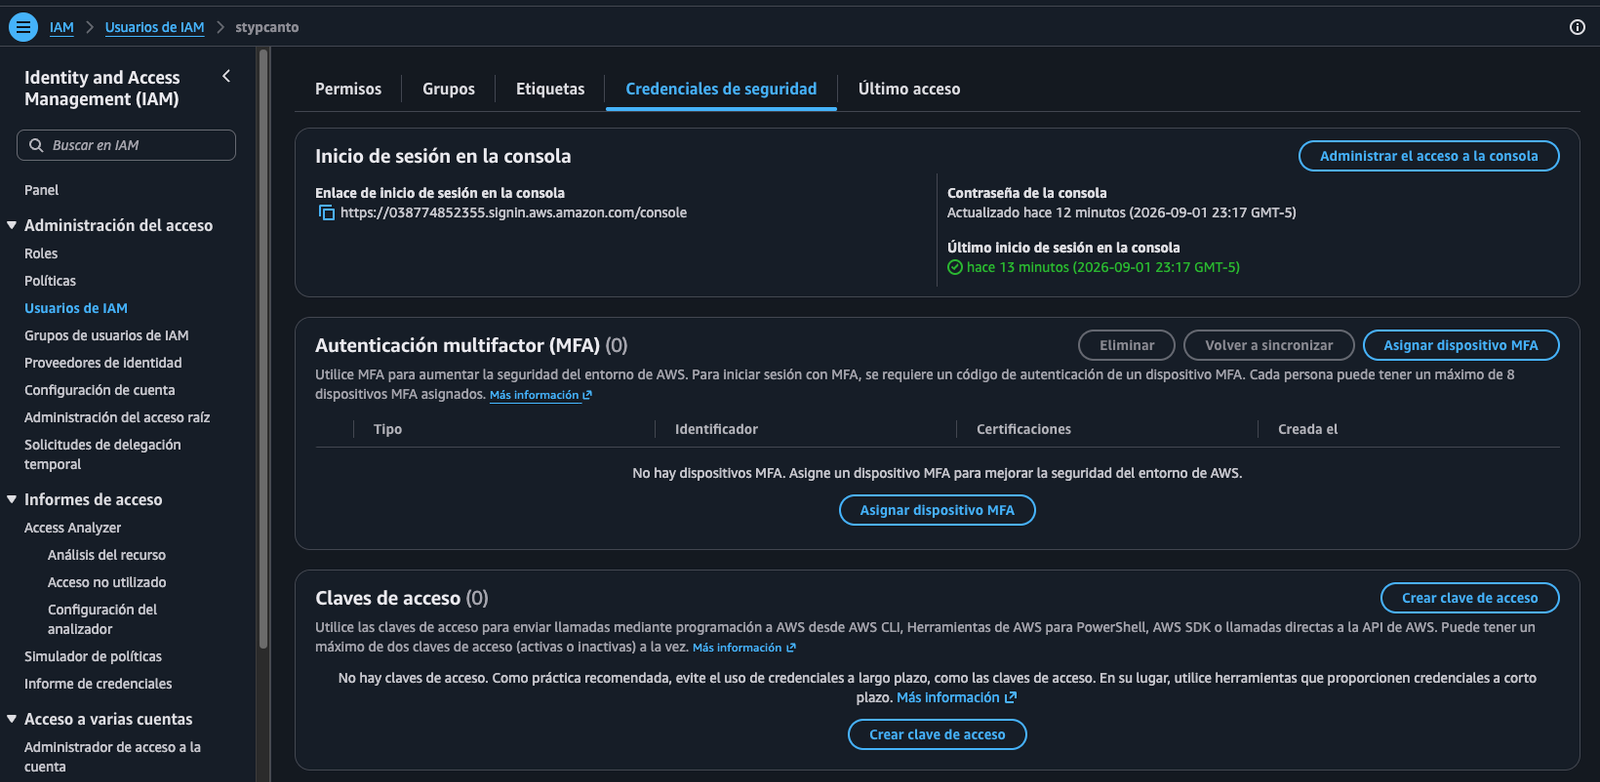
Tres secciones en esta pantalla:
- Inicio de sesión en la consola — confirma el login de la sección anterior ("hace 13 minutos" ✅).
- Autenticación multifactor (MFA) (0) — sin dispositivos todavía; no es obligatorio para este laboratorio, pero es buena práctica activarlo en cualquier cuenta real (una capa extra además de la contraseña).
- Claves de acceso (0) — vacío, con el botón "Crear clave de acceso".
Al hacer clic, pide elegir el caso de uso:

"Interfaz de línea de comandos (CLI)" es la opción correcta para sam deploy/aws configure (línea de comandos, no una app corriendo en un servicio de AWS ni código local con SDK). El aviso amarillo sugiere alternativas más modernas (aws login con SSO, o CloudShell, sin credenciales de larga duración) — válidas, pero para este laboratorio de práctica, marcar el checkbox de confirmación y seguir con la access key clásica es más simple y es lo que se documenta acá.
⚠️ El paso que sigue (no capturado a propósito): nunca se documenta el valor real de una access key. Después de "Crear clave de acceso", AWS muestra el Access Key ID y el Secret Access Key UNA SOLA VEZ — hay que descargar el
.csvo copiarlos a un lugar seguro en ese momento (después no se puede volver a ver el secret). Esos dos valores van directo aaws configureen la terminal, nunca a un archivo del repo, a un chat, ni a una captura de pantalla — si se filtran por error, se desactivan/eliminan desde esta misma pantalla y se genera una clave nueva.
Configurar el AWS CLI en la terminal, con esas dos claves ya copiadas:
bash
# 1. Verificar si el AWS CLI ya está instalado
aws --version
# Si da "command not found: aws", instalar:
brew install awscli

# 2. Configurar las credenciales — pide 4 datos, uno por uno
aws configure
AWS Access Key ID [None]: <pegar el Access Key ID, empieza con AKIA...>
AWS Secret Access Key [None]: <pegar el Secret Access Key>
Default region name [None]: us-east-2
Default output format [None]: json💡 Al pegar el Secret Access Key la terminal no muestra nada en pantalla (ni texto ni asteriscos) — es el comportamiento normal para no dejar rastro visual de un secreto; se pega igual y se confirma con Enter.
Verificar que quedó bien, sin exponer las claves en la salida:
bash
aws sts get-caller-identityjson
{
    "UserId": "AIDA...",
    "Account": "038774852355",
    "Arn": "arn:aws:iam::038774852355:user/stypcanto"
}
Si el Arn devuelto termina en user/stypcanto (el usuario de IAM creado antes, sección 5) y el Account coincide con el ID de la cuenta propia, el AWS CLI ya está configurado y autenticado — a partir de acá, sam build/sam deploy --guided (sección 10) usan estas credenciales automáticamente, sin pedir nada más.
S08/
├── template.yaml              # infraestructura como código (SAM) — sección 6
├── README.md                  # instrucciones cortas: stack name, región sugerida, endpoints
├── requirements.txt           # boto3>=1.40,<2.0
├── requirements-dev.txt       # pytest>=8.0,<9.0 (sin tests todavía — ver ejercicio 20)
├── iam/
│   └── dynamodb-policy.json   # policy de mínimo privilegio a mano — sección 4
├── src/inventory/             # código que SAM empaqueta y despliega — sección 7
│   ├── app.py
│   └── responses.py
├── console_lambda/
│   └── lambda_function.py     # la misma lógica, versión "pegada en la consola" — sección 8
└── events/                    # eventos de prueba para sam local invoke — sección 9
    ├── post_inventory.json
    ├── get_inventory.json
    ├── patch_inventory.json
    └── reserve_inventory.json
💡
02-Ejercicios/Clase-08/PYT30JUL26/es, en sí, otro repositorio git (cursos-tecylab/PYT30JUL26, el repo que entrega el curso con el código de cada sesión) — vive anidado dentro del repo de apuntes solo como referencia de lectura; el trabajo de la sesión 8 puntual está en la subcarpetaS08/.
📦 6. template.yaml — la infraestructura como código (SAM)
yaml
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31
Description: OrderFlow - Inventory Serverless Service

Globals:
  Function:
    Runtime: python3.12
    Architectures:
      - x86_64
    Timeout: 10
    MemorySize: 256
    Environment:
      Variables:
        TABLE_NAME: !Ref InventoryTable

Resources:
  InventoryApi:
    Type: AWS::Serverless::HttpApi
    Properties:
      StageName: $default
      CorsConfiguration:
        AllowOrigins: ["*"]
        AllowMethods: [GET, POST, PATCH]
        AllowHeaders: [Content-Type]

  InventoryTable:
    Type: AWS::DynamoDB::Table
    Properties:
      TableName: OrderFlowInventory
      BillingMode: PAY_PER_REQUEST
      AttributeDefinitions:
        - AttributeName: product_id
          AttributeType: S
      KeySchema:
        - AttributeName: product_id
          KeyType: HASH

  InventoryFunction:
    Type: AWS::Serverless::Function
    Properties:
      FunctionName: orderflow-inventory
      CodeUri: src/inventory/
      Handler: app.lambda_handler
      Policies:
        - DynamoDBCrudPolicy:
            TableName: !Ref InventoryTable
      Events:
        Health:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /health, Method: GET }
        CreateInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory, Method: POST }
        GetInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory/{product_id}, Method: GET }
        UpdateInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory/{product_id}, Method: PATCH }
        ReserveInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory/{product_id}/reserve, Method: PATCH }

Outputs:
  ApiUrl:
    Value: !Sub "https://${InventoryApi}.execute-api.${AWS::Region}.${AWS::URLSuffix}"
  InventoryTableName:
    Value: !Ref InventoryTable
Pieza por pieza:
Transform: AWS::Serverless-2016-10-31es lo que convierte este YAML de CloudFormation "crudo" en SAM — habilita los tiposAWS::Serverless::*(más cortos) que SAM traduce por debajo a los recursos reales de CloudFormation.Globals.Functionaplica a todas las funciones Lambda del template (acá solo hay una, pero el patrón escala si se agregan más) — evita repetirRuntime/Timeout/MemorySize/variables de entorno en cada una.TABLE_NAME: !Ref InventoryTablees cómo la Lambda sabe el nombre real de la tabla sin tenerlo hardcodeado —!Refa un recursoAWS::DynamoDB::Tableresuelve alTableNameen tiempo de despliegue, yapp.pylo lee conos.environ["TABLE_NAME"](sección 7). Mismo principio de "config por variable de entorno, no hardcodeada" que ya se vio con.enven la Clase 7.- Las 5
EventsdeInventoryFunctionson las que arman las 5 rutas del HTTP API — cada una asocia un método+ruta con la MISMA función (ver 🗺️ diagrama de la sección 2). Policies: DynamoDBCrudPolicyya se explicó en la sección 4 — es la forma declarativa de darle a la Lambda exactamente los permisos que necesita sobreInventoryTable, sin escribir el JSON de IAM a mano.Outputs.ApiUrlarma la URL pública real del HTTP API una vez desplegado (combina el id del API Gateway, la región de AWS y el sufijo de dominio) — es lo quesam deployimprime al terminar, y lo que se usa comobase_urlpara probar con Postman/curl(sección 10).
⚠️
StageName: $defaultes un valor especial de HTTP API (no un nombre de stage cualquiera): hace que las rutas queden servidas directo en la raíz de la URL del API (.../inventory), sin un prefijo de stage antepuesto (como.../prod/inventory). Cómodo para practicar; en un proyecto con varios ambientes (dev/staging/prod) normalmente se usa un stage con nombre por ambiente.
🧩 7. src/inventory/app.py y responses.py — el Lambda desplegado con SAM
responses.py centraliza la serialización de la respuesta HTTP — la misma lógica se repite en las 5 rutas, así que vive en un solo lugar:
python
import json
from decimal import Decimal
from typing import Any


class DecimalEncoder(json.JSONEncoder):
    def default(self, obj: Any):
        if isinstance(obj, Decimal):
            if obj % 1 == 0:
                return int(obj)
            return float(obj)
        return super().default(obj)


def api_response(status_code: int, body: dict) -> dict:
    return {
        "statusCode": status_code,
        "headers": {"Content-Type": "application/json"},
        "body": json.dumps(body, cls=DecimalEncoder, ensure_ascii=False),
    }
💡 La forma exacta del dict que devuelve
api_response(statusCode,headers,bodycomo STRING, no como dict) no es un capricho de estilo — es el contrato exacto que API Gateway (HTTP API) espera de vuelta de una Lambda con integración simple (payload format 2.0). Sibodyfuera un dict en vez de un string JSON, API Gateway devolvería un error de integración, no la respuesta.
🧪 Tip de entrevista: ¿por qué
DecimalEncoderdistingueintdefloat(obj % 1 == 0)? Porque DynamoDB no diferencia enteros de decimales — todo esDecimal— pero el JSON de salida sí debería verse natural:"available_stock": 16(sin.0) en vez de"available_stock": 16.0, que confundiría a quien consume la API pensando que es una cantidad fraccionaria.
app.py (con la corrección de la sección 3 ya aplicada en update_inventory):
python
import json
import logging
import os
from decimal import Decimal

import boto3
from botocore.exceptions import ClientError

from responses import api_response

logger = logging.getLogger()
logger.setLevel(logging.INFO)

TABLE_NAME = os.environ["TABLE_NAME"]
dynamodb = boto3.resource("dynamodb")
table = dynamodb.Table(TABLE_NAME)


def parse_body(event: dict):
    raw_body = event.get("body") or "{}"
    try:
        body = json.loads(raw_body)
    except json.JSONDecodeError:
        return None, api_response(400, {"detail": "El body debe contener JSON válido"})
    if not isinstance(body, dict):
        return None, api_response(400, {"detail": "El body debe ser un objeto JSON"})
    return body, None


def get_product_id(event: dict):
    return (event.get("pathParameters") or {}).get("product_id")


def lambda_handler(event, context):
    route_key = event.get("routeKey", "")
    logger.info("request_id=%s route=%s", getattr(context, "aws_request_id", None), route_key)

    if route_key == "GET /health":
        return api_response(200, {"status": "ok", "service": "OrderFlow Inventory Serverless"})
    if route_key == "POST /inventory":
        return create_inventory(event)
    if route_key == "GET /inventory/{product_id}":
        return get_inventory(event)
    if route_key == "PATCH /inventory/{product_id}":
        return update_inventory(event)
    if route_key == "PATCH /inventory/{product_id}/reserve":
        return reserve_inventory(event)

    return api_response(404, {"detail": "Ruta no encontrada"})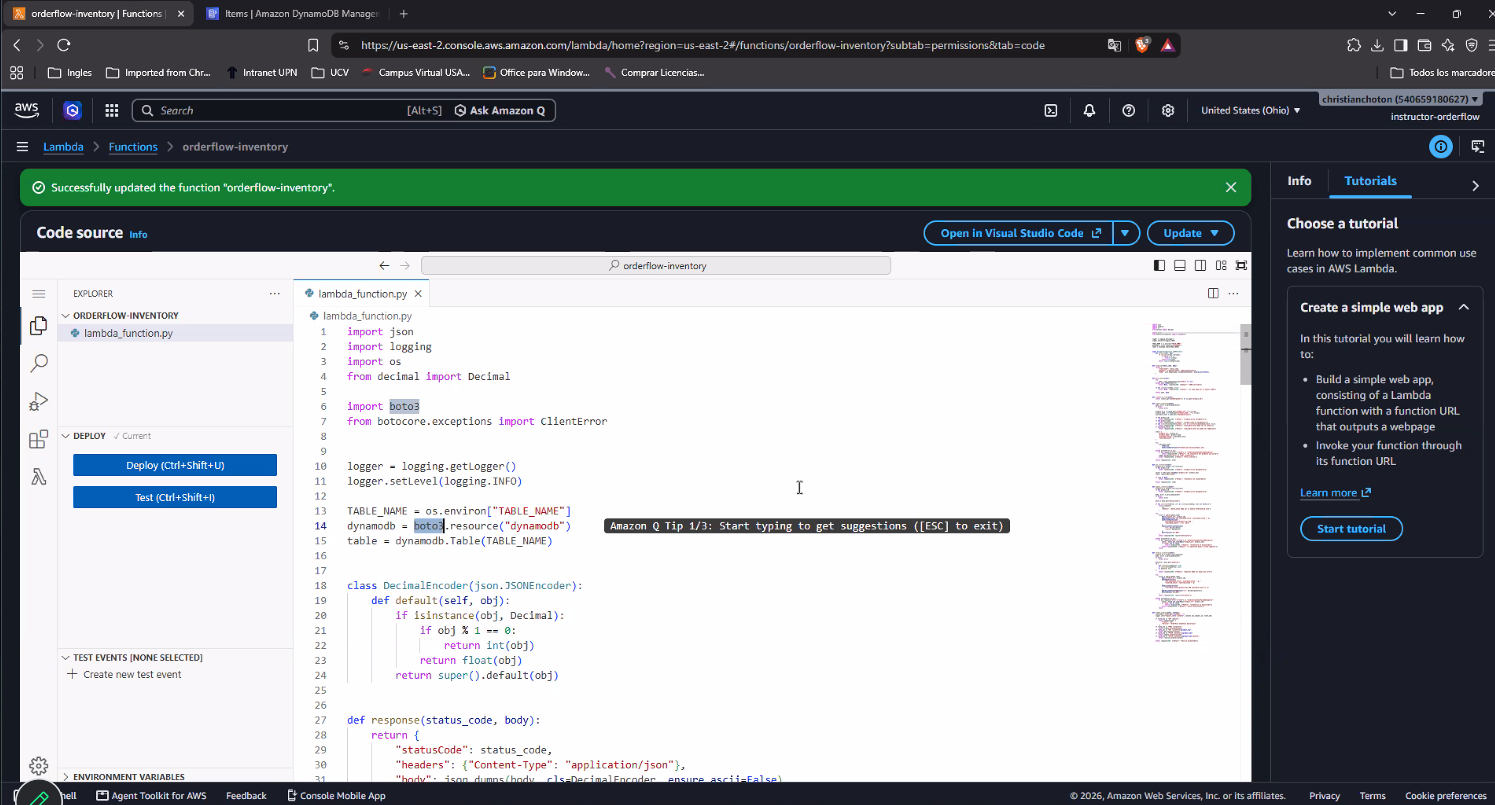
💡
boto3.resource("dynamodb")vs.boto3.client("dynamodb")— las dos formas que aparecen en esta clase de hablarle a DynamoDB desde Python, y por qué el servicio usa una y los tests conmoto(Ejercicio 20) usan la otra:
boto3.resource(...) | boto3.client(...) | |
|---|---|---|
| Nivel | Alto nivel, orientado a objetos (table.get_item(...), table.put_item(...)) | Bajo nivel, un método por operación de la API (ddb.get_item(TableName=..., Key=...)) |
| Tipos de datos | Convierte automáticamente entre tipos Python (dict, Decimal) y el formato interno de DynamoDB | Devuelve/espera el formato "crudo" de DynamoDB ({"S": "texto"}, {"N": "20"}) — más verboso |
| Dónde se usa acá | app.py/lambda_function.py (sección 7 y 8) — todo el CRUD del servicio | Los tests con moto (Ejercicio 20) y ddb.create_table(...) en la verificación de la sección 3 — crear una tabla es una operación administrativa que no tiene equivalente en resource |
📌 No son dos SDKs distintos —
resourcees una capa de conveniencia construida encima declient(mismoboto3, mismo servicio, misma autenticación). Para el CRUD del día a día de una tabla ya creada,resourceahorra código; para operaciones de administración de la tabla en sí (crear, borrar, describir),clientes el único camino — por eso ambos aparecen en esta clase, cada uno donde corresponde.
El enrutamiento, explicado: lambda_handler es el único punto de entrada — lee event["routeKey"] (el "MÉTODO /ruta" que definió template.yaml, sección 6) y decide a qué función delegar con una cadena de if. Es el mismo espíritu que el if route_key == ... de un dispatcher manual: no hay "routers" separados como en FastAPI (Clase 3) — acá el enrutamiento vive adentro de una sola función, porque es AWS (vía template.yaml) quien ya decidió qué evento le llega a esta Lambda; lambda_handler solo necesita distinguir CUÁL de las 5 rutas fue.
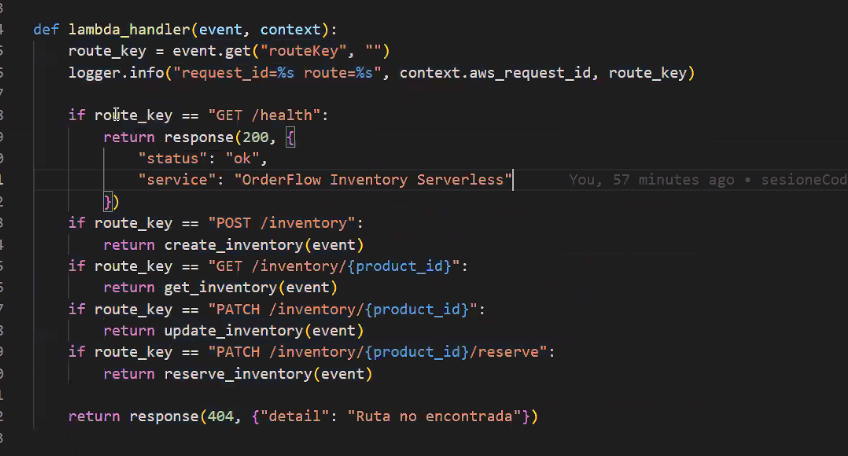
Así se ve el mismo archivo abierto en VS Code (con git blame activado — se alcanza a ver el commit sesioneCode del repo de la sesión) mientras se explica, línea por línea, a qué función llama cada rama: si route_key es "GET /health", la rama responde directo (es la única que no delega a otra función); las 4 restantes ("POST /inventory", "GET /inventory/{product_id}", "PATCH /inventory/{product_id}", "PATCH /inventory/{product_id}/reserve") sí delegan, una por una, a create_inventory(event), get_inventory(event), update_inventory(event) y reserve_inventory(event) respectivamente — las 4 funciones de negocio que se explican completas más abajo.
Las 4 funciones de negocio (create_inventory, get_inventory, update_inventory, reserve_inventory) siguen todas el mismo patrón de 3 pasos:
- Leer y validar la entrada (
product_idde la URL, campos delbody) —400si falta algo o el tipo no es el esperado. - Ejecutar la operación DynamoDB dentro de un
try/except ClientError— distinguirConditionalCheckFailedException(sección 3) de cualquier otro error real de DynamoDB (ese último se loguea conlogger.exceptiony responde500genérico, sin filtrar detalles internos al cliente). - Devolver
api_response(...)con el código y body que correspondan.
✅ El código completo de
create_inventory,get_inventory,update_inventoryyreserve_inventory(con la condición corregida) está verificado end-to-end contra una tabla DynamoDB simulada (moto) en la sección 3 — los 5 endpoints responden exactamente los códigos documentados en la tabla de la sección 10.
🖥️ 8. console_lambda/lambda_function.py — la misma lógica, a mano en la consola
⚠️ Camino alternativo a la sección 7, no un paso siguiente — ver la tabla completa de los "dos caminos" al principio de la nota, junto al 🗺️ Índice.
Esta carpeta representa la otra forma real de tener una Lambda: escribir el código directo en el editor inline de la consola de AWS (sin SAM, sin template.yaml), donde por convención el archivo se llama lambda_function.py y el handler por defecto es lambda_function.lambda_handler.
Comparación con la versión de SAM (sección 7):
src/inventory/ (SAM) | console_lambda/ (consola) | |
|---|---|---|
| Módulos | 2 archivos (app.py + responses.py separado) | 1 solo archivo — la consola no separa módulos con la misma comodidad que un repo local |
| Infraestructura | Declarada en template.yaml, versionada | Se configura a mano, clic por clic, en la consola (tabla, rol IAM, rutas del API Gateway) |
| Despliegue | sam build && sam deploy — repetible, en cualquier cuenta | Copiar/pegar código en el editor web, "Deploy" — manual, no versionado por defecto |
reserve_inventory valida product_id vacío antes de leer el body | ✅ Sí (if not product_id: return ...) | ❌ No — falta esa validación |
Errores DynamoDB no esperados (no ConditionalCheckFailedException) | logger.exception(...) + 500 controlado | raise — se propaga sin capturar, Lambda devuelve un error genérico sin el formato JSON del resto de la API |
Bug de aritmética en ConditionExpression (sección 3) | Presente → corregido en esta nota | Presente también, sin corregir |
⚠️ Por qué importa esta comparación: son la MISMA lógica de negocio escrita dos veces, y ya divergieron en dos bugs reales (
reserve_inventorysin validarproduct_id, y el manejo de errores conraiseen vez de una respuesta controlada). Es el riesgo concreto de mantener código por fuera de un repo versionado: nada obliga a que la versión "de la consola" se actualice cuando se corrige la versión "de SAM", y viceversa — con el tiempo, terminan siendo dos servicios ligeramente distintos aunque deberían ser el mismo.
🧪 Tip de entrevista: ¿por qué en un proyecto real conviene SAM (o cualquier Infrastructure as Code) por sobre editar Lambdas a mano en la consola? Porque el código y la infraestructura quedan versionados junto con el resto del repo (revisable en un PR, reproducible en otra cuenta de AWS, con historial de cambios en git) — editar en la consola es rápido para prototipar, pero no deja rastro auditable ni es fácil de replicar en otro ambiente.
🖱️ Cómo se hizo en la consola de AWS (captura propia)
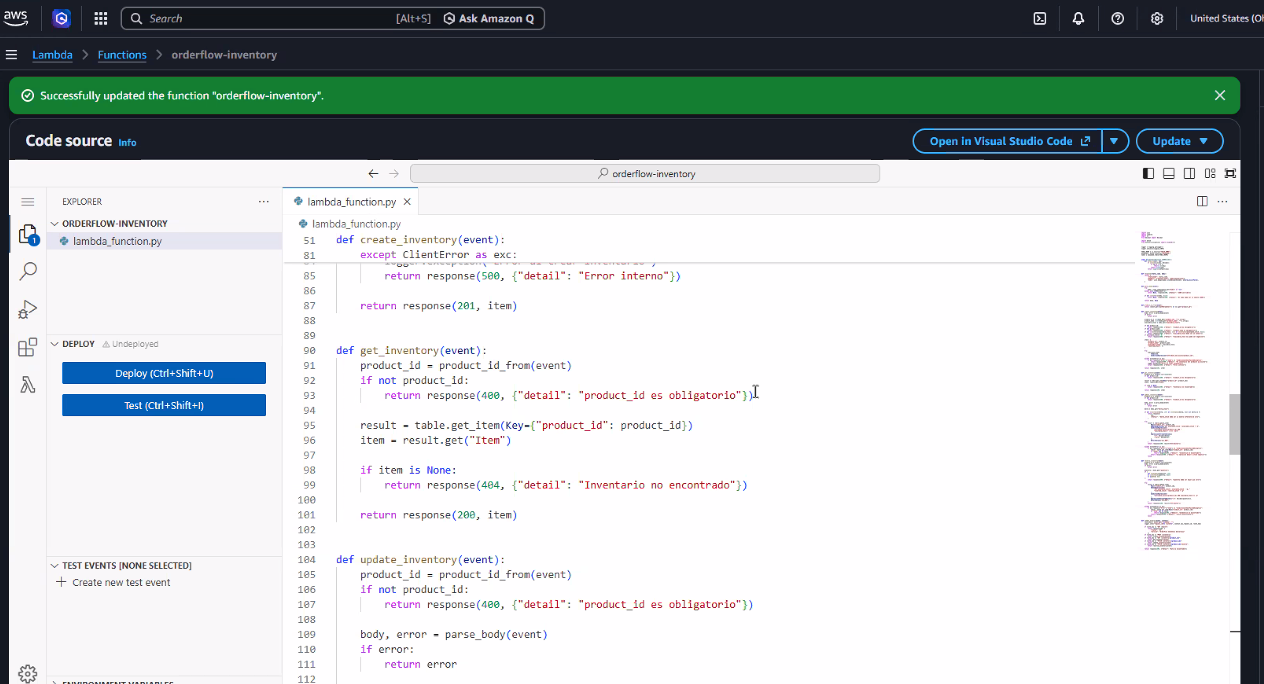
Así se ve en vivo el flujo que describe la tabla comparativa de arriba — Lambda → Functions → orderflow-inventory → Code source, con lambda_function.py pegado directo en el editor embebido de la consola (mismo contenido, línea por línea, que console_lambda/lambda_function.py del repo — se confirma comparando create_inventory en la línea 51, get_inventory en la 90 y update_inventory en la 104 de ambos):
- Explorer (columna izquierda): un solo archivo,
lambda_function.py— sinresponses.pyaparte, tal como se explicó arriba (la consola no separa módulos con la misma comodidad que un repo local). - Deploy (Ctrl+Shift+U): sube el contenido del editor como la versión activa de la función. El banner verde ("Successfully updated the function") confirma que este deploy puntual salió bien — es el equivalente, a mano, de
sam deploy(sección 10), pero sin pasar portemplate.yamlni quedar versionado en git. - Test (Ctrl+Shift+I) + "Create new test event": la forma de probar sin salir de la consola. Ahí se pega el mismo JSON que ya está en
events/(sección 9) — por ejemplo, el contenido completo deevents/get_inventory.json— y "Test" invoca la función real (contra la tablaOrderFlowInventoryreal, no una simulada) y muestra la respuesta y los logs de CloudWatch, sin necesitarsam local invokeni Docker.

El JSON de ejemplo ("key1": "value1"...) que trae el template "Hello World" es solo un placeholder genérico — hay que borrarlo entero y pegar el contenido real de uno de los archivos de events/ (sección 9), por ejemplo el de get_inventory.json, para que el evento tenga la forma exacta que espera lambda_handler (routeKey, pathParameters, etc.). El botón "Format JSON" sirve después de pegar, para reindentar el JSON pegado.
💡 Un mismo archivo de evento sirve para las dos formas de probar: el JSON de
events/reserve_inventory.json(sección 9) es exactamente lo que se pegaría en "Create new test event" acá — la única diferencia es quesam local invokelo corre en tu máquina contra una emulación, y "Test" de la consola lo corre en AWS de verdad, contra la Lambda y la tabla reales.
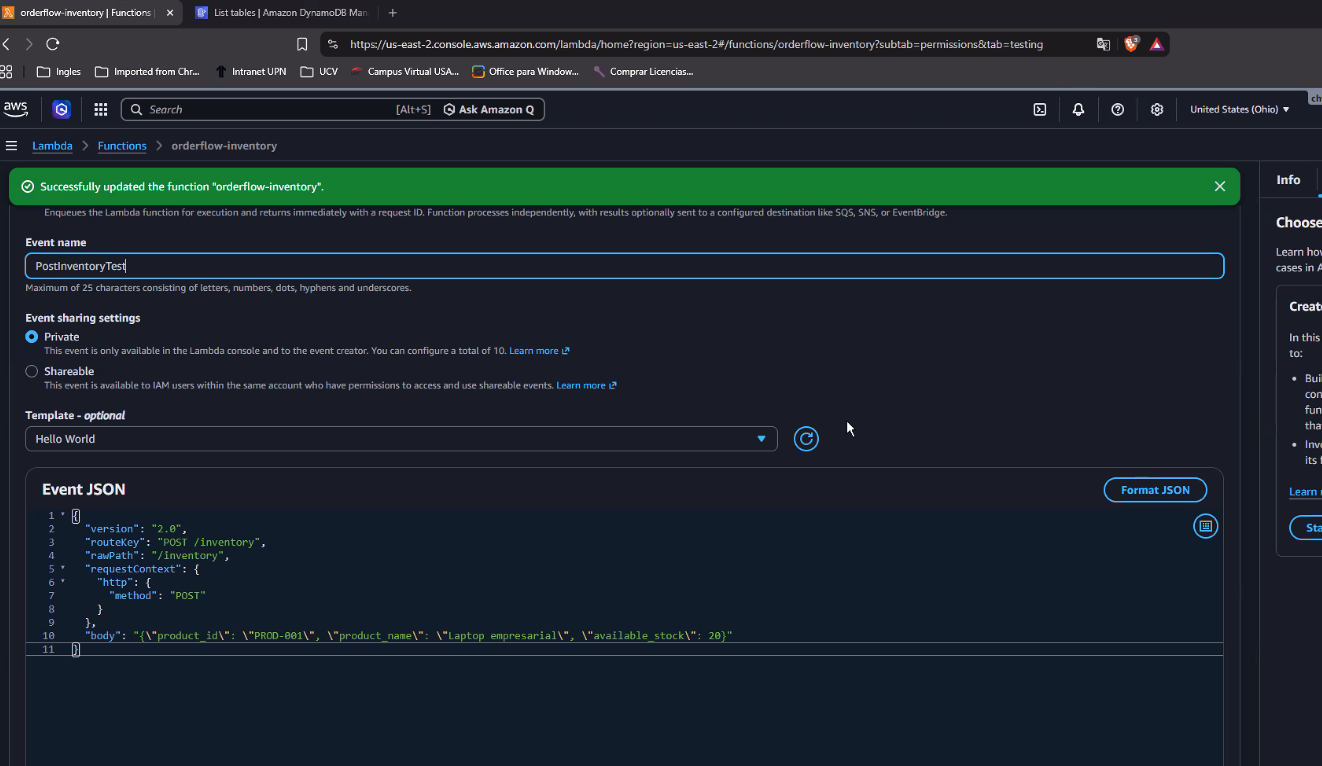
Evento de prueba real, ya nombrado y con el JSON pegado — es el mismo contenido exacto de events/post_inventory.json (sección 9), solo que acá vive guardado adentro de la función en la consola (Event name: PostInventoryTest), en vez de en un archivo del repo. Cualquiera de los 4 archivos de events/ sirve para armar un test event con este mismo procedimiento (nombrarlo, pegar el JSON, guardar).
📌 La región importa: la barra de direcciones de esta captura muestra
us-east-2(Ohio) — nous-east-1, la región que sugiereREADME.md(sección 5) como valor por defecto desam deploy --guided:Valores sugeridos: - Stack Name: orderflow-session8 - Region: us-east-1No es un error: cualquier región sirve para practicar, siempre que todos los recursos (Lambda, tabla DynamoDB, API Gateway) queden en la MISMA región — mezclar regiones entre recursos relacionados es una fuente clásica de errores "no encontrado" que en realidad son "buscaste en el lugar equivocado".
Dónde está el botón "Test" y qué muestra al ejecutar:
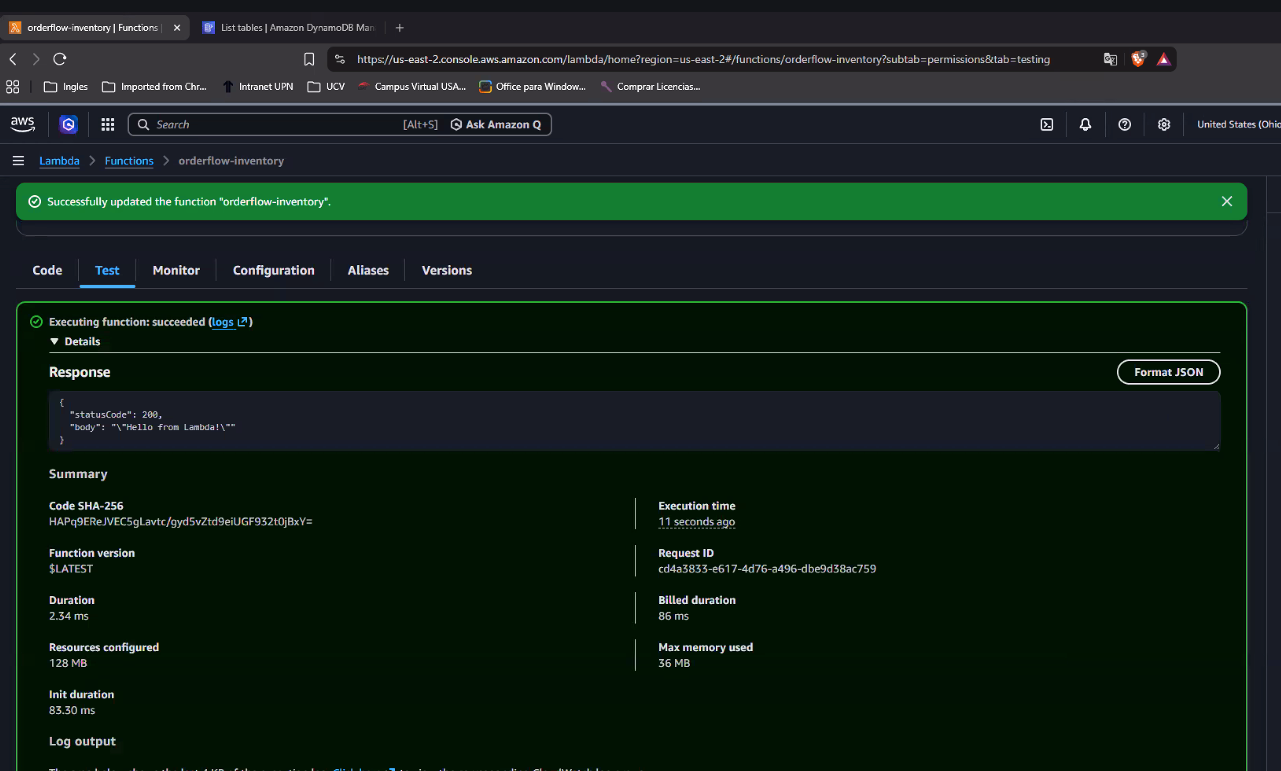
El botón Test no está en el editor de código — vive en la barra de pestañas de la función, al mismo nivel que Code, Monitor, Configuration, Aliases y Versions (arriba del todo, debajo del banner de deploy). Al ejecutar un test event, esta pestaña muestra: el resultado (Response), y un resumen con Duration, Billed duration, Resources configured/Max memory used, Init duration y el Request ID — los mismos datos que después aparecen en los logs de CloudWatch.
⚠️ Ojo con lo que devolvió ESTE test puntual:
{"statusCode": 200, "body": "\"Hello from Lambda!\""}— es la respuesta del código de plantilla por defecto que trae cualquier función Lambda de Python nueva (return {'statusCode': 200, 'body': json.dumps('Hello from Lambda!')}), NO la respuesta real decreate_inventory(que debería dar201con el item creado). Es la prueba visual, en vivo, de la advertencia de arriba: si "Test" corre contra un test event distinto al que se acaba de crear (o contra una versión todavía no desplegada), el resultado que se ve es el de la versión/evento equivocados — hay que confirmar, antes de leer el resultado, que el test event seleccionado en el desplegable es el correcto (PostInventoryTest, en este caso) y que el código ya está desplegado.
La causa exacta del resultado anterior — falta un Deploy en la pestaña Code:
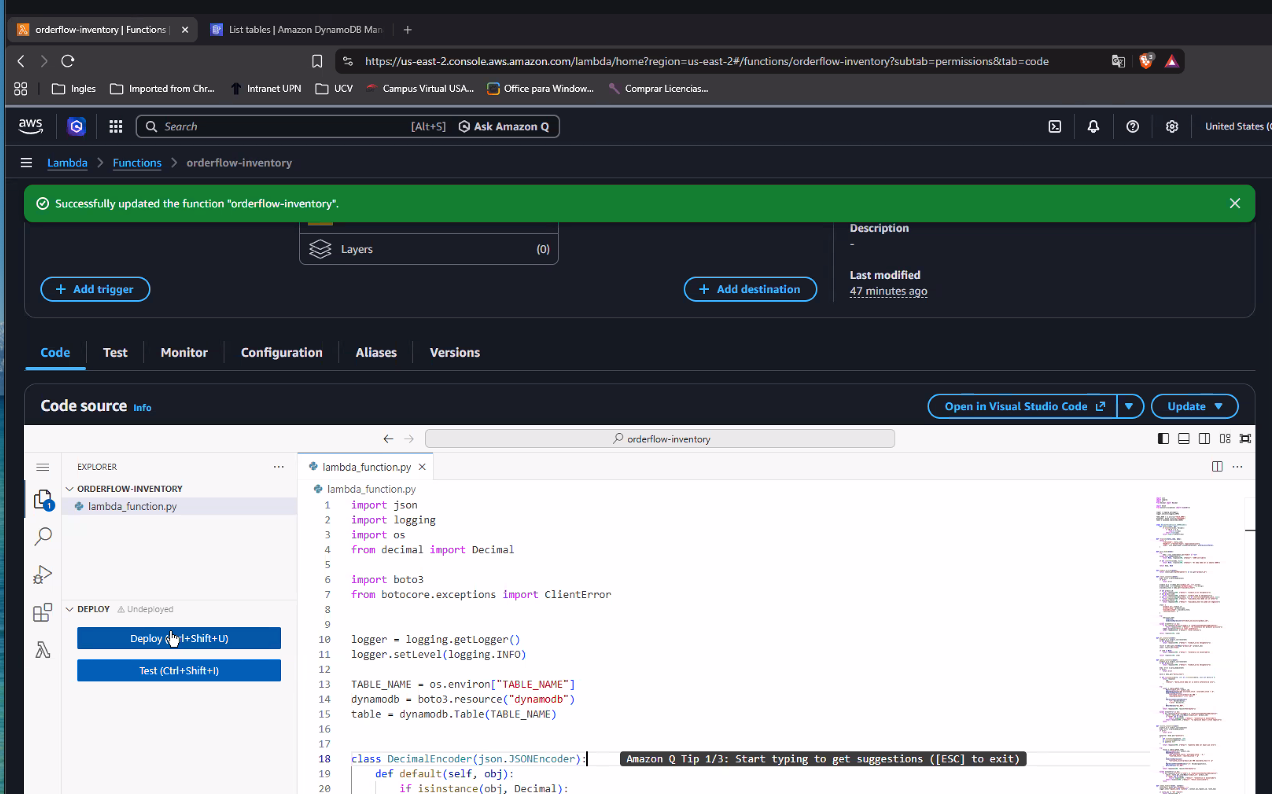
Esta es la explicación en vivo de por qué la ejecución anterior devolvió el "Hello from Lambda!" de plantilla: en la pestaña Code (no en Test), la sección DEPLOY de la barra lateral queda marcada Undeployed mientras el código real (lambda_function.py, con la lógica de OrderFlow Inventory) está escrito en el editor pero todavía no se subió como la versión activa de la función — solo pegar o escribir código ahí no alcanza. Hay que:
- Pararse en la pestaña Code.
- Hacer clic en Deploy (Ctrl+Shift+U) (el botón azul de la barra lateral, debajo de
DEPLOY) — recién ahí la sección deja de decirUndeployedy el banner verde confirma"Successfully updated the function". - Solo entonces pasar a la pestaña Test y correr el test event — ahora sí invoca el código real, no el de la última versión desplegada (que podía ser, como en la captura anterior, todavía la plantilla por defecto).
⚠️ El botón "Deploy" de la barra lateral queda marcado como pendiente (
Undeployed) apenas se toca una letra del editor después del último deploy exitoso — es el aviso de la consola de que el código en pantalla todavía no es el que está corriendo de verdad. Si se prueba con "Test" sin haber hecho "Deploy" primero, se invoca la ÚLTIMA versión desplegada, no lo que se ve en el editor — exactamente lo que pasó en la captura de arriba.
🌐 Crear el HTTP API a mano, en la consola (captura propia)
Con la Lambda ya funcionando (probada desde el botón Test, arriba), falta la pieza que la conecta con una URL pública real: el HTTP API. En template.yaml (sección 6) esto es un solo recurso (AWS::Serverless::HttpApi + los 5 Events) — a mano, en la consola, son varios pasos separados:
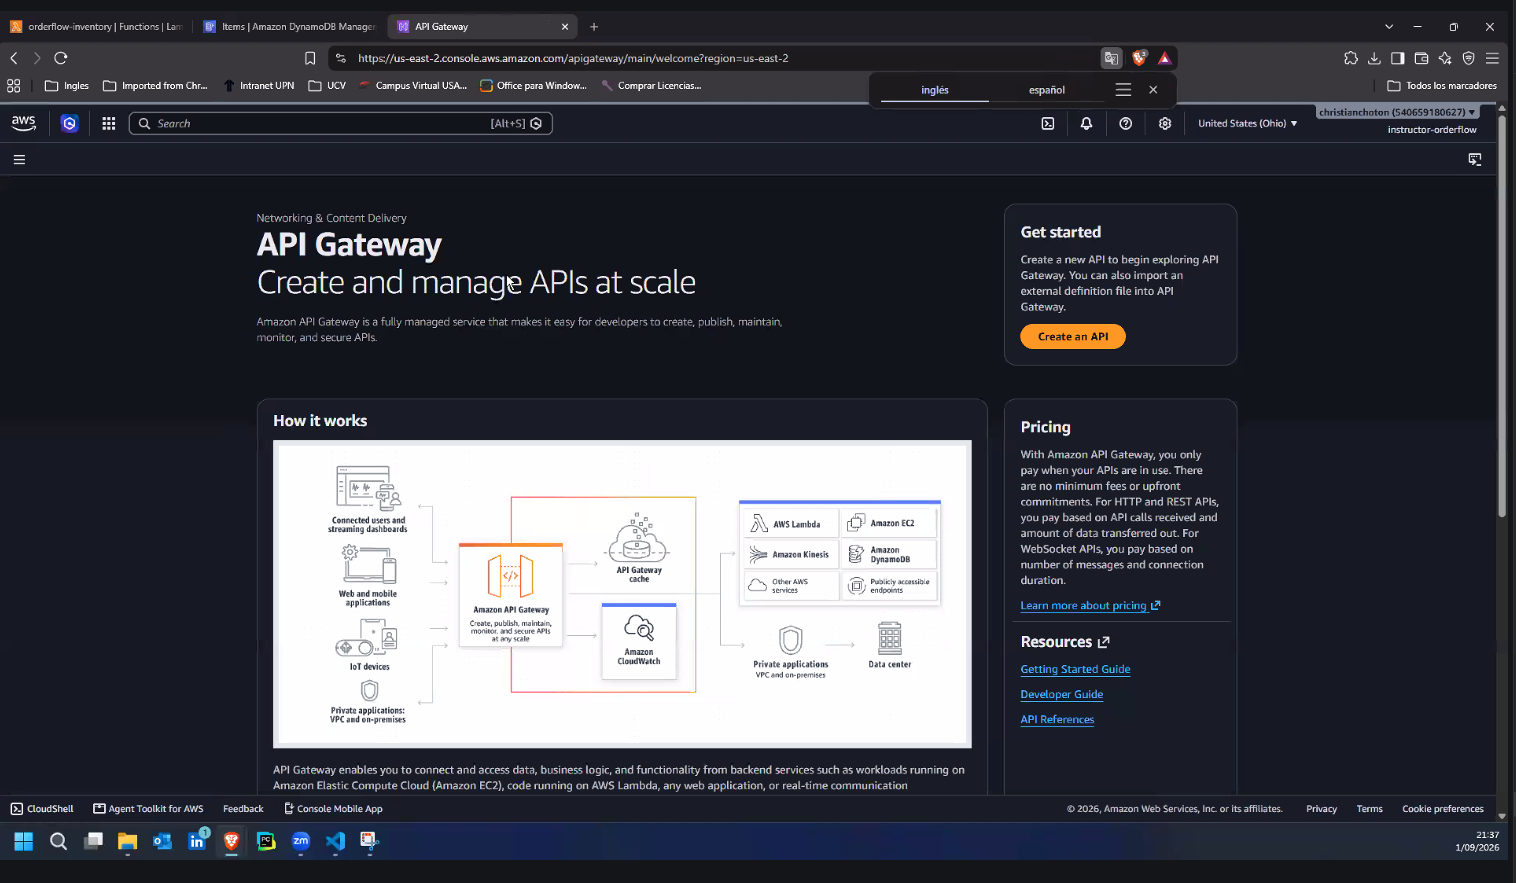
Paso 1 — Elegir el tipo de API. API Gateway ofrece 3 tipos; el proyecto usa HTTP API (la misma elección que hace template.yaml, sección 6):
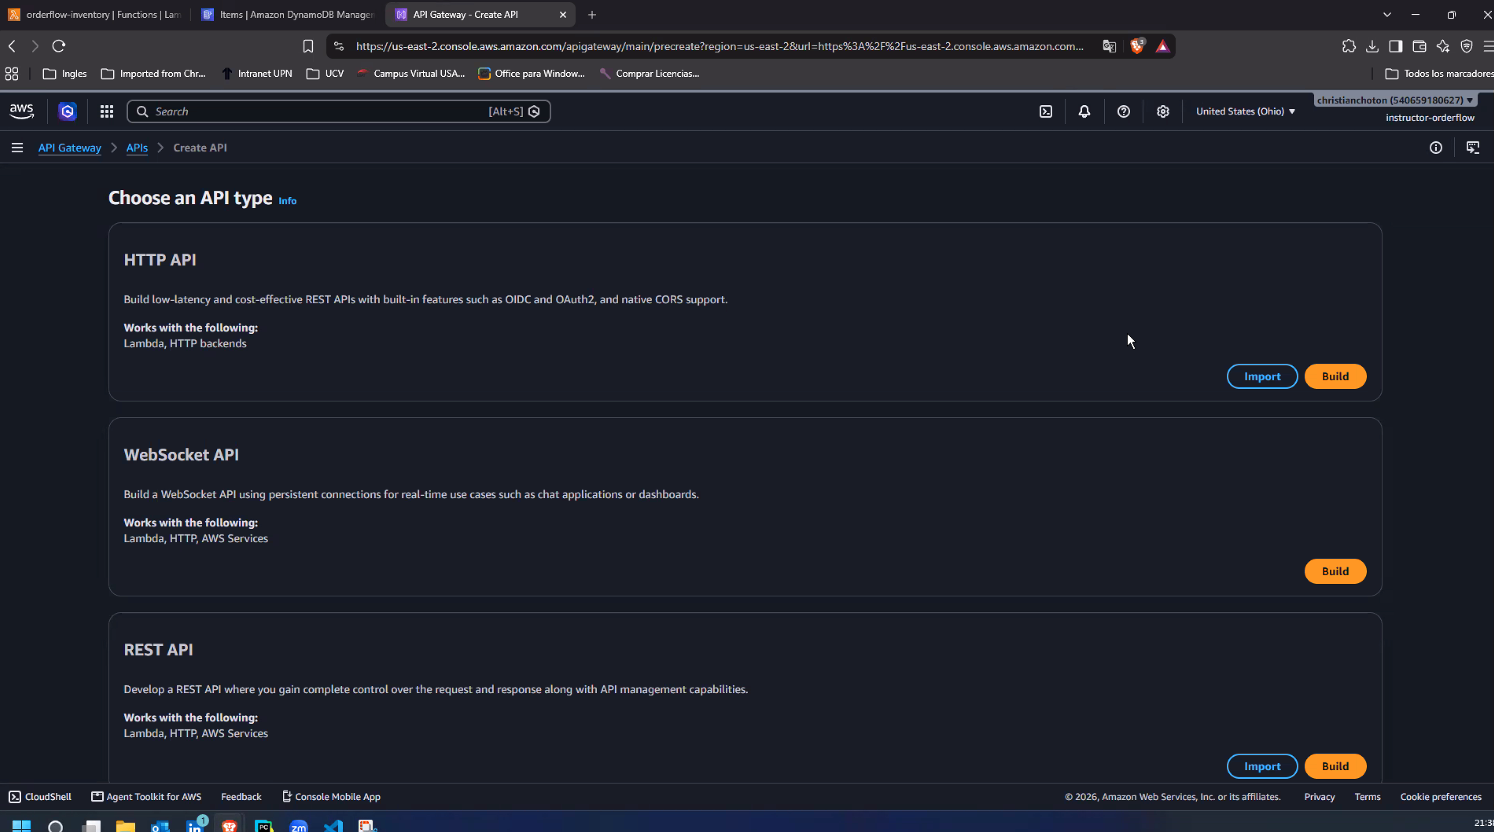
| Tipo | Para qué sirve | ¿Lo usa este proyecto? |
|---|---|---|
| HTTP API | REST de bajo costo y baja latencia, con OIDC/OAuth2 y CORS nativos — funciona con Lambda o backends HTTP | ✅ Sí — es AWS::Serverless::HttpApi en template.yaml |
| WebSocket API | Conexiones persistentes para tiempo real (chats, dashboards en vivo) | ❌ No — este servicio es puro request/response |
| REST API | El tipo más viejo y completo, con más funciones avanzadas (y más caro) que HTTP API | ❌ No — HTTP API alcanza de sobra para 5 endpoints CRUD |
🧪 Tip de entrevista: si HTTP API es más barato y de menor latencia, ¿por qué existe igual REST API? Porque REST API todavía tiene funciones que HTTP API no replica completas (planes de uso con API keys, transformaciones de request/response más avanzadas, integración con AWS WAF directa). Para un servicio nuevo sin esas necesidades puntuales, HTTP API es la opción por defecto — más simple y más barata.
Paso 2 — Configurar la API y agregar la integración con Lambda:
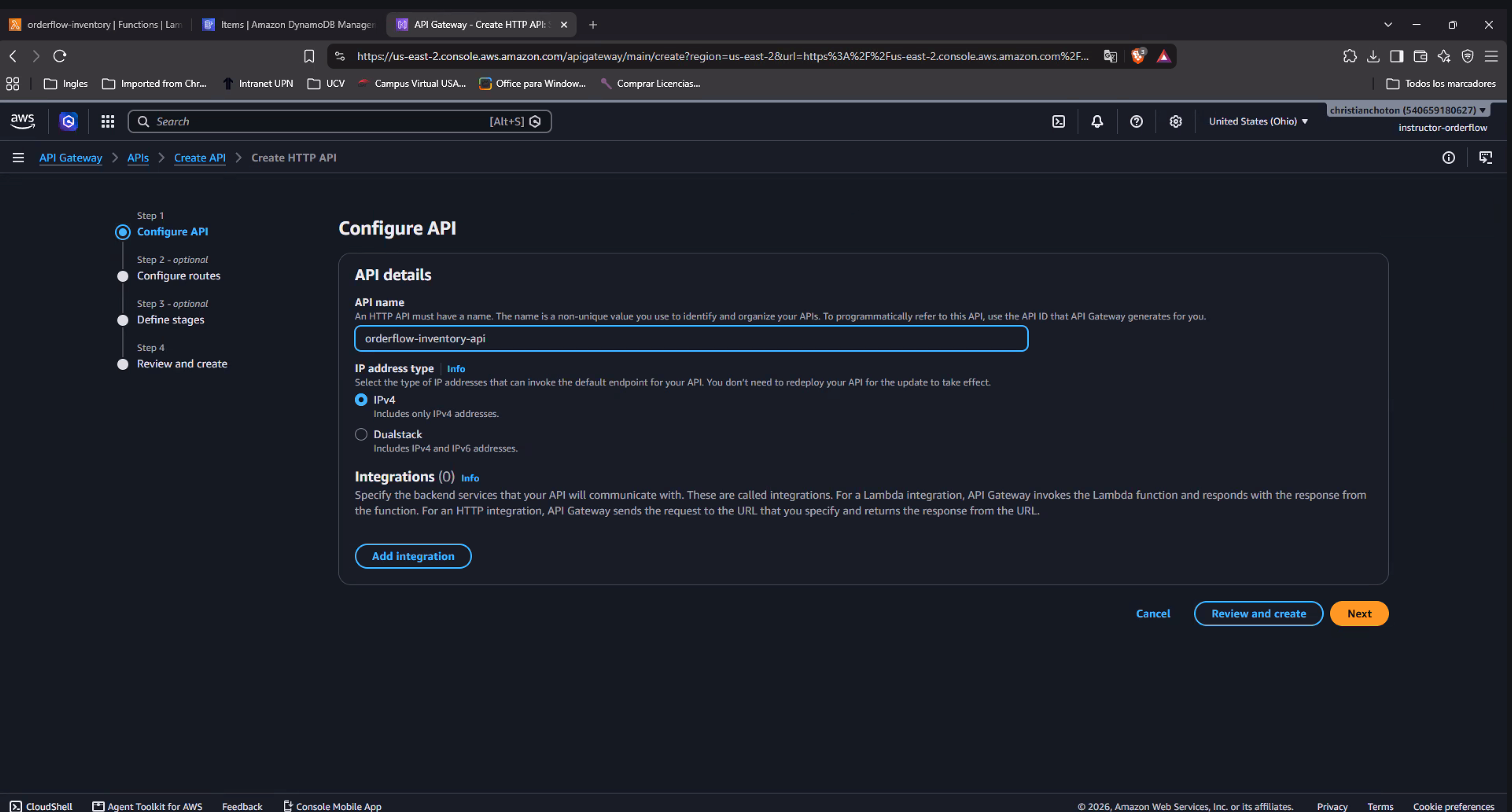
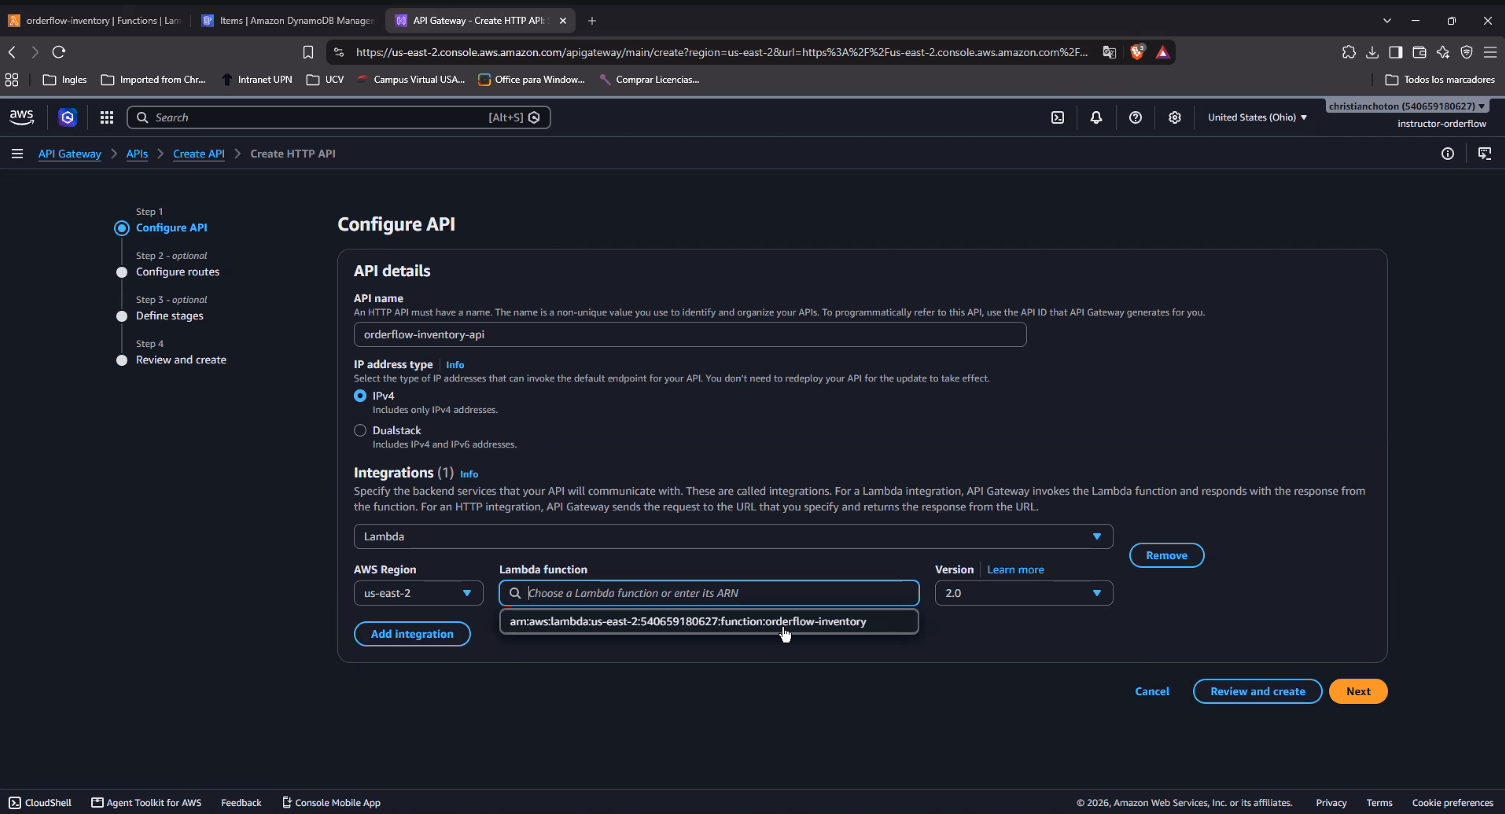
- API name:
orderflow-inventory-api— un nombre libre, solo identifica la API en la consola (no aparece en la URL pública). - Integrations → Lambda: acá es donde la API queda "enchufada" a la función — eligiendo la misma región (
us-east-2) donde viveorderflow-inventory(confirmando, una vez más, la importancia de no mezclar regiones entre recursos relacionados — 06-Errores). - Version:
2.0— el payload format version, la misma versión "2.0" que ya se ve en cada archivo deevents/*.json(sección 9, campo"version": "2.0") y que define la FORMA exacta deleventque le llega alambda_handler(routeKey,rawPath, etc., sección 7). Si acá se eligiera1.0, el evento tendría una forma distinta y el código actual (event.get("routeKey")) dejaría de funcionar.
💡 Un solo
Add integration, no cinco. A diferencia detemplate.yaml(donde cada uno de los 5 endpoints es un bloqueEventsseparado, pero TODOS apuntan a la mismaInventoryFunction), acá la integración con la Lambda se configura una sola vez en este paso — las rutas puntuales (GET /health,POST /inventory, etc.) se arman después, en el paso "Configure routes" del asistente, cada una reutilizando esta misma integración.
⚠️ Este asistente todavía no completó los pasos "Configure routes" ni "Define stages" (ambos marcados optional en la barra lateral, pero necesarios para que la API responda de verdad) — sin rutas configuradas, la API existiría pero ningún método/path llegaría a invocar la Lambda.
Paso 3 — Configurar las 5 rutas (Step 2 - optional: Configure routes), cada una con su método y su path — las MISMAS 5 combinaciones que ya declara template.yaml (sección 6) y que documenta README.md (sección 5):
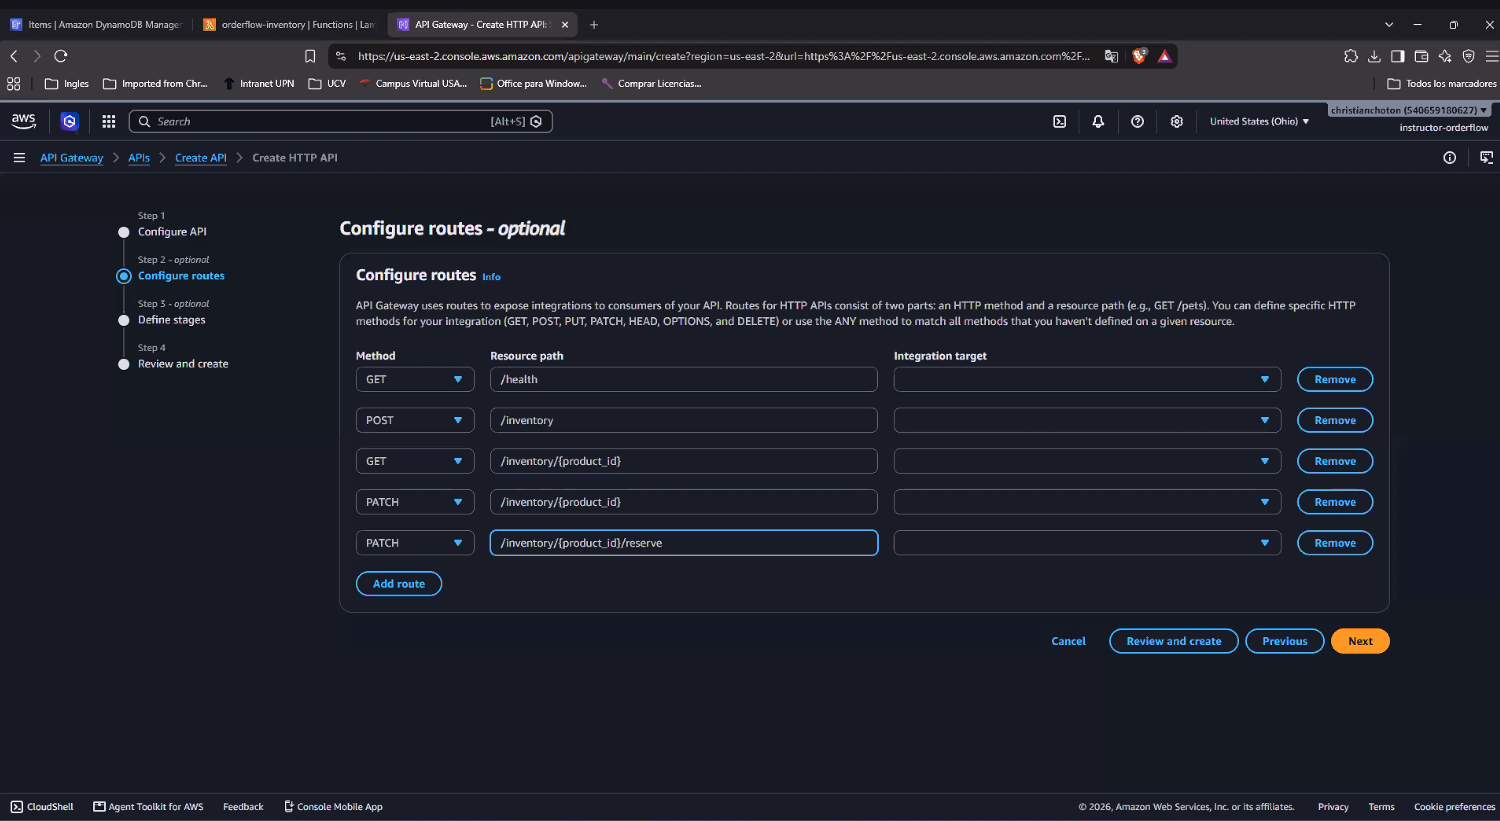
En esta primera captura las 5 rutas ya están cargadas (método + Resource path, incluido el path param {product_id} con la misma sintaxis de llaves que usa template.yaml), pero la columna Integration target está vacía — cada ruta todavía no sabe a qué Lambda reenviar. El paso final es elegir, en cada una de las 5, la integración creada antes (orderflow-inventory):
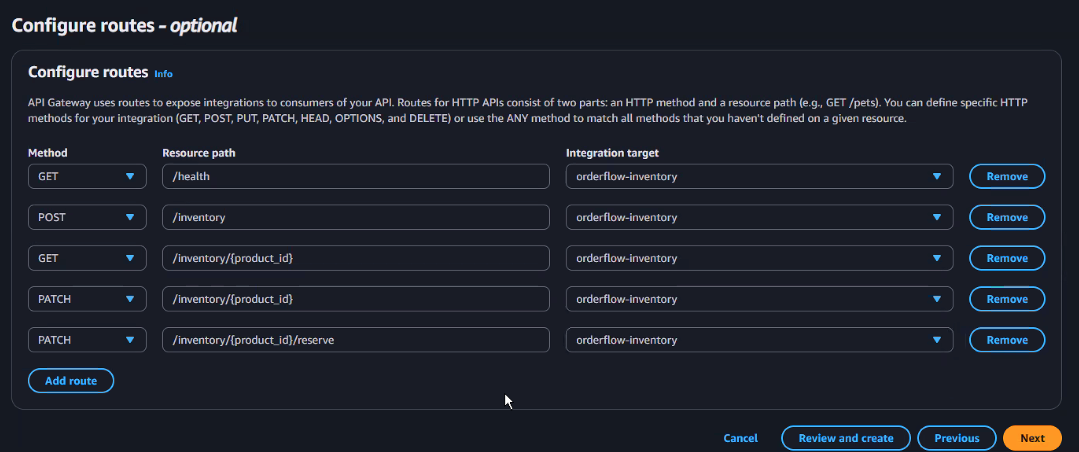
💡 Por qué son 5 filas y no una sola "catch-all": a diferencia del
proxy()genérico del API Gateway Pattern hecho a mano en la Clase 7 (que usaba{path:path}para capturar cualquier ruta con una sola función), acá cada combinación método+path es una ruta explícita y separada — es la misma filosofía que ya declarabatemplate.yamlcon sus 5 bloquesEvents: todas apuntan a la MISMA Lambda (lambda_handlersigue siendo quien distingue porrouteKeypuertas adentro, sección 7), pero API Gateway igual necesita conocer de antemano cada ruta válida para poder rechazar con404las que no existen, antes de llegar siquiera a invocar la función.
Resultado — la API ya creada, con sus 5 rutas:
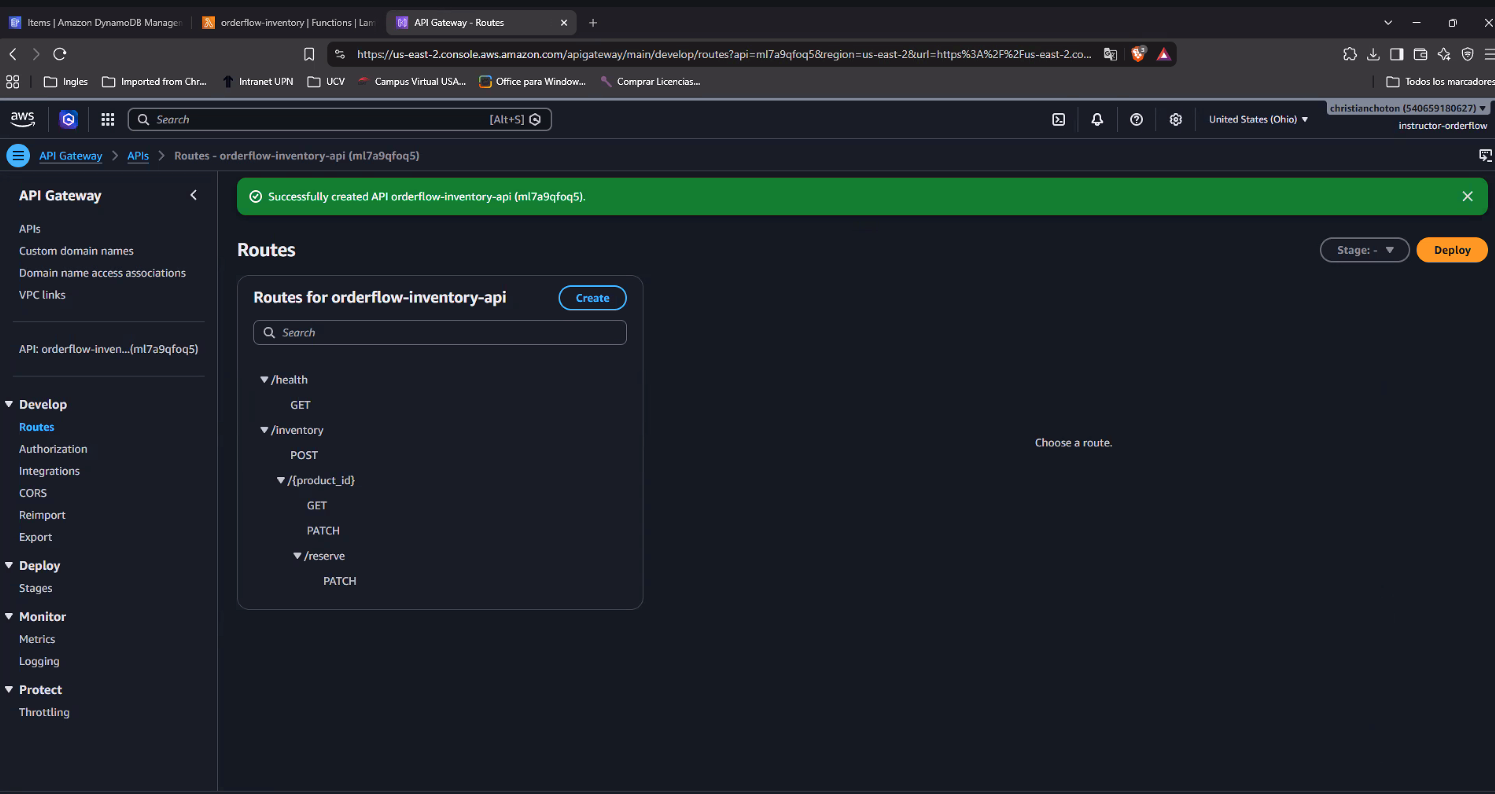
La consola confirma la creación con el ID real de la API (ml7a9qfoq5, distinto en cada cuenta/región) y agrupa las 5 rutas en un árbol por path — se nota cómo /inventory/{product_id} y /inventory/{product_id}/reserve comparten el mismo tronco /inventory → /{product_id}, con GET/PATCH colgando del primero y PATCH de /reserve colgando del segundo.
La API details, un paso más adelante — ya con su stage $default:
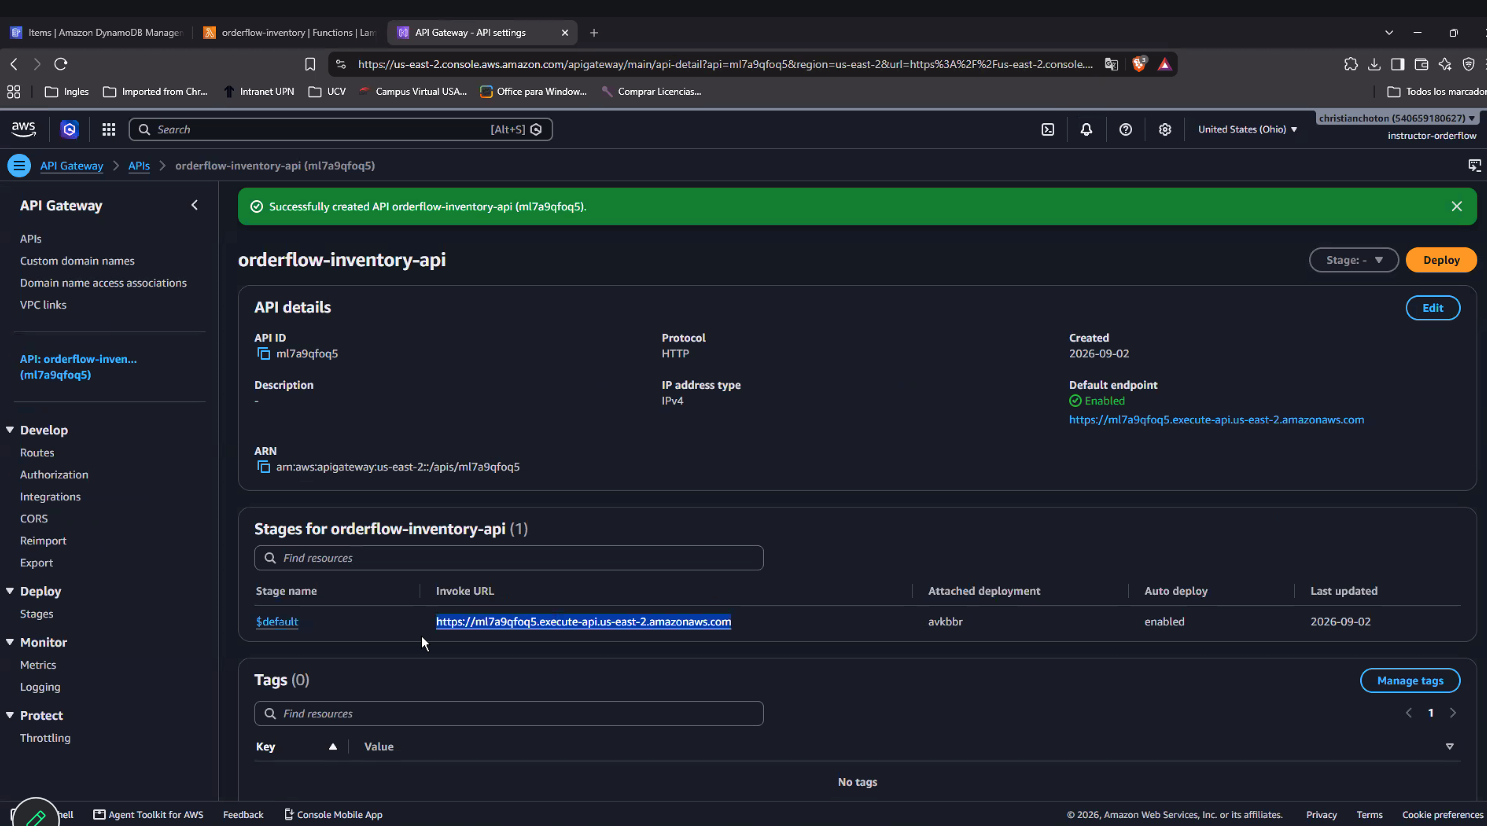
📝 Corrección sobre el aparte anterior: no hacía falta un "Deploy" manual aparte — el asistente de creación de un HTTP API arma automáticamente el stage
$default(tabla "Stages", 1 fila) conAuto deploy: enabled. Es una diferencia real frente a REST API (el tipo más viejo, sección de arriba), que sí exige un deploy explícito a un stage antes de quedar accesible — con HTTP API y su$default, cada cambio de ruta queda publicado solo. Coincide, en el fondo, con por quétemplate.yaml(sección 6) elige justoStageName: $default.
Confirmación real, de punta a punta — la URL pública responde:
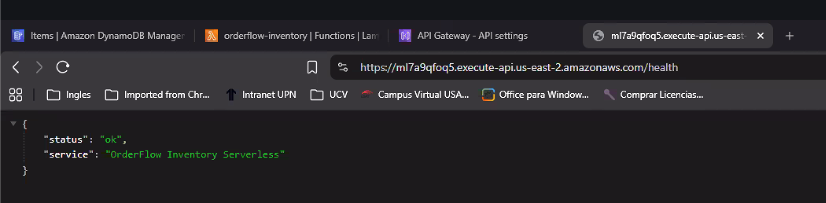
GET /health — sin Postman, sin curl, solo pegando la URL en el navegador — ya responde el JSON real que arma health() (sección 7): {"status": "ok", "service": "OrderFlow Inventory Serverless"}. Con esto, el recorrido completo del stack manual queda cerrado y confirmado extremo a extremo: API Gateway (HTTP API) → Lambda (orderflow-inventory) → respuesta real, la misma arquitectura de tres piezas del 🗺️ diagrama de la sección 2, armada esta vez a mano en la consola en vez de con sam deploy.
Probando un POST real con Talend API Tester (otra herramienta cliente HTTP, extensión de Chrome — misma idea que Postman/Insomnia/Bruno, distinto software):
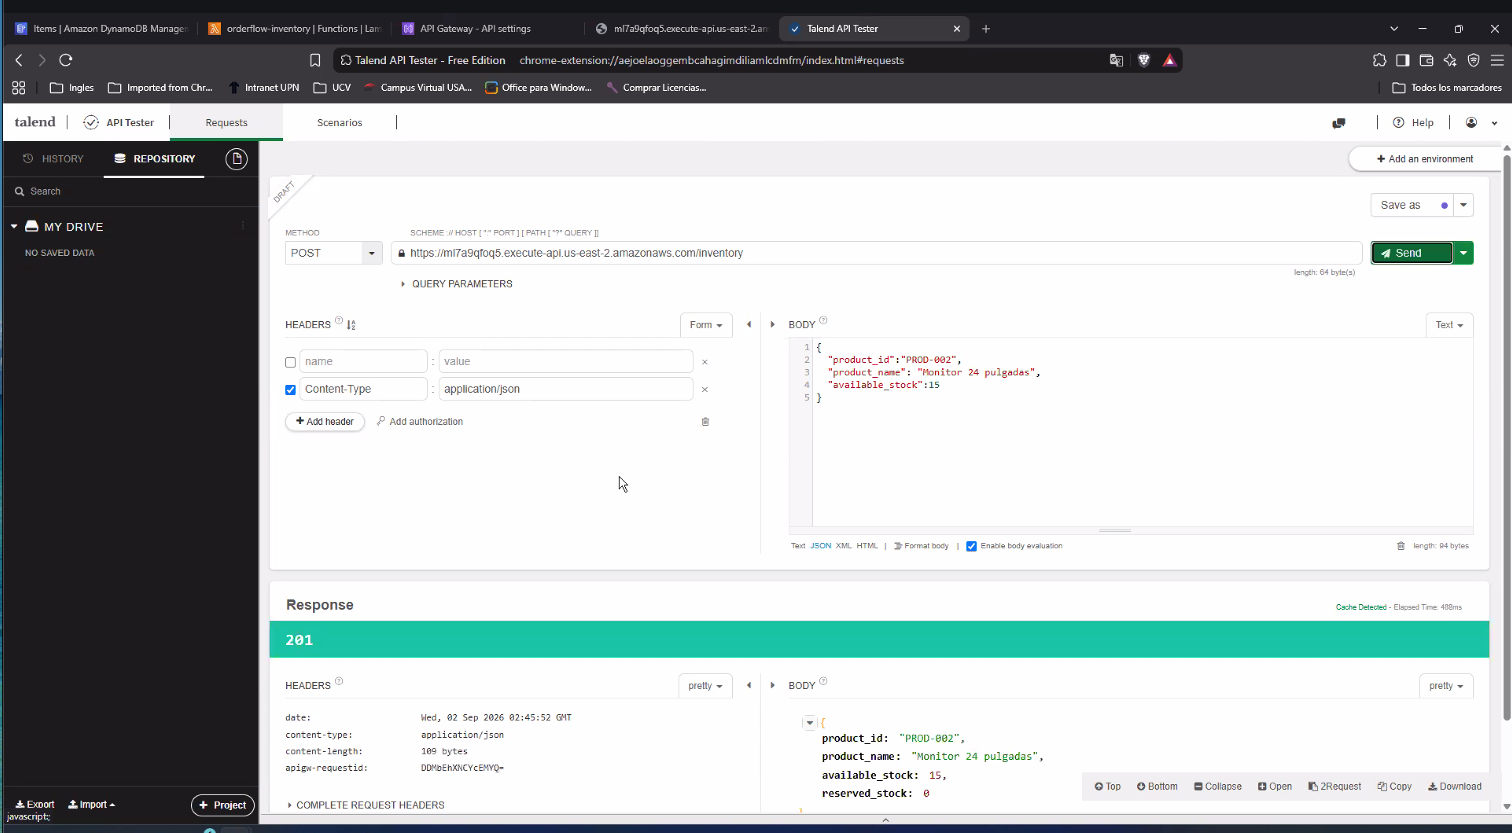
Mismo endpoint (POST /inventory), mismos campos que ya se probaron desde la consola de Lambda (sección 8), pero esta vez pegándole a la URL pública real del HTTP API en vez de usar el botón "Test" de Lambda — la respuesta (201, con reserved_stock: 0 puesto por el servidor) confirma que el camino completo cliente externo → API Gateway → Lambda → DynamoDB funciona de punta a punta, sin ningún atajo interno de la consola de por medio.
Y la validación final, del lado de la base de datos — el Scan ahora devuelve 2 items, no 1:
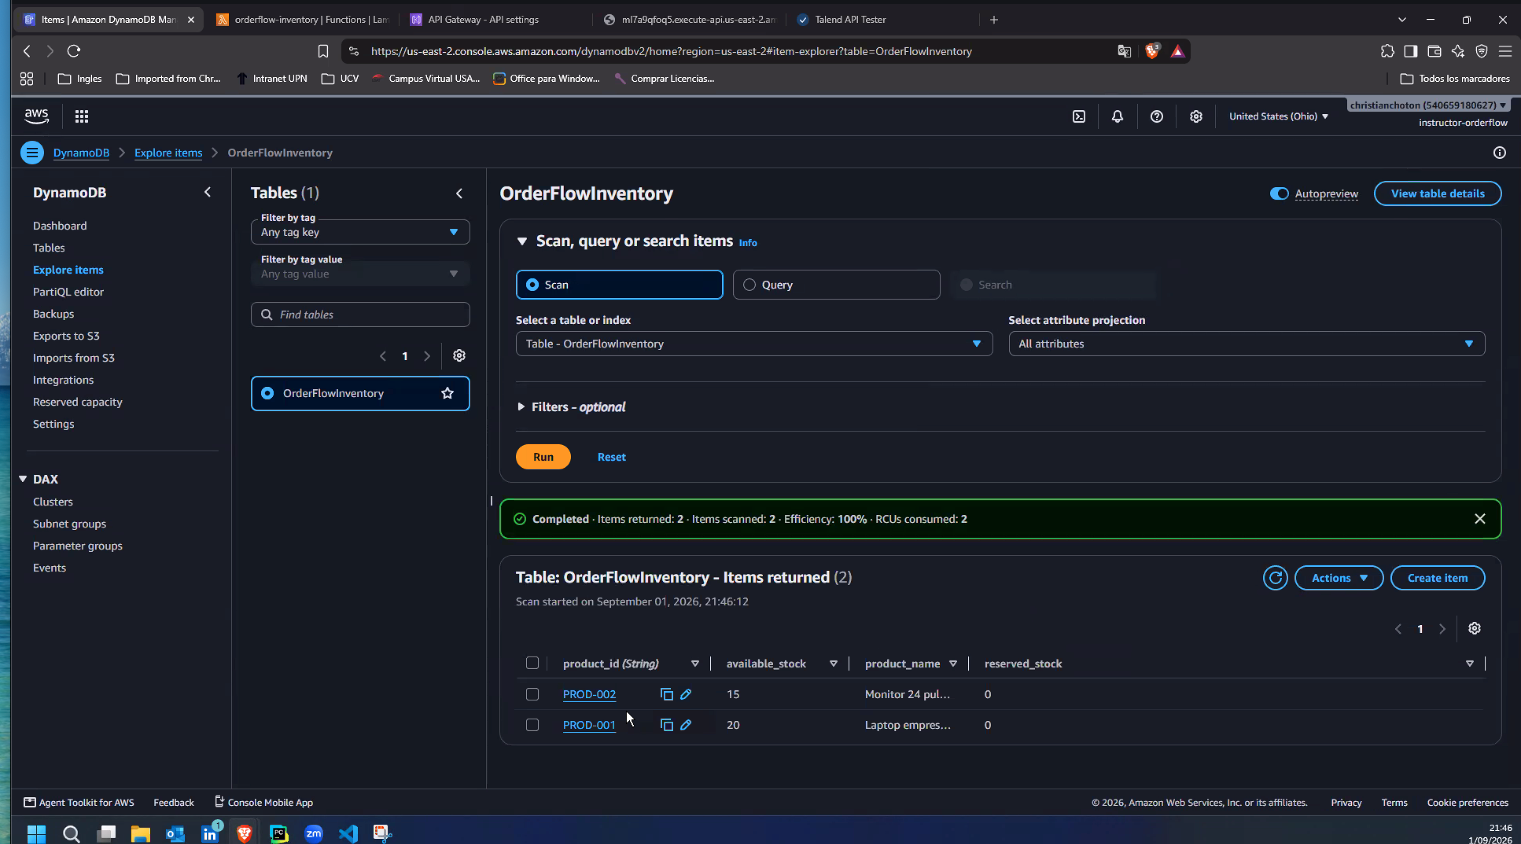
PROD-001 (creado antes, desde el botón Test de Lambda, sección 8) y PROD-002 (creado ahora, desde Talend API Tester, a través de la URL pública) conviven en la misma tabla — la prueba de que ambos caminos (Test de la consola de Lambda, y un cliente HTTP real contra la URL de API Gateway) terminan escribiendo en el mismo lugar real, no en algo simulado.
📝 lambda_function.py comentado línea por línea (para estudiar)
La misma versión de console_lambda/lambda_function.py, con un comentario en cada bloque explicando qué hace y por qué — para repasar sin tener que saltar entre secciones. Los comentarios marcados # ⚠️ señalan los dos puntos donde esta copia difiere de src/inventory/app.py (ya documentados en la tabla comparativa de arriba y en 06-Errores).
python
import json
import logging
import os
from decimal import Decimal

import boto3                                  # SDK de AWS para Python (glosario, sección 1)
from botocore.exceptions import ClientError    # excepción base de CUALQUIER error que devuelva un servicio de AWS


logger = logging.getLogger()          # logger raíz — todo lo que loguee termina en CloudWatch Logs (sección 8)
logger.setLevel(logging.INFO)         # a partir de qué nivel se registra (INFO y más grave; DEBUG quedaría afuera)

TABLE_NAME = os.environ["TABLE_NAME"]        # Lambda inyecta esta variable — Configuration → Environment variables
dynamodb = boto3.resource("dynamodb")        # cliente de ALTO nivel (objetos), no boto3.client (sección 7)
table = dynamodb.Table(TABLE_NAME)           # referencia reusable a LA tabla — no hace una llamada de red todavía


class DecimalEncoder(json.JSONEncoder):
    # DynamoDB devuelve todos los números como Decimal (sección 1) — json.dumps()
    # NO sabe serializar Decimal por defecto, por eso hace falta este encoder a medida
    def default(self, obj):
        if isinstance(obj, Decimal):
            if obj % 1 == 0:
                return int(obj)      # 20.0 -> 20 (sin ".0" en el JSON de salida)
            return float(obj)        # solo si de verdad tuviera decimales (no pasa en este servicio)
        return super().default(obj)  # cualquier otro tipo, que lo maneje json normal


def response(status_code, body):
    # Arma la forma EXACTA que espera API Gateway (payload format 2.0, sección 7):
    # statusCode + headers + body como STRING (no como dict)
    return {
        "statusCode": status_code,
        "headers": {"Content-Type": "application/json"},
        "body": json.dumps(body, cls=DecimalEncoder, ensure_ascii=False),
    }


def parse_body(event):
    # event["body"] SIEMPRE llega como string (ver events/*.json, sección 9) —
    # json.loads lo convierte a dict de Python; puede fallar de dos formas distintas
    try:
        body = json.loads(event.get("body") or "{}")   # "{}" si no vino body (ej. un GET)
    except json.JSONDecodeError:
        return None, response(400, {"detail": "JSON inválido"})   # ni siquiera era JSON

    if not isinstance(body, dict):
        return None, response(400, {"detail": "El body debe ser un objeto JSON"})   # era JSON, pero no un objeto (ej. una lista)

    return body, None   # "None" de error = todo OK, seguir


def product_id_from(event):
    # pathParameters solo existe si la ruta declaró {product_id} en template.yaml (sección 6)
    return (event.get("pathParameters") or {}).get("product_id")


def create_inventory(event):
    body, error = parse_body(event)
    if error:
        return error   # ya es una respuesta 400 lista para devolver, no un dict de negocio

    # .strip() saca espacios accidentales; "" por defecto si faltan, para que la
    # validación de abajo los agarre como "vacío" en vez de romper con KeyError
    product_id = str(body.get("product_id", "")).strip()
    product_name = str(body.get("product_name", "")).strip()
    available_stock = body.get("available_stock")

    if not product_id:
        return response(400, {"detail": "product_id es obligatorio"})
    if not product_name:
        return response(400, {"detail": "product_name es obligatorio"})
    # bool es subclase de int en Python -> hay que excluirlo a mano (glosario, Ejercicio 10)
    if not isinstance(available_stock, int) or isinstance(available_stock, bool):
        return response(400, {"detail": "available_stock debe ser un entero"})
    if available_stock < 0:
        return response(400, {"detail": "available_stock no puede ser negativo"})

    item = {
        "product_id": product_id,
        "product_name": product_name,
        "available_stock": available_stock,
        "reserved_stock": 0,   # HARDCODEADO a propósito — nadie puede crear un producto ya con reservas (Ejercicio 2)
    }

    try:
        table.put_item(
            Item=item,
            # condición atómica (sección 3): si YA existe un item con este product_id, cancela todo
            ConditionExpression="attribute_not_exists(product_id)",
        )
    except ClientError as exc:
        if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
            return response(409, {"detail": "El inventario del producto ya existe"})
        logger.exception("Error al crear inventario")   # cualquier OTRO error de DynamoDB -> se loguea completo
        return response(500, {"detail": "Error interno"})   # pero al cliente solo un mensaje genérico

    return response(201, item)   # 201 Created + el item recién guardado


def get_inventory(event):
    product_id = product_id_from(event)
    if not product_id:
        return response(400, {"detail": "product_id es obligatorio"})

    result = table.get_item(Key={"product_id": product_id})   # NUNCA lanza excepción si no encuentra nada
    item = result.get("Item")                                  # simplemente no viene la clave "Item" en la respuesta

    if item is None:
        return response(404, {"detail": "Inventario no encontrado"})   # "no encontrado" no es un error de la base

    return response(200, item)


def update_inventory(event):
    product_id = product_id_from(event)
    if not product_id:
        return response(400, {"detail": "product_id es obligatorio"})

    body, error = parse_body(event)
    if error:
        return error

    delta = body.get("delta_stock")   # puede ser negativo (restar) o positivo (sumar/reponer, Ejercicio 5)

    if not isinstance(delta, int) or isinstance(delta, bool) or delta == 0:
        return response(
            400,
            {"detail": "delta_stock debe ser un entero diferente de cero"},
        )

    try:
        result = table.update_item(
            Key={"product_id": product_id},
            # UpdateExpression SÍ admite aritmética (sección 3): available_stock += delta
            UpdateExpression="SET available_stock = available_stock + :d",
            # ⚠️ BUG REAL: ConditionExpression NO admite aritmética — "available_stock + :d"
            # rompe contra DynamoDB de verdad (ValueError al parsear). Corrección documentada
            # en 06-Errores/2026-09-01-dynamodb-conditionexpression-no-admite-aritmetica.md
            ConditionExpression=(
                "attribute_exists(product_id) AND "
                "available_stock + :d >= :zero"
            ),
            ExpressionAttributeValues={
                ":d": Decimal(delta),      # boto3 exige Decimal, no int/float, para números (sección 1)
                ":zero": Decimal(0),
            },
            ReturnValues="ALL_NEW",        # que devuelva el item YA actualizado, no el de antes
        )
        return response(200, result["Attributes"])

    except ClientError as exc:
        if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
            # la condición falló, pero ¿por qué? Hay que diagnosticar con una lectura aparte
            check = table.get_item(Key={"product_id": product_id})
            if "Item" not in check:
                return response(404, {"detail": "Inventario no encontrado"})   # no existía
            return response(409, {"detail": "La operación dejaría stock negativo"})   # existía, pero no alcanzaba
        raise   # ⚠️ diferencia real con app.py (sección 7): acá NO se loguea ni se controla,
                # se re-lanza tal cual -> Lambda devuelve un error crudo, sin el formato JSON del resto de la API


def reserve_inventory(event):
    # ⚠️ BUG REAL: a diferencia de las otras 3 funciones, ACÁ FALTA el chequeo
    # "if not product_id: return response(400, ...)" antes de seguir (Ejercicio 14/19)
    product_id = product_id_from(event)
    body, error = parse_body(event)
    if error:
        return error

    quantity = body.get("quantity")
    if (
        not isinstance(quantity, int)
        or isinstance(quantity, bool)
        or quantity <= 0   # a diferencia de delta_stock, acá NO tiene sentido un valor negativo (Ejercicio 9)
    ):
        return response(400, {"detail": "quantity debe ser mayor que cero"})

    try:
        result = table.update_item(
            Key={"product_id": product_id},
            # DOS cambios en la misma escritura atómica: resta de lo disponible, suma a lo reservado
            UpdateExpression=(
                "SET available_stock = available_stock - :q, "
                "reserved_stock = reserved_stock + :q"
            ),
            # esta condición SÍ es válida (compara directo, sin aritmética) — nunca tuvo el bug de arriba
            ConditionExpression=(
                "attribute_exists(product_id) AND available_stock >= :q"
            ),
            ExpressionAttributeValues={":q": Decimal(quantity)},
            ReturnValues="ALL_NEW",
        )
        return response(200, result["Attributes"])

    except ClientError as exc:
        if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
            check = table.get_item(Key={"product_id": product_id})
            if "Item" not in check:
                return response(404, {"detail": "Inventario no encontrado"})
            return response(409, {"detail": "Stock insuficiente"})
        raise


def lambda_handler(event, context):
    # firma fija que exige Lambda (glosario, sección 1): event = qué pasó, context = metadatos de ESTA ejecución
    route_key = event.get("routeKey", "")   # "MÉTODO /ruta" — lo arma API Gateway, no el cliente
    logger.info("request_id=%s route=%s", context.aws_request_id, route_key)   # va a CloudWatch Logs

    # dispatcher manual: una función, cinco rutas posibles — cada "if" delega a su función de negocio
    if route_key == "GET /health":
        return response(200, {
            "status": "ok",
            "service": "OrderFlow Inventory Serverless"
        })
    if route_key == "POST /inventory":
        return create_inventory(event)
    if route_key == "GET /inventory/{product_id}":
        return get_inventory(event)
    if route_key == "PATCH /inventory/{product_id}":
        return update_inventory(event)
    if route_key == "PATCH /inventory/{product_id}/reserve":
        return reserve_inventory(event)

    return response(404, {"detail": "Ruta no encontrada"})   # ninguna de las 5 rutas matcheó
🧪 9. events/*.json — simular API Gateway sin desplegar
Cada archivo de events/ es un evento con la misma forma exacta que API Gateway (HTTP API, payload format 2.0) le mandaría de verdad a la Lambda — sirve para probar lambda_handler sin necesidad de tener nada desplegado en AWS todavía:
json
// events/reserve_inventory.json
{
  "version": "2.0",
  "routeKey": "PATCH /inventory/{product_id}/reserve",
  "rawPath": "/inventory/PROD-001/reserve",
  "pathParameters": { "product_id": "PROD-001" },
  "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"quantity\": 3}"
}
Con la SAM CLI instalada (brew install aws-sam-cli en macOS), este evento se dispara así, apuntando a la función declarada en template.yaml:
bash
sam local invoke InventoryFunction --event events/reserve_inventory.json💡 Fijate que
bodyes un STRING con JSON escapado ("{\"quantity\": 3}"), no un objeto JSON anidado — así es como realmente llega el body en un evento de API Gateway (Lambda no lo parsea por vos), por esoparse_body()(sección 7) hacejson.loads(raw_body)como primer paso siempre.
🧪 Tip de entrevista: ¿qué ventaja tiene probar con
sam local invoke+ archivos de evento, en vez de desplegar a AWS cada vez que se cambia una línea? Ciclo de feedback mucho más rápido (sin esperarsam deploy, sin gastar invocaciones reales) y no depende de tener credenciales de AWS a mano para iterar sobre la lógica pura — el equivalente serverless de correr los tests antes de hacergit push.
🚀 10. Desplegar, probar y limpiar los recursos
Prerrequisito — confirmar que el AWS CLI ya está autenticado (sección 5, con las access keys del usuario IAM propio):
bash
aws sts get-caller-identityjson
{
    "UserId": "AIDAQSBZJJMB2METN5JT2",
    "Account": "038774852355",
    "Arn": "arn:aws:iam::038774852355:user/stypcanto"
}
✅ Salida real, verificada — confirma que el CLI está autenticado como el usuario IAM
stypcanto(no root) y apuntando a la cuenta propia, no a la del profesor.
Instalar el SAM CLI (distinto del aws CLI — este sabe empaquetar y desplegar template.yaml), si todavía no está:
bash
sam --version
# Si da "command not found: sam":
brew install aws-sam-cli
Compilar y desplegar:
bash
cd 02-Ejercicios/Clase-08/PYT30JUL26/S08

sam build
sam deploy --guided
requirements.txt file not found. Continuing the build without dependencies es un aviso esperable de sam build — busca ese archivo adentro de src/inventory/ (el CodeUri), pero vive un nivel arriba en S08/. No rompe nada acá: la única dependencia (boto3) ya viene preinstalada en el runtime de Lambda.
sam deploy --guided hace 14 preguntas, en este orden exacto (verificado con una corrida real) — respondé así:
| # | Pregunta | Respuesta |
|---|---|---|
| 1 | Stack Name [sam-app]: | orderflow-session8 |
| 2 | AWS Region [us-east-2]: | us-east-2 |
| 3 | Confirm changes before deploy [y/N]: | y |
| 4 | Allow SAM CLI IAM role creation [Y/n]: | y |
| 5 | Disable rollback [y/N]: | n |
| 6–10 | InventoryFunction has no authentication. Is this okay? [y/N]: — se repite 5 veces, una por cada una de las 5 rutas (/health, /inventory, /inventory/{id} GET, /inventory/{id} PATCH, /inventory/{id}/reserve) | y las 5 veces |
| 11 | Save arguments to configuration file [Y/n]: | y |
| 12 | SAM configuration file [samconfig.toml]: | Enter (default) |
| 13 | SAM configuration environment [default]: | Enter (default) |
| 14 | Deploy this changeset? [y/N]: (después de la tabla de recursos a crear) | y |
⚠️ Ojo con los pasos 6-10: si se contesta
n(o Enter vacío, que por defecto esN) en cualquiera de esas 5 repeticiones, todo el deploy aborta conError: Security Constraints Not Satisfied!— caso real documentado en 06-Errores.
📌 Región
us-east-2(Ohio), nous-east-1— para que coincida con el resto de recursos ya vistos en esta clase (la Lambda y la tabla de las capturas de la consola, sección 8) y evitar el error real ya documentado de mezclar regiones entre recursos relacionados (06-Errores).
🔎 El output real de sam deploy, explicado y correlacionado con el código
Después de las 14 preguntas, sam deploy hace 4 cosas en cadena — cada una con su propio bloque de output:
1. Crea el bucket S3 "managed" (una sola vez por cuenta/región, las próximas corridas lo reusan):
Managed S3 bucket: aws-sam-cli-managed-default-samclisourcebucket-tzsweea8bc3dAhí es donde SAM sube el .zip del código (sam build, sección 7) ANTES de que CloudFormation lo instale en la Lambda — CloudFormation no acepta código "adjunto" directo en el request, necesita que ya esté en S3.
2. Guarda samconfig.toml con todo lo respondido (Stack Name, Region, etc.) — por eso, de acá en adelante, alcanza con sam deploy a secas (sin --guided) para repetir el mismo deploy sin contestar las 14 preguntas de nuevo.
3. Arma el "changeset" — el diff real entre lo que existe y lo que se va a crear. Esta tabla es la más importante para entender: son 10 recursos reales de AWS, generados enteros a partir del template.yaml (sección 6) — ni uno se creó a mano:
LogicalResourceId (del changeset) | ResourceType (AWS real) | De dónde sale en template.yaml |
|---|---|---|
InventoryTable | AWS::DynamoDB::Table | El bloque InventoryTable: completo (sección 6) |
InventoryFunction | AWS::Lambda::Function | El bloque InventoryFunction: (CodeUri, Handler, sección 6/7) |
InventoryFunctionRole | AWS::IAM::Role | Generado por Policies: DynamoDBCrudPolicy (sección 4/6) — el rol que la Lambda asume para hablarle a DynamoDB |
InventoryApi | AWS::ApiGatewayV2::Api | El bloque InventoryApi: (AWS::Serverless::HttpApi, sección 6) |
InventoryApiApiGatewayDefaultStage | AWS::ApiGatewayV2::Stage | StageName: $default dentro de InventoryApi |
InventoryFunctionHealthPermission | AWS::Lambda::Permission | El evento Health: (sección 6) — permiso que deja a esa ruta puntual invocar la Lambda |
InventoryFunctionCreateInventoryPermission | AWS::Lambda::Permission | El evento CreateInventory: |
InventoryFunctionGetInventoryPermission | AWS::Lambda::Permission | El evento GetInventory: |
InventoryFunctionUpdateInventoryPermission | AWS::Lambda::Permission | El evento UpdateInventory: |
InventoryFunctionReserveInventoryPermission | AWS::Lambda::Permission | El evento ReserveInventory: |
💡 Por qué hay 5
AWS::Lambda::Permissiondistintos, uno por ruta (y no uno solo para toda la API): cada permiso es la respuesta a "¿quién tiene permitido invocar esta Lambda?" — y acá, la respuesta es "API Gateway, pero SOLO para disparar desde esta ruta puntual". Son estos 5 permisos, generados automáticamente por cada bloqueEvents:deltemplate.yaml, los que de fondo generaron las 5 preguntas de seguridad ("has no authentication") de la tabla de arriba — SAM las detectó ANTES de crearlos, uno por cada permiso que iba a generar.
4. Crea los recursos de verdad, con eventos en tiempo real (CREATE_IN_PROGRESS → CREATE_COMPLETE por cada uno):
CREATE_IN_PROGRESS   AWS::DynamoDB::Table   InventoryTable   -
CREATE_COMPLETE       AWS::DynamoDB::Table   InventoryTable   -
CREATE_IN_PROGRESS   AWS::IAM::Role         InventoryFunctionRole   -
CloudFormation no crea los 10 recursos en paralelo sin criterio — respeta dependencias: acá InventoryTable termina primero porque nada más depende de ella; InventoryFunctionRole (el rol IAM) tiene que existir ANTES que InventoryFunction (la Lambda necesita el rol ya creado para poder asumirlo), y InventoryFunction a su vez tiene que existir antes que los 5 AWS::Lambda::Permission (no se puede dar permiso sobre algo que no existe todavía). El orden real del log sigue ese grafo de dependencias, no el orden en que aparecen escritos en el YAML.
sam deploy termina imprimiendo el ApiUrl (el Output del template.yaml, sección 6) — con esa URL real, los 5 endpoints se prueban así:
| Método y ruta | Body de ejemplo | Código esperado |
|---|---|---|
GET /health | — | 200 — {"status": "ok", ...} |
POST /inventory | {"product_id": "PROD-001", "product_name": "Laptop empresarial", "available_stock": 20} | 201 con el item creado |
POST /inventory (mismo product_id de nuevo) | igual que arriba | 409 — "El inventario del producto ya existe" |
GET /inventory/PROD-001 | — | 200 con el item |
GET /inventory/NO-EXISTE | — | 404 — "Inventario no encontrado" |
PATCH /inventory/PROD-001 | {"delta_stock": -4} | 200 — available_stock: 16 |
PATCH /inventory/PROD-001 | {"delta_stock": -9999} | 409 — "La operación dejaría stock negativo" |
PATCH /inventory/PROD-001/reserve | {"quantity": 3} | 200 — available_stock: 13, reserved_stock: 3 |
PATCH /inventory/PROD-001/reserve | {"quantity": 999} | 409 — "Stock insuficiente para reservar" |
✅ Toda esta tabla está verificada de punta a punta contra una tabla DynamoDB real (simulada con
moto, la misma herramienta que se usó para encontrar y confirmar el bug de la sección 3) — no son valores inventados, son la salida real de correrlambda_handlercon cada evento.
Con curl, apuntando a la URL real que devolvió sam deploy:
bash
curl -s -X POST "$API_URL/inventory" \
  -H "Content-Type: application/json" \
  -d '{"product_id": "PROD-001", "product_name": "Laptop empresarial", "available_stock": 20}'

curl -s -X PATCH "$API_URL/inventory/PROD-001/reserve" \
  -H "Content-Type: application/json" \
  -d '{"quantity": 3}'
Limpiar todo al terminar (borra el stack completo: API Gateway, Lambda, tabla DynamoDB y el rol IAM que SAM creó):
bash
sam delete --stack-name orderflow-session8⚠️
sam deleteborra la tabla DynamoDB junto con todo lo demás — cualquier dato cargado durante la práctica se pierde. Para un servicio real, la tabla se declararía con una política de retención (DeletionPolicy: Retain) si se quisiera conservarla más allá del ciclo de vida del stack.
🏋️ 11. EJERCICIOS CON SOLUCIÓN
Todos los ejercicios usan
sam local invokecon un archivo de evento (los 4 deevents/como base, más los que arme cada ejercicio) — así se practica sin necesitar una cuenta de AWS activa. Si tenéssam deploycorrido, cualquier ejercicio también puede probarse concurl/Postman contra la URL real.
Ejercicio 1 — Correr los 4 eventos ya armados, en orden
Ejecutá, en este orden, sam local invoke InventoryFunction --event events/post_inventory.json, después get_inventory.json, después patch_inventory.json, y por último reserve_inventory.json.
🎯 Qué deberías lograr: 4 respuestas en cadena — 201, 200 (con available_stock: 20), 200 (con available_stock: 16, tras delta_stock: -4) y 200 (con available_stock: 13, reserved_stock: 3, tras quantity: 3).
💡 ¿Sabías que…? — por qué el orden importa acá
Cada evento opera sobre el MISMO product_id (PROD-001) y cada operación depende del estado que dejó la anterior — get_inventory fallaría con 404 si se corriera antes que post_inventory, y patch_inventory/reserve_inventory acumulan sobre el available_stock que dejó el paso previo. Es el mismo tipo de dependencia de estado que ya se vio al migrar con Alembic en la Clase 4: un paso fuera de orden rompe la cadena.
bash
# ejemplo de referencia — mismo patrón, otra tabla/evento
sam local invoke MiFuncion --event events/paso_1.json
sam local invoke MiFuncion --event events/paso_2.json
Ver solución
bash
sam local invoke InventoryFunction --event events/post_inventory.json
sam local invoke InventoryFunction --event events/get_inventory.json
sam local invoke InventoryFunction --event events/patch_inventory.json
sam local invoke InventoryFunction --event events/reserve_inventory.json
Ejercicio 2 — Crear tu propio producto, con otro product_id
Copiá events/post_inventory.json a events/post_mi_producto.json y cambiá product_id, product_name y available_stock por datos propios.
🎯 Qué deberías lograr: 201 Created con tu item, y reserved_stock: 0 puesto automáticamente (no lo mandaste vos en el body).
💡 ¿Sabías que…? — por qué `reserved_stock` no viene del body
create_inventory (sección 7) arma el item a mano en el código: "reserved_stock": 0 está hardcodeado, no leído de body.get(...) — así ningún cliente puede crear un producto que "ya nazca" con unidades reservadas.
python
# ejemplo de referencia — mismo patrón, otro campo forzado en el server
item = {
    "sku": sku,
    "price": price,
    "status": "draft",   # el cliente nunca puede mandar otro status al crear
}
Ver solución
json
{
  "version": "2.0",
  "routeKey": "POST /inventory",
  "rawPath": "/inventory",
  "requestContext": { "http": { "method": "POST" } },
  "body": "{\"product_id\": \"PROD-099\", \"product_name\": \"Mouse inalámbrico\", \"available_stock\": 50}"
}
bash
sam local invoke InventoryFunction --event events/post_mi_producto.jsonEjercicio 3 — Provocar el 409 de crear un duplicado
Corré events/post_inventory.json DOS veces seguidas, sin tocar nada en el medio.
🎯 Qué deberías lograr: la primera vez 201, la segunda 409 con "detail": "El inventario del producto ya existe".
💡 ¿Sabías que…? — qué condición del código dispara este 409
ConditionExpression="attribute_not_exists(product_id)" (sección 3) es la que falla la segunda vez — el item ya existe, así que la condición es falsa y DynamoDB rechaza el PutItem completo, sin pisar el item original.
python
# ejemplo de referencia — misma idea con otra tabla
table.put_item(Item=item, ConditionExpression="attribute_not_exists(sku)")
Ver solución
bash
sam local invoke InventoryFunction --event events/post_inventory.json   # 201
sam local invoke InventoryFunction --event events/post_inventory.json   # 409
Ejercicio 4 — Consultar un producto que nunca existió
Copiá events/get_inventory.json, cambiá pathParameters.product_id y rawPath a un id que nunca creaste (ej. PROD-404).
🎯 Qué deberías lograr: 404 con "detail": "Inventario no encontrado" — distinto del 500 que daría un error real de DynamoDB.
💡 ¿Sabías que…? — por qué "no encontrado" es 404 y no 500
get_inventory (sección 7) hace result.get("Item") y devuelve 404 si es None — un Item ausente en DynamoDB no es un error de la base de datos (la consulta funcionó perfecto, simplemente no hay nada con esa clave), así que no cae en el except ClientError.
python
# ejemplo de referencia
result = table.get_item(Key={"id": "algo-que-no-existe"})
item = result.get("Item")  # None, sin excepción
Ver solución
json
{
  "version": "2.0",
  "routeKey": "GET /inventory/{product_id}",
  "rawPath": "/inventory/PROD-404",
  "pathParameters": { "product_id": "PROD-404" },
  "requestContext": { "http": { "method": "GET" } }
}
Ejercicio 5 — Sumar stock (reposición), no solo restar
Armá un evento de PATCH /inventory/{product_id} con delta_stock positivo (ej. 10) sobre PROD-001.
🎯 Qué deberías lograr: 200 con available_stock mayor al que tenía antes — confirmá que la condición corregida (sección 3) también deja pasar sumas sin problema.
💡 ¿Sabías que…? — por qué sumar nunca da 409
Con delta_stock positivo, :min_needed queda en Decimal(0) (rama else de la sección 3) — y available_stock nunca es negativo en la base, así que available_stock >= 0 siempre es verdadero. La condición solo puede fallar cuando delta_stock es negativo y superaría el stock disponible.
Ver solución
json
{ "version": "2.0", "routeKey": "PATCH /inventory/{product_id}", "rawPath": "/inventory/PROD-001",
  "pathParameters": { "product_id": "PROD-001" }, "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"delta_stock\": 10}" }
Ejercicio 6 — Provocar el 400 de delta_stock inválido
Armá un evento de PATCH /inventory/{product_id} con "delta_stock": 0.
🎯 Qué deberías lograr: 400 con "detail": "delta_stock debe ser diferente de cero" — sin llegar siquiera a tocar DynamoDB.
💡 ¿Sabías que…? — por qué se valida ANTES de llamar a DynamoDB
update_inventory (sección 7) corta con return api_response(400, ...) apenas detecta delta_stock == 0, antes del try/table.update_item(...). Validar en Python antes de gastar una llamada a la base es más barato (y más rápido) que dejar que DynamoDB la rechace.
python
# ejemplo de referencia
if cantidad == 0:
    return api_response(400, {"detail": "cantidad no puede ser cero"})
# recién acá se llama a la base
Ver solución
json
{ "version": "2.0", "routeKey": "PATCH /inventory/{product_id}", "rawPath": "/inventory/PROD-001",
  "pathParameters": { "product_id": "PROD-001" }, "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"delta_stock\": 0}" }
Ejercicio 7 — Reservar exactamente todo el stock disponible (el límite)
Sobre un producto con available_stock: 20 (recién creado, sin reservas), armá una reserva de "quantity": 20 (exactamente todo).
🎯 Qué deberías lograr: 200, con available_stock: 0 y reserved_stock: 20 — confirmá que el límite exacto SÍ se puede reservar (la condición es >=, no >).
💡 ¿Sabías que…? — la diferencia entre `>=` y `>` en una condición límite
ConditionExpression="attribute_exists(product_id) AND available_stock >= :q" deja pasar el caso donde available_stock es EXACTAMENTE :q — reservar "todo lo que hay" es válido, solo se rechaza reservar MÁS de lo que hay.
python
# ejemplo de referencia — con > en vez de >=, el límite exacto fallaría (bug distinto)
ConditionExpression="stock > :q"   # rechazaría reservar el 100% del stock
Ver solución
json
{ "version": "2.0", "routeKey": "PATCH /inventory/{product_id}/reserve", "rawPath": "/inventory/PROD-001/reserve",
  "pathParameters": { "product_id": "PROD-001" }, "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"quantity\": 20}" }
Ejercicio 8 — Reservar 1 unidad más de la que queda (justo pasado el límite)
Con el resultado del Ejercicio 7 (available_stock: 0), armá una reserva de "quantity": 1.
🎯 Qué deberías lograr: 409 — "detail": "Stock insuficiente para reservar".
💡 ¿Sabías que…? — cómo distingue el código un 409 de un 404 acá
Cuando ConditionalCheckFailedException salta, reserve_inventory (sección 7) hace un get_item extra para diferenciar: si el Item no existe → 404; si existe pero la condición de stock falló → 409. Sin ese segundo chequeo, ambos casos devolverían el mismo código, perdiendo información útil para quien llama.
python
# ejemplo de referencia — mismo patrón de "diagnosticar después de fallar"
except ClientError as exc:
    if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
        check = table.get_item(Key={"id": item_id})
        if "Item" not in check:
            return api_response(404, {"detail": "no encontrado"})
        return api_response(409, {"detail": "condición de negocio no cumplida"})
Ver solución
json
{ "version": "2.0", "routeKey": "PATCH /inventory/{product_id}/reserve", "rawPath": "/inventory/PROD-001/reserve",
  "pathParameters": { "product_id": "PROD-001" }, "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"quantity\": 1}" }
Ejercicio 9 — quantity negativo o cero en una reserva
Armá una reserva con "quantity": -5.
🎯 Qué deberías lograr: 400 — "detail": "quantity debe ser un entero mayor que cero", sin tocar DynamoDB.
💡 ¿Sabías que…? — por qué "mayor que cero" y no solo "distinto de cero"
A diferencia de delta_stock (que sí puede ser negativo, para restar), quantity en una reserva siempre representa una cantidad a reservar — no tiene sentido "reservar -5 unidades". La validación es más estricta a propósito: quantity <= 0 rechaza CERO y NEGATIVOS de una.
python
# ejemplo de referencia
if not isinstance(cantidad, int) or cantidad <= 0:
    return api_response(400, {"detail": "cantidad debe ser mayor que cero"})
Ver solución
json
{ "version": "2.0", "routeKey": "PATCH /inventory/{product_id}/reserve", "rawPath": "/inventory/PROD-001/reserve",
  "pathParameters": { "product_id": "PROD-001" }, "requestContext": { "http": { "method": "PATCH" } },
  "body": "{\"quantity\": -5}" }
Ejercicio 10 — available_stock como texto en vez de número, al crear
Armá un POST /inventory con "available_stock": "veinte" (string, no número).
🎯 Qué deberías lograr: 400 — "detail": "available_stock debe ser un entero".
💡 ¿Sabías que…? — por qué hace falta chequear `isinstance`, y encima excluir `bool`
JSON no tiene un tipo int separado de otros números, así que create_inventory valida explícitamente isinstance(available_stock, int). El chequeo extra and not isinstance(available_stock, bool) existe porque en Python bool es subclase de int — sin esa exclusión, available_stock: true pasaría la validación como si fuera 1.
python
# ejemplo de referencia — el gotcha de bool como subclase de int
isinstance(True, int)   # True (!)
Ver solución
json
{ "version": "2.0", "routeKey": "POST /inventory", "rawPath": "/inventory",
  "requestContext": { "http": { "method": "POST" } },
  "body": "{\"product_id\": \"PROD-010\", \"product_name\": \"Teclado\", \"available_stock\": \"veinte\"}" }
Ejercicio 11 — available_stock negativo al crear
Armá un POST /inventory con "available_stock": -5.
🎯 Qué deberías lograr: 400 — "detail": "available_stock no puede ser negativo".
💡 ¿Sabías que…? — por qué esto se valida en Python y no con `ConditionExpression`
available_stock < 0 en create_inventory es una validación de negocio sobre un dato de entrada (nunca debería llegar así), distinta de las condiciones DynamoDB de la sección 3 (que protegen contra condiciones de carrera entre dos operaciones concurrentes). Un dato inválido se corta en Python, antes de gastar siquiera un PutItem.
Ver solución
json
{ "version": "2.0", "routeKey": "POST /inventory", "rawPath": "/inventory",
  "requestContext": { "http": { "method": "POST" } },
  "body": "{\"product_id\": \"PROD-011\", \"product_name\": \"Monitor\", \"available_stock\": -5}" }
Ejercicio 12 — Body que no es JSON válido
Armá cualquier evento de POST /inventory con "body": "esto no es json" (sin comillas escapadas de objeto, texto plano).
🎯 Qué deberías lograr: 400 — "detail": "El body debe contener JSON válido".
💡 ¿Sabías que…? — dónde se atrapa este error exacto
parse_body() (sección 7) envuelve json.loads(raw_body) en un try/except json.JSONDecodeError — es el ÚNICO lugar de todo el código que atrapa ese tipo de excepción, y las 3 funciones que reciben body (create_inventory, update_inventory, reserve_inventory) la reusan en vez de repetir el try cada una.
python
# ejemplo de referencia
try:
    data = json.loads(raw)
except json.JSONDecodeError:
    return api_response(400, {"detail": "JSON inválido"})
Ver solución
json
{ "version": "2.0", "routeKey": "POST /inventory", "rawPath": "/inventory",
  "requestContext": { "http": { "method": "POST" } },
  "body": "esto no es json" }
Ejercicio 13 — Body que es JSON válido pero NO es un objeto
Armá un evento de POST /inventory con "body": "[1, 2, 3]" (un array JSON válido, no un objeto {}).
🎯 Qué deberías lograr: 400 — "detail": "El body debe ser un objeto JSON" (no un error de tipo sin controlar al hacer body.get(...)).
💡 ¿Sabías que…? — por qué no alcanza con "es JSON válido"
json.loads("[1, 2, 3]") no lanza excepción — es JSON perfectamente válido, solo que es una LISTA, no un diccionario. Sin el chequeo isinstance(body, dict) en parse_body(), el siguiente body.get("product_id") reventaría con AttributeError: 'list' object has no attribute 'get', un error 500 feo en vez de un 400 claro.
Ver solución
json
{ "version": "2.0", "routeKey": "POST /inventory", "rawPath": "/inventory",
  "requestContext": { "http": { "method": "POST" } },
  "body": "[1, 2, 3]" }
Ejercicio 14 — Comparar console_lambda con src/inventory en un caso puntual
Sin ejecutar nada — leé reserve_inventory en las dos versiones (secciones 7 y 8) y anotá exactamente qué pasaría en CADA una si pathParameters viniera vacío (product_id ausente).
🎯 Qué deberías lograr: identificar que src/inventory/app.py corta con 400 ("product_id es obligatorio") ANTES de tocar DynamoDB, mientras que console_lambda/lambda_function.py sigue de largo hacia table.update_item(...) con Key={"product_id": None} — un caso real de la tabla comparativa de la sección 8.
💡 ¿Sabías que…? — por qué esto casi nunca se nota en pruebas manuales
Si siempre se prueba pasando un product_id real (como en los ejemplos de events/), este bug de console_lambda nunca se dispara — solo aparece con una ruta armada a mano, sin pathParameters, algo que un test automatizado sí cubriría sistemáticamente (ver Ejercicio 20).
Ver solución
En src/inventory/app.py::reserve_inventory (sección 7):
python
def reserve_inventory(event: dict):
    product_id = get_product_id(event)
    if not product_id:
        return api_response(400, {"detail": "product_id es obligatorio"})
    ...
→ devuelve 400 limpio.
En console_lambda/lambda_function.py::reserve_inventory (sección 8): no tiene ese if, sigue directo a parse_body y después a table.update_item(Key={"product_id": None}, ...) — DynamoDB rechazaría la clave None/vacía con un ClientError que cae en el except con raise (sin capturar ConditionalCheckFailedException), así que se propaga sin control como un error 500 genérico de Lambda.
Ejercicio 15 — Reto de código: agregar DELETE /inventory/{product_id}
template.yaml y app.py no tienen ningún endpoint para borrar un producto. Agregá el evento DeleteInventory (método DELETE) en el template, y una función delete_inventory(event) en app.py que lo maneje.
🎯 Qué deberías lograr: DELETE /inventory/PROD-001 devuelve 204 No Content (sin body) la primera vez, y 404 si se repite sobre un product_id que ya no existe — mismo criterio que DELETE /api/v1/users/{id} de la Clase 7 → pregunta 6.
💡 ¿Sabías que…? — cómo confirmar que existía ANTES de borrar
table.delete_item(...) con ConditionExpression="attribute_exists(product_id)" sigue el mismo patrón condicional que ya usan update_inventory/reserve_inventory (sección 3) — si el item no existe, la condición falla y se traduce a 404, en vez de un delete_item "silencioso" que no avisa si borró algo real o nada.
python
# ejemplo de referencia — mismo patrón con otra tabla
try:
    table.delete_item(Key={"sku": sku}, ConditionExpression="attribute_exists(sku)")
except ClientError as exc:
    if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
        return api_response(404, {"detail": "no encontrado"})
    raise
Ver solución
En template.yaml, agregar bajo Events:
yaml
        DeleteInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory/{product_id}, Method: DELETE }
En app.py:
python
def delete_inventory(event: dict):
    product_id = get_product_id(event)
    if not product_id:
        return api_response(400, {"detail": "product_id es obligatorio"})
    try:
        table.delete_item(
            Key={"product_id": product_id},
            ConditionExpression="attribute_exists(product_id)",
        )
    except ClientError as exc:
        if exc.response["Error"]["Code"] == "ConditionalCheckFailedException":
            return api_response(404, {"detail": "Inventario no encontrado"})
        logger.exception("Error DynamoDB al borrar inventario")
        return api_response(500, {"detail": "Error al borrar inventario"})
    return {"statusCode": 204, "headers": {}, "body": ""}
Y en lambda_handler:
python
    if route_key == "DELETE /inventory/{product_id}":
        return delete_inventory(event)
Ejercicio 16 — Reto de código: endpoint GET /inventory (listar todo)
Ningún endpoint actual devuelve TODOS los productos — solo uno por vez (GET /inventory/{product_id}). Agregá GET /inventory (sin id) que devuelva la lista completa con un Scan.
🎯 Qué deberías lograr: 200 con {"items": [...]}, y una lista vacía (`) si todavía no creaste ningún producto — nunca un error.
💡 ¿Sabías que…? — por qué `Scan` es la excepción, no la regla, en DynamoDB
Scan lee toda la tabla, item por item — es la operación más cara de DynamoDB (a diferencia de GetItem/Query, que usan la clave para ir directo al dato). Para una tabla de práctica está bien; en un servicio real con miles de productos, se preferiría Query sobre un índice, o paginar con ExclusiveStartKey.
python
# ejemplo de referencia
respuesta = table.scan()
items = respuesta.get("Items", [])
Ver solución
En template.yaml:
yaml
        ListInventory:
          Type: HttpApi
          Properties: { ApiId: !Ref InventoryApi, Path: /inventory, Method: GET }
En app.py:
python
def list_inventory():
    try:
        result = table.scan()
    except ClientError:
        logger.exception("Error DynamoDB al listar inventario")
        return api_response(500, {"detail": "Error al listar inventario"})
    return api_response(200, {"items": result.get("Items", [])})
Y en lambda_handler:
python
    if route_key == "GET /inventory":
        return list_inventory()
Ejercicio 17 — Reto de código: validar available_stock con un tope máximo
Agregá una regla nueva a create_inventory: si available_stock es mayor a 100000, rechazar con 400 ("available_stock supera el máximo permitido").
🎯 Qué deberías lograr: crear con available_stock: 100000 sigue dando 201 (el límite es inclusive), pero available_stock: 100001 da 400.
💡 ¿Sabías que…? — por qué agregar una validación de negocio no debería tocar DynamoDB
Igual que el resto de las validaciones de create_inventory (sección 7), esta nueva regla se agrega ANTES del try/table.put_item(...) — las reglas de negocio sobre el dato de entrada se cortan en Python, gratis, sin gastar una llamada a la base para algo que ya se sabe inválido de antemano.
Ver solución
python
    if available_stock < 0:
        return api_response(400, {"detail": "available_stock no puede ser negativo"})
    if available_stock > 100_000:
        return api_response(400, {"detail": "available_stock supera el máximo permitido"})
Ejercicio 18 — Reto de código: sam local invoke con variables de entorno propias
InventoryFunction lee TABLE_NAME de una variable de entorno (sección 6). Armá el comando de sam local invoke que sobreescriba TABLE_NAME a "MiTablaDePractica" para un evento cualquiera, sin tocar template.yaml.
🎯 Qué deberías lograr: confirmar (leyendo los logs con --debug, o agregando un logger.info(TABLE_NAME) temporal) que la Lambda usó el nombre de tabla que pasaste, no OrderFlowInventory.
💡 ¿Sabías que…? — el flag que hace esto posible
sam local invoke acepta --env-vars archivo.json (un archivo con {"InventoryFunction": {"TABLE_NAME": "..."}}) o variables sueltas con --parameter-overrides, según qué se quiera sobreescribir — útil para probar contra una tabla de práctica distinta sin editar el template real.
bash
# ejemplo de referencia — mismo flag, otro nombre de función/variable
sam local invoke MiFuncion --event evento.json \
  --env-vars '{"MiFuncion": {"OTRA_VAR": "valor-de-prueba"}}'
Ver solución
bash
echo '{"InventoryFunction": {"TABLE_NAME": "MiTablaDePractica"}}' > env.json
sam local invoke InventoryFunction --event events/get_inventory.json --env-vars env.json
Ejercicio 19 — Reto de código: corregir console_lambda con lo aprendido
Aplicá a console_lambda/lambda_function.py las DOS correcciones que ya se documentaron en esta clase: el bug de ConditionExpression con aritmética (sección 3) y la validación faltante de product_id en reserve_inventory (sección 8, Ejercicio 14).
🎯 Qué deberías lograr: después del cambio, las dos versiones (src/inventory y console_lambda) se comportan IGUAL ante los mismos casos de prueba — corré de nuevo los Ejercicios 6 y 14 contra console_lambda (con un runner de prueba propio, sin sam local invoke, que no apunta a esa carpeta) y confirmá que ya no hay diferencia.
💡 ¿Sabías que…? — por qué esto es un ejercicio de "sincronizar", no de "reinventar"
Es la misma corrección exacta que ya se aplicó en src/inventory/app.py (sección 3) — el ejercicio es notar que un bug corregido en un lugar no se corrige solo en su copia. Repetir manualmente cambios entre dos copias del mismo código es justo el problema que resuelve tener una sola fuente de verdad versionada (la reflexión de la sección 8).
Ver solución
python
def reserve_inventory(event):
    product_id = product_id_from(event)
    if not product_id:                                   # ← agregado
        return response(400, {"detail": "product_id es obligatorio"})   # ← agregado
    body, error = parse_body(event)
    if error:
        return error
    ...
python
        result = table.update_item(
            Key={"product_id": product_id},
            UpdateExpression="SET available_stock = available_stock + :d",
            ConditionExpression=(
                "attribute_exists(product_id) AND "
                "available_stock >= :min_needed"          # ← corregido (sin "+ :d")
            ),
            ExpressionAttributeValues={
                ":d": Decimal(delta),
                ":min_needed": Decimal(-delta) if delta < 0 else Decimal(0),   # ← corregido
            },
            ReturnValues="ALL_NEW",
        )
Ejercicio 20 — Reto final: primer test automatizado con pytest + moto
requirements-dev.txt ya tiene pytest, pero no existe ninguna carpeta tests/ todavía. Escribí tests/test_inventory.py con al menos un test que cree una tabla DynamoDB simulada (con la librería moto, agregándola a requirements-dev.txt), llame a create_inventory y confirme el statusCode.
🎯 Qué deberías lograr: pytest corre y pasa en verde, SIN necesitar credenciales de AWS reales ni conexión a internet — toda la prueba corre contra la tabla simulada en memoria.
💡 ¿Sabías que…? — por qué `moto` hace falta y no alcanza con mockear boto3 a mano
moto intercepta las llamadas HTTP que boto3 le haría de verdad a AWS y las responde con una implementación en memoria que se comporta como el servicio real (incluidas las ConditionExpression) — así el mismo código de producción (app.py) corre sin cambios contra una base de prueba, en vez de tener que mockear cada método de boto3 uno por uno.
python
# ejemplo de referencia — mismo patrón con otra tabla/entidad
import boto3
from moto import mock_aws

@mock_aws
def test_crear_producto():
    ddb = boto3.client("dynamodb", region_name="us-east-1")
    ddb.create_table(
        TableName="Productos",
        AttributeDefinitions=[{"AttributeName": "sku", "AttributeType": "S"}],
        KeySchema=[{"AttributeName": "sku", "KeyType": "HASH"}],
        BillingMode="PAY_PER_REQUEST",
    )
    # ... importar el módulo bajo prueba DESPUÉS de crear la tabla, y probar
Ver solución
python
# tests/test_inventory.py
import json
import os

os.environ["TABLE_NAME"] = "OrderFlowInventory"
os.environ["AWS_DEFAULT_REGION"] = "us-east-1"

import boto3
from moto import mock_aws


@mock_aws
def test_create_inventory_devuelve_201():
    ddb = boto3.client("dynamodb", region_name="us-east-1")
    ddb.create_table(
        TableName="OrderFlowInventory",
        AttributeDefinitions=[{"AttributeName": "product_id", "AttributeType": "S"}],
        KeySchema=[{"AttributeName": "product_id", "KeyType": "HASH"}],
        BillingMode="PAY_PER_REQUEST",
    )

    from src.inventory import app  # import DESPUÉS de crear la tabla

    event = {
        "routeKey": "POST /inventory",
        "body": json.dumps({
            "product_id": "PROD-TEST",
            "product_name": "Producto de prueba",
            "available_stock": 5,
        }),
    }
    response = app.lambda_handler(event, context=None)

    assert response["statusCode"] == 201
    assert json.loads(response["body"])["product_id"] == "PROD-TEST"
bash
echo "moto>=5.0,<6.0" >> requirements-dev.txt
pip install -r requirements-dev.txt
pytest tests/ -v
❓ Preguntas y respuestas (autoevaluación)
1. ¿Por qué DynamoDB no tiene un tipo float nativo, y todos los números viajan como Decimal en Python?
Para evitar los errores de redondeo binario típicos de
float(0.1 + 0.2 != 0.3en punto flotante) —Decimalrepresenta los números de forma exacta, algo importante cuando esos números son cantidades de stock o dinero. Por eso el proyecto necesita unDecimalEncoderpropio para poder serializar la respuesta a JSON estándar (que sí solo tienenumber, sin distinguirDecimal).
2. ¿Qué diferencia hay entre ConditionExpression y UpdateExpression, y por qué solo una de las dos admite aritmética (campo + :valor)?
UpdateExpressiondescribe qué escribir (por eso admite operaciones como sumar) yConditionExpressiondescribe una comparación que debe cumplirse antes de aplicar esa escritura (por eso solo acepta comparar un atributo o un valor contra otro, sin aritmética). Mezclar aritmética dentro de una condición (available_stock + :delta >= :zero) es un error de sintaxis real de DynamoDB — ver el caso completo en la sección 3.
3. Si dos peticiones de reserve_inventory llegan casi al mismo tiempo pidiendo la última unidad disponible, ¿qué evita que las dos "ganen"?
El
ConditionExpressionde la operación (available_stock >= :q) se evalúa de forma atómica junto con la escritura, adentro del mismoUpdateItem— DynamoDB garantiza que, para el mismo item, como mucho una de las dos operaciones concurrentes puede pasar la condición y aplicar el cambio; la otra recibeConditionalCheckFailedException(409).
4. ¿Por qué create_inventory usa ConditionExpression="attribute_not_exists(...)" en vez de simplemente leer primero (get_item) y decidir en Python si crear o no?
Por la misma razón que la pregunta 3: "leer y después decidir" en dos pasos separados no es atómico — entre el
get_itemy elput_itemotra petición podría colarse y crear el mismoproduct_id. La condición mueve ese chequeo adentro de la operación atómica de escritura.
5. La tabla usa BillingMode: PAY_PER_REQUEST. ¿Cuál es la alternativa, y cuándo convendría usarla en vez de esta?
La alternativa es
PROVISIONED(capacidad de lectura/escritura reservada de antemano, con un costo fijo aunque no se use toda). Conviene sobrePAY_PER_REQUESTcuando el tráfico es alto y predecible (el costo por unidad reservada resulta más barato que pagar por request cuando el volumen es grande y estable) — para tráfico bajo, esporádico o impredecible (como este proyecto de práctica),PAY_PER_REQUESTsale más barato y no exige planificar capacidad.
6. DynamoDBCrudPolicy (usada en template.yaml) le da a la Lambda más permisos que los que declara iam/dynamodb-policy.json a mano (agrega DeleteItem, Scan, Query...). ¿Contradice esto el principio de mínimo privilegio?
No necesariamente rompe el principio, pero sí es menos estricto que lo mínimo real: le da permisos que el código actual no usa (todavía). Sigue siendo mínimo privilegio en el sentido de que el
Resourcequeda acotado a UNA tabla puntual (nunca"*") — la política predefinida prioriza cobertura práctica (cubrir cualquier operación CRUD futura sin tener que reescribir la policy) sobre el mínimo absoluto. Para el mínimo real, hay que escribir la policy a mano comoiam/dynamodb-policy.json.
7. sam local invoke corre la Lambda en tu máquina con un evento de archivo, sin tocar AWS. ¿Qué SÍ queda sin probar con ese comando, que solo se confirma con un sam deploy real?
Que el ROUTING del API Gateway (HTTP API) esté bien configurado — el
routeKeyexacto que espera cadaifdelambda_handler, el mapeo de{product_id}en la URL, CORS, y que el rol IAM (DynamoDBCrudPolicy) tenga de verdad los permisos necesarios contra la tabla real.sam local invokeprueba la LÓGICA de la función; no prueba la infraestructura que la rodea.
8. Si mañana se agregara un microservicio orders que necesita leer available_stock de este servicio de inventario, ¿por qué NO debería leer la tabla OrderFlowInventory directo con su propio boto3?
Rompería el principio de "database per service" ya visto en la Clase 7 → pregunta 8: un servicio no debería depender del schema interno de la base de otro (si
Inventorycambia un atributo,ordersse rompería sin aviso). La forma correcta es queordersle pida el dato a este servicio a través de su API pública (GET /inventory/{product_id}, vía el API Gateway) — el mismo principio de acoplamiento por contrato que ya se vio conhttpxen la Clase 7, aplicado acá con un cliente HTTP contra el HTTP API en vez de FastAPI directo.
9. console_lambda/lambda_function.py y src/inventory/app.py implementan la misma lógica de negocio, pero divergieron en al menos dos bugs reales. ¿Qué práctica de ingeniería, vista en clases anteriores, evita justamente este tipo de deriva?
Tener una sola fuente de verdad versionada (un repo git, con el código de
src/inventory/desplegado siempre víasam build/sam deploy) en vez de mantener una copia editable a mano en la consola de AWS — el mismo principio detrás de usar Alembic para migraciones (Clase 4) o.env.exampleversionado (Clase 7): lo que no está en el repo, con el tiempo, deja de coincidir con lo que realmente corre.
10. InventoryFunction en template.yaml no tiene declarada ninguna variable de entorno para la región de AWS (AWS_DEFAULT_REGION), y app.py hace boto3.resource("dynamodb") sin pasarle region_name. ¿Por qué igual funciona una vez desplegada?
Porque Lambda inyecta automáticamente variables de entorno propias del entorno de ejecución (incluida la región donde corre la función) — boto3, sin
region_nameexplícito, las lee solo. Esto es distinto de correr el mismo código localmente (como en la verificación de la sección 3, o ensam local invoke), donde si no hay una región configurada en el entorno, boto3 falla conNoRegionError— por eso el evento de prueba local necesitaAWS_DEFAULT_REGIONseteada a mano.
📎 Apuntes relacionados
- Clase 7 — API Gateway Pattern: mismo concepto de "puerta de entrada única" que acá provee Amazon API Gateway en vez de un FastAPI propio.
- Clase 7 → pregunta 8 — Database per service: mismo principio de acoplamiento por contrato, aplicado acá a un futuro
orders_serviceconsumiendo este inventario serverless. - Error:
ConditionExpressionno admite aritmética - Error: región incorrecta en el ARN de la policy IAM
- Error:
sam deploy— Security Constraints Not Satisfied (5 confirmaciones de autenticación)